
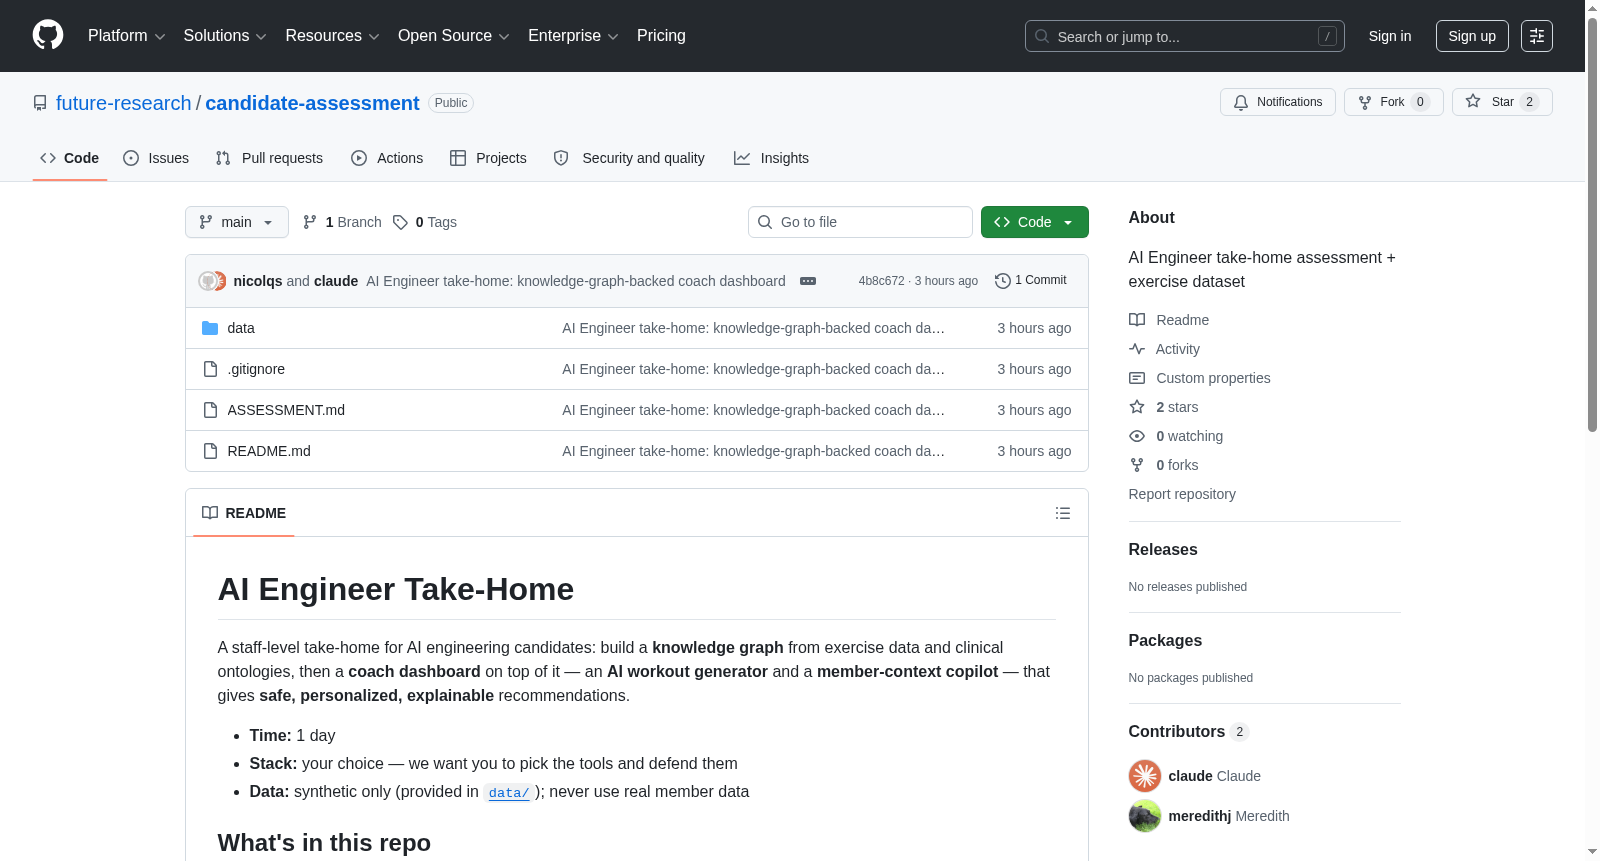
AI Engineer take-home assessment + exercise dataset
收藏官方服务:
资源简介:
该仓库包含一个用于AI工程师评估的数据集,包括练习目录和成员上下文数据。练习目录包含50个练习,成员上下文数据包括个人资料、目标、受伤情况、聊天历史、生物标志物、实验室数据(血液面板和DEXA)、依从性和流失信号。所有数据均为合成数据,仅用于评估目的。
This repository contains a dataset for AI engineer evaluation, which includes an exercise catalog and member context data. The exercise catalog consists of 50 exercises, while the member context data covers personal profiles, goals, injury records, chat histories, biomarkers, laboratory data (blood panels and DEXA scans), compliance metrics, and churn signals. All data in this dataset is synthetic and is intended solely for evaluation purposes.
创建时间:
2026-06-03
原始信息汇总
数据集概述
该仓库(candidate-assessment)是一个为AI工程候选人设计的技术评估项目,要求基于提供的合成数据构建一个知识图谱和教练仪表盘。
数据内容
包含位于 data/ 目录下的两个合成数据集文件:
exercises.json:包含50个健身动作的目录。member-context.json:一个模拟会员的详细数据,涵盖:- 个人信息与目标
- 伤病史
- 聊天历史
- 生物标志物和实验室检验报告(包括血检和DEXA扫描)
- 运动依从性数据
- 流失风险信号
核心用途
候选者需基于上述数据构建一个教练仪表盘,集成以下两个核心功能:
- Workout Generator(运动生成器):根据用户输入(如提示词和时间)调用智能体,结合基于临床本体(如OPE、COPPER、SNOMED CT)的知识图谱,生成安全、个性化且可解释的运动计划。
- AI Copilot(AI副驾驶):聊天式界面,通过检索会员背景知识图谱,提供关于依从性、睡眠、流失风险等方面的决策支持。
关键限制
- 仅使用提供的合成数据,严禁使用真实会员数据。
- 技术栈由候选人自行选择,并需在提交材料中论证理由。
搜集汇总
数据集介绍
构建方式
该数据集专为AI工程师的带回家评估练习设计,旨在构建一个融合运动科学与临床本体论的知识图谱。数据集以合成数据形式提供,包含两个核心JSON文件:`exercises.json`收录了50个标准训练动作的目录,`member-context.json`则塑造了一位虚拟会员的丰富画像,涵盖个人档案、健身目标、运动损伤史、聊天记录、生物标志物、实验室检测结果(如血检与DEXA扫描)、运动依从性及流失信号等维度。这些结构化数据为构建可解释的个性化推荐系统奠定了基础。
使用方法
使用该数据集需在1天内完成一个教练仪表盘的两大功能模块:通过提示与时间表单驱动智能体运行时,基于运动/临床知识图谱生成结构化的个性化训练方案;以及构建一个具备会员上下文检索能力的AI助手面板,支持依从性趋势、睡眠、流失风险及历史对话等信息的交互式查询。建议将成果部署至GitHub仓库,并在README中详细阐述架构设计、技术选型依据、本地运行步骤、AI使用方式及权衡决策,全程仅限合成数据,严禁使用真实用户信息。
背景与挑战
背景概述
在人工智能与健康管理深度融合的浪潮中,个性化运动推荐系统成为精准健康干预的核心技术载体。然而,现有方案多依赖简单的规则引擎或协同过滤,难以兼顾医学安全性与运动科学性。为此,该数据集于2024年由一家专注于AI健康教练的研发团队创建,旨在解决从结构化运动知识图谱到个体化教练仪表盘的端到端构建难题。其核心研究问题在于如何融合OPE、SNOMED CT等临床本体与运动本体,在50个合成运动项目与一个富含生物标志物、病史及行为日志的虚拟成员数据基础上,实现具有损伤感知、设备感知与可解释性的智能工作流。该数据集因首次将临床本体推理与成员上下文图谱推理整合于同一个AI教练原型中,为可解释的个性化运动推荐系统提供了有价值的基准测试平台,并引发业界对合成数据在医疗健康预研中应用规范的探讨。
当前挑战
该数据集面临的挑战涵盖领域难题与构建瓶颈两个维度。在领域层面,如何将OPE、COPPER等运动本体与SNOMED CT、PROV-O等临床本体进行语义对齐,以生成既能规避损伤风险又能适应个体设备条件的运动方案,是推理可解释性的核心障碍;同时,成员上下文图谱需融合依从性趋势、睡眠模式、流失风险及实验室标志物等多模态异质数据,对知识表示与动态推理提出了严峻考验。在构建过程中,仅使用50个合成运动项目与单一虚拟成员数据,虽保障了隐私合规,却限制了模型对真实世界中复杂人群异质性(如慢性病共病、特殊禁忌症)的泛化能力。此外,如何在不使用真实用户数据的前提下,模拟出具备临床真实感的生物标志物与行为日志变动模式,以避免合成数据泄露偏误或过度简化病理规律,也是数据工程层面的一项重大技术挑战。
常用场景
经典使用场景
该数据集在AI工程师招聘场景中扮演着核心评估工具的角色,常用于构建基于知识图谱的智能教练面板。具体而言,它通过提供50项合成运动数据与一个包含个人档案、目标、损伤历史、聊天记录及生物标志物的丰富合成成员上下文,驱动两个核心功能:一是基于运动/临床知识图谱的锻炼生成器,能够实时推理出安全、个性化且可解释的训练方案;二是成员上下文的AI助手,可检索依从性趋势、睡眠数据、流失风险等信息。这一设计使候选人在限定时间内展示其构建可解释、安全健身推荐系统的技术能力。
解决学术问题
该数据集主要解决了运动科学与临床知识整合中的关键学术难题,即如何在保证安全性的前提下实现个性化推荐的可解释性。通过将OPE、COPPER、SNOMED CT等本体论与运动数据结合,它首次为知识图谱驱动的健身推荐提供了标准化评估基准。研究者可以借此验证运动损伤规避算法、上下文感知推理模型以及可解释AI框架的有效性,填补了该领域缺乏真实合成测试数据的空白。其意义在于推动了人机协作健身指导的理论发展,并建立了可复现的学术评价范式。
实际应用
在实际应用中,该数据集能够支撑智能健身平台的产品化落地,例如开发面向私人教练的辅助决策系统或面向健身爱好者的智能训练助手。通过分析合成成员的生物标志物如血检和DEXA扫描数据,系统可自动调整训练强度以避免损伤;基于聊天历史与依从性数据,还能预判用户流失风险并生成个性化干预策略。此外,数据集的合成特性使其可直接用于医疗康复机构的动作推荐、企业健康管理平台的个性化方案生成,而无需担忧隐私合规问题。
数据集最近研究
最新研究方向
该数据集聚焦于将知识图谱与临床本体(如SNOMED CT、OPP等)深度融合,驱动具备可解释性的AI教练系统,代表了智能健身领域的前沿方向。研究热点包括基于本体推理的运动损伤感知推荐、成员上下文感知的共情对话系统,以及通过多模态数据(生物标志物、依从性、睡眠)实现个性化动态训练计划生成。这一方向契合了当前生成式AI与结构化知识在健康领域落地的浪潮,尤其在后疫情时代居家健身与数字健康需求激增的背景下,为构建安全、合规且可干预的用户决策支持系统提供了关键基础设施,具有显著的产业转化价值与临床应用潜力。
以上内容由遇见数据集搜集并总结生成


