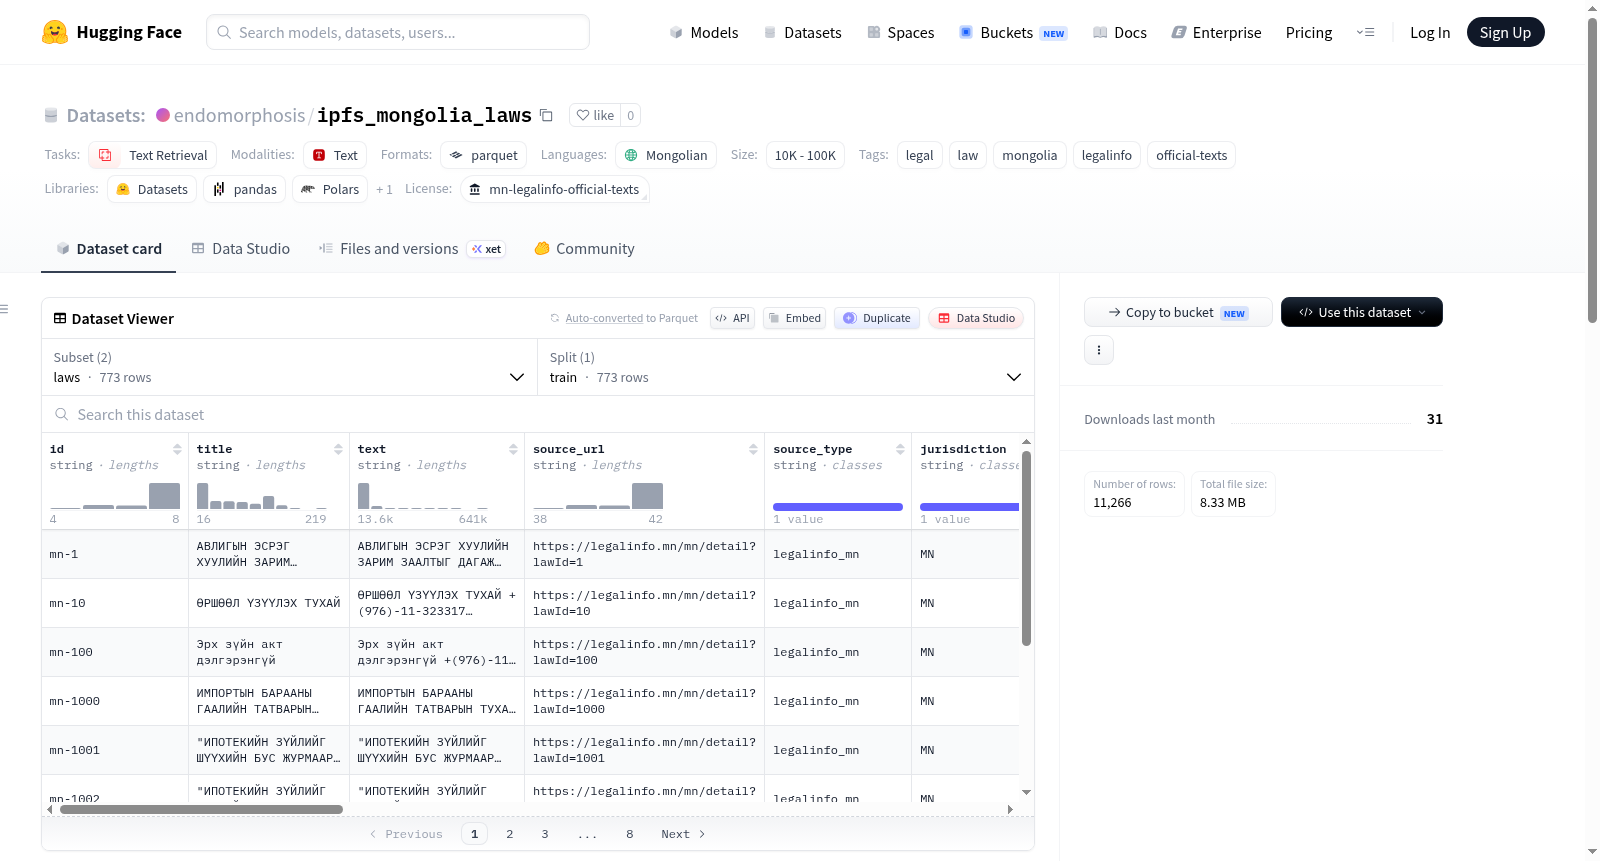
ipfs_mongolia_laws
收藏资源简介:
该数据集是蒙古国法律信息(legalinfo.mn / 统一法律信息系统)的研究快照,由蒙古国司法部/统一法律信息系统提供。数据集收录了截至2026年9月9日的官方国家立法文本,包含773项法律/法规(laws)和10,493个条款/章节(articles),全部为蒙古语。数据以Parquet格式存储,分为两个配置:laws(每行一项法律/法规)和 articles(每行一个条款/章节)。该数据集适用于文本检索任务,尤其适合蒙古国法律文本的检索、分析与研究。注意:本数据集非法律建议,官方公报/权威来源应优先于本语料库。
This dataset is a research snapshot of Mongolian legal information (legalinfo.mn / Unified Legal Information System), provided by the Ministry of Justice of Mongolia / Unified Legal Information System. It contains official national legislative texts as of September 9, 2026, including 773 laws/regulations and 10,493 articles/chapters, all in Mongolian. The data is stored in Parquet format with two configurations: laws (one law/regulation per row) and articles (one article/chapter per row). This dataset is suitable for text retrieval tasks, especially for the retrieval, analysis, and research of Mongolian legal texts. Note: This dataset does not constitute legal advice; official gazettes/authoritative sources should take precedence over this corpus.
数据集概述:蒙古国法律数据(legalinfo.mn / 统一法律信息系统)
该数据集是一个研究性快照,收录了来自蒙古国司法部统一法律信息系统(Legalinfo.mn)的官方国家立法文本。数据集以蒙古语(mn)提供,涵盖蒙古国司法管辖区的法律文书和条款。
基本信息
| 项目 | 详情 |
|---|---|
| 数据集名称 | Mongolia Laws (legalinfo.mn / Unified Legal Information System) |
| 语言 | 蒙古语(mn) |
| 司法辖区 | 蒙古国 |
| 数据来源 | Legalinfo.mn(司法部 / 统一法律信息系统) |
| 授权许可 | mn-legalinfo-official-texts(其他) |
| 任务类别 | 文本检索(text-retrieval) |
| 标签 | 法律、蒙古国、法律信息、官方文本 |
| 数据规模 | 10K < n < 100K |
快照详情
| 字段 | 值 |
|---|---|
| 快照日期 | 2026-09-09 |
| 覆盖范围 | legalinfo-laws-batch |
| 采集工具 | scrapers/collect_mn.py |
| 法律/文书数量 | 773 |
| 条款数量 | 10,493 |
内容与结构
该数据集包含两个数据子集配置:
- laws(法律):数据文件为
data/laws.parquet,每一行对应一份法律文书/工具。该配置为默认配置。 - articles(条款):数据文件为
data/articles.parquet,包含同一快照中法律文书下的条款/章节行数据。
数据集中还包含采集器脚本 scrapers/collect_mn.py,用于构建此快照。
使用与许可说明
- 数据集提供的是官方法律文本的研究性快照,不构成法律建议。
- 当数据集内容与官方公报或权威来源存在差异时,以官方来源为准。
- 已知局限:数据采集基于 Legalinfo.mn 的 HTML 详情页及官方链接的 CDX PDF 文件。
来源
- 原始数据来源网站:https://legalinfo.mn/