
遇见数据集

synthetic-seismic-vlm

收藏
Hugging Face2026-06-28 更新2026-06-29 收录
官方服务:

资源简介:

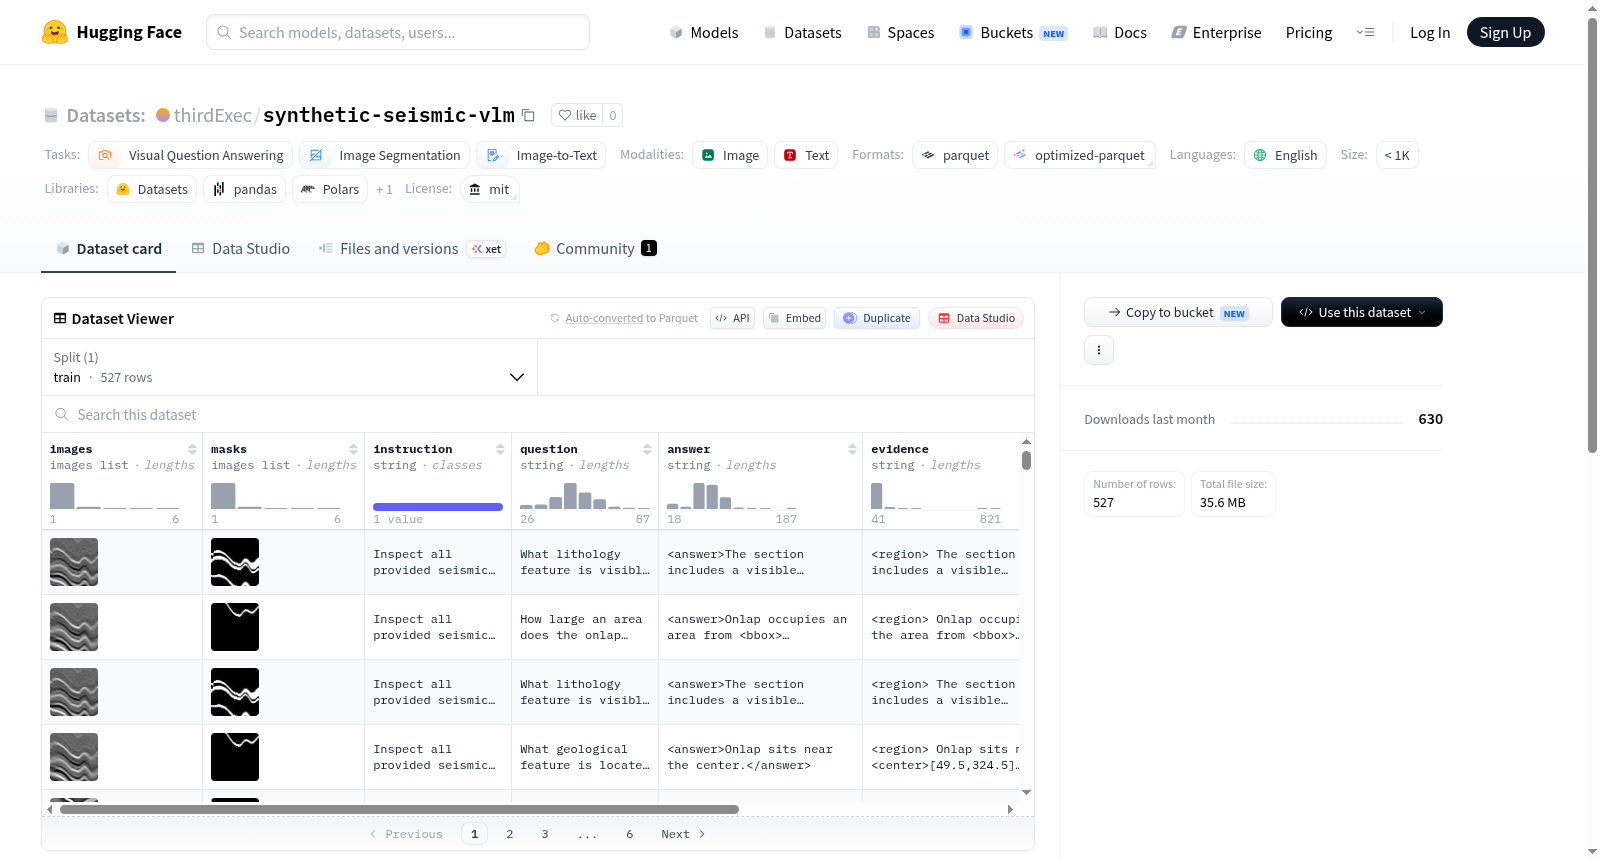
Synthetic Seismic VLM是一个合成地震多模态问答数据集,专为视觉问答、图像分割和图像到文本等任务设计。数据集包含1行数据,每行数据由多个字段构成,具体包括:原始地震图像序列(images)、分割掩码图像序列(masks)、任务指令(instruction)、问题文本(question)、可选的推理或描述文本(reason)、答案文本(answer)、支持性文本证据的JSON字符串(evidence)以及包含边界框、类别、颜色等区域元数据的JSON字符串(regions)。该数据集旨在提供证据基础的多模态问答样本,适用于地震图像分析、视觉语言模型训练等相关研究与应用场景。数据集语言为英语,规模属于小样本类别(n<1K),采用MIT许可证。

Synthetic Seismic VLM is a synthetic seismic multimodal question-answering dataset specifically designed for tasks including visual question answering, image segmentation, and image-to-text. The dataset contains 1 row of data, with each row consisting of multiple fields: original seismic image sequences (images), segmented mask image sequences (masks), task instruction (instruction), question text (question), optional reasoning or descriptive text (reason), answer text (answer), JSON string of supporting textual evidence (evidence), and JSON string containing regional metadata such as bounding boxes, categories, and colors (regions). This dataset aims to provide evidence-based multimodal question-answering samples, applicable to research and application scenarios such as seismic image analysis, visual language model training and other related fields. The dataset uses English, has a small sample size (n < 1000), and is released under the MIT License.

创建时间:
2026-06-19
原始信息汇总

数据集概述:Synthetic Seismic VLM

  • 许可证:MIT
  • 任务类别:视觉问答、图像分割、图像到文本
  • 语言:英语
  • 数据规模:少于1,000条(共527条)

数据内容

该数据集包含合成地震多模态问答样本,具体包括:

  • 原始地震图像 (images)
  • 分割掩码图像 (masks)
  • 任务指令 (instruction)
  • 问题文本 (question)
  • 可选推理/描述文本 (reason)
  • 答案文本 (answer)
  • 支持文本证据 (evidence):JSON字符串格式
  • 区域元数据 (regions):JSON字符串格式,包含边界框、类别、颜色信息

仓库地址

https://huggingface.co/datasets/thirdExec/synthetic-seismic-vlm
搜集汇总
数据集介绍
synthetic-seismic-vlm 数据集图片
构建方式
该数据集基于合成地震数据构建,整合了原始地震图像、分割掩码以及基于证据的问题-答案对。数据生成过程中,首先从地震剖面中提取原始图像,并为其生成对应的语义分割掩码,以标注地下结构区域。随后,依据这些区域元数据(包括边界框、类别与颜色信息),设计并生成了与之紧密关联的多模态问答对,每个问答对均附带支撑性的文本证据。最终,所有数据被组织为包含图像序列、掩码序列、指令、问题、推理、答案、证据及区域元数据等字段的结构化记录,共计527条样本,覆盖视觉问答与图像分割双重任务。
特点
本数据集的核心特点在于其多模态、精细化及证据驱动的设计。它同时支持视觉问答与图像分割任务,使模型能够学习从地震图像中识别结构并回答基于内容的问题。每个问答对均携带明确的文本证据(evidence)与可选推理描述(reason),增强了可解释性与训练监督的丰富度。此外,区域元数据以JSON格式存储,记录了每个掩码区域的边界框、类别与颜色信息,便于细粒度分析与评估。合成数据的特性使得标注一致性高,且避免了真实地震数据中常见的隐私与版权问题,为地震解释领域的视觉语言模型研究提供了标准化的基准资源。
使用方法
该数据集可直接用于多模态视觉语言模型的训练与评估,尤其适用于地震图像解释场景下的视觉问答与区域分割联合任务。使用时,用户可通过HuggingFace Datasets库加载数据,并按图像序列、掩码序列、问题与答案等字段组织输入。针对视觉问答任务,可将原始图像与问题文本作为输入,以答案文本为监督目标;针对分割任务,则利用掩码序列与区域元数据训练模型识别地下结构。还可利用证据字段作为监督信号,增强模型基于图像内容生成合理解释的能力。数据量较小(527条),建议与其他地震数据集组合使用,或通过数据增强扩展样本规模以提升模型泛化性能。
背景与挑战
背景概述
地震数据解释是地球物理学中的一个核心挑战,传统上依赖专家对地震剖面的目视判读,这一过程耗时费力且主观性强。近年来,随着大规模视觉语言模型(VLM)在跨模态理解任务中展现出的强大能力,将其引入地震解释领域以提升自动化和准确性成为新的研究热点。在此背景下,Synthetic Seismic VLM数据集由研究机构于近期创建,旨在为地震图像与文本的联合推理提供标准化的训练与评测基准。该数据集包含527个多模态问答样本,涵盖了原始地震图像、分割掩码、基于证据的问题与答案以及紧凑的区域元数据,聚焦于证据驱动的视觉问答与图像分割任务。通过构建合成但贴近真实场景的数据,该数据集为评估和推动VLM在地震科学中的应用提供了关键资源,对促进智能地震解释技术的发展具有重要影响。
当前挑战
该数据集所面临的挑战主要体现在两个层面。在领域问题层面,地震解释本身具有高度歧义性和专业依赖性,单一图像可能对应多种地质解释,VLM需具备从有限视觉线索中推理深层地质结构与流体信息的复杂能力,这远超常规图像问答任务的难度。在数据构建层面,合成数据与真实地震数据之间始终存在域差异,如何保证合成样本的物理合理性及分割掩码的精确性成为核心难题。此外,针对仅527条样本的小规模数据集,如何设计有效的证据推理机制并避免模型过拟合,同时确保生成的问答对具备真正的语义一致性而非简单的视觉匹配,亦是构建过程中的关键挑战。
常用场景
经典使用场景
在地震勘探与地质解释的交叉领域,合成地震视觉语言数据集(synthetic-seismic-vlm)被广泛应用于多模态地质问答系统的构建。该数据集融合了原始地震图像、分割掩膜以及基于证据的问答对,为视觉问答与图像描述任务提供了结构化数据支撑。研究者通常利用其527条高质量样本,训练模型从地震剖面中自动识别地质结构,并生成具有可解释性的语言回答,从而推动地震资料解释的智能化进程。
衍生相关工作
围绕synthetic-seismic-vlm数据集,已衍生出多项具有影响力的研究工作。典型代表包括基于低秩适应的地震视觉语言微调方法,通过轻量化参数调整提升模型在少量样本下的泛化能力;以及融合区域元数据与层级注意力机制的地震场景图生成算法,实现复杂地质关系的多标签识别。这些工作不仅拓展了数据集的应用边界,还推动了地球科学领域与大语言模型技术的交叉创新。
数据集最近研究
最新研究方向
合成地震数据在多模态大模型中的前沿应用正推动地球科学领域的技术革新。该数据集结合地震原始图像与分割掩码,构建了视觉问答、图像分割与图像到文本等任务的训练样本,为地震解释自动化提供了关键资源。当前研究热点聚焦于利用此类多模态数据训练视觉语言模型,以提升地震相识别、断层检测及地层解释的精准度与效率。该工作与油气勘探智能化、地质灾害预警等热点事件紧密相连,通过合成数据弥补真实标注稀缺的短板,显著降低了模型开发成本,为机器学习在地震学中的安全部署与泛化能力验证奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

