
遇见数据集

openfoodfacts/price-tag-classification

收藏
Hugging Face2026-07-07 更新2026-04-05 收录
官方服务:

资源简介:

该数据集包含从Open Prices数据库中提取的价格标签图像,每个图像标注为以下三个类别之一:invalid(ID 0,表示图像高度模糊、对象不是价格标签,或至少一半价格标签被截断)、medium-quality(ID 1,表示低到中等模糊度(价格和条形码可能可读),或价格标签部分被截断但超过一半面积可见)、high-quality(ID 2,表示非常低的模糊度)。数据集用于价格标签分类任务,支持训练和验证分割,包含图像ID、图像数据、尺寸、元数据(如图像URL、价格ID、证明ID)和标签等特征。

This dataset contains price tag images extracted from the Open Prices database. Each image is annotated as one of the following three categories: invalid (ID 0, indicating the image is highly blurry, the object is not a price tag, or at least half of the price tag is truncated), medium-quality (ID 1, indicating low to moderate blurriness as the price and barcode may be readable, or the price tag is partially truncated but more than half of its area is visible), and high-quality (ID 2, indicating extremely low blurriness). This dataset is designed for price tag classification tasks, supports training and validation for segmentation, and includes features such as image ID, image data, dimensions, metadata (e.g., image URL, price ID, certification ID) and labels.
提供机构:
openfoodfacts
搜集汇总
数据集介绍
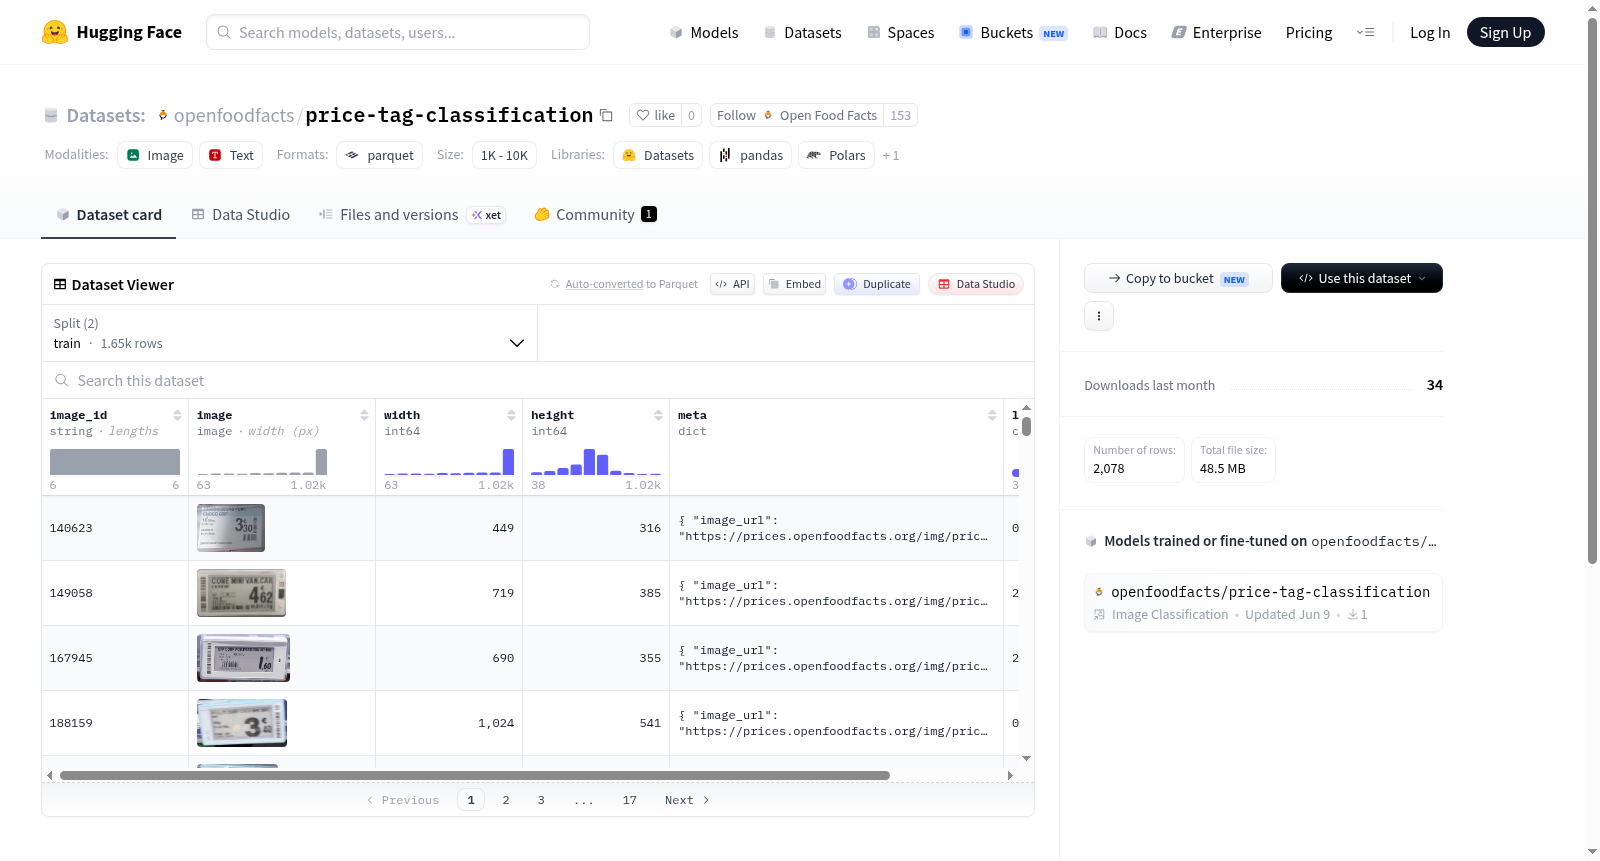
openfoodfacts/price-tag-classification 数据集图片
构建方式
该数据集源自Open Prices数据库,通过提取其中的价格标签图像构建而成。每张图像均经过人工标注,依据模糊程度和完整性划分为三类:无效(高模糊、非价格标签或截断超过一半)、中等质量(低至中等模糊,价格与条形码可识别,且可见区域超过一半)以及高质量(极低模糊)。数据集共包含2078个样本,其中训练集1647张,验证集431张,以结构化格式存储,涵盖图像标识符、尺寸、元数据及标签信息。
特点
数据集的显著特点在于其精细化的质量分级体系,将价格标签图像按模糊度和可见性划分为三个层次,适用于图像质量筛查与预处理任务。类别分布均衡,验证集占比约20.7%,支持可靠的模型评估。此外,每个样本均附带原始URL和关联标识符,便于追溯至Open Prices数据库,增强了数据的可溯源性与扩展应用价值。
使用方法
数据集可通过HuggingFace Datasets库直接加载,默认配置包含训练集和验证集两个拆分。使用时需安装datasets库,并通过load_dataset函数指定数据集名称即可获取图像数据与标签。图像以PIL格式呈现,支持直接输入计算机视觉模型。建议将验证集用于超参数调优与性能评估,训练集则用于模型拟合,适用于图像分类、质量筛选等场景。
背景与挑战
背景概述
在零售商品与消费信息数字化进程中,价格标签作为商品标识与交易凭证的关键载体,其图像质量直接关系到自动化数据采集系统的准确性与可靠性。price-tag-classification数据集由Open Prices数据库项目团队于近期创建,旨在推动价格标签图像自动分类技术的研究。该数据集从海量商品图像中筛选并标注了价格标签样本,依据清晰度与完整度将图像划分为无效、中等质量与高质量三个类别,为解决商品信息自动化录入中的图像质量判别问题提供了基础资源。其研究聚焦于提升零售数据采集流程的智能化水平,对优化商品信息库构建、加速零售业数字化转型具有重要推动作用。
当前挑战
该数据集所解决的领域核心挑战在于价格标签图像的自动质量评估与分类,这是商品信息自动化采集流程中的关键瓶颈。现实场景中,价格标签常因拍摄角度、光照条件、遮挡或运动模糊等因素呈现多样性退化,现有通用图像分类模型在此特定任务上泛化能力不足。在数据集构建过程中,团队面临从大规模未标注图像库中高效筛选价格标签样本、制定统一且可操作性强的质量标准以区分模糊与清晰边界、以及确保标注一致性的挑战。此外,数据集规模相对有限(训练集仅1647例样本),需应对小样本条件下模型训练与类别不平衡问题,这对深度学习方法在此场景下的鲁棒性提出了更高要求。
常用场景
经典使用场景
Price-tag-classification数据集作为零售与商品信息自动化领域的基础资源,其核心应用场景在于对商品价格标签图像进行质量分级。该数据集将图像分为无效、中等质量与高质量三个类别,广泛应用于训练图像质量评估模型。研究者利用此数据集构建分类器,以自动甄别模糊、截断或非标签物体的图像,筛选出清晰完整的标签用于后续的条形码识别与价格提取任务。这一经典用法奠定了智能零售系统中数据预处理环节的基石。
实际应用
在实际商业场景中,该数据集驱动的图像质量分类模型被部署于零售供应链管理系统。当消费者或工作人员通过移动设备拍摄商品标签时,模型能实时返回图像质量反馈,提示重新捕捉低质量图像,确保采集数据的有效性。此外,在大型超市或仓库的自动化盘点系统中,该模型可高效过滤无效图像,仅将符合条件的标签送入光学字符识别(OCR)引擎,从而大幅提升价格核对、库存管理及自助结账流程的准确性与运行效率,降低人工复核成本。
衍生相关工作
围绕Price-tag-classification数据集,学术界与工业界衍生出一系列代表性工作。相关研究包括将其作为基准数据集开发轻量化神经网络,以适应移动端实时推理需求;另有工作将其与条形码检测、价格文本识别模型集成,构建端到端的商品信息自动录入流水线。此外,部分团队基于该数据集的分类逻辑,拓展了更细粒度的质量评分体系,或引入跨域迁移学习技术,使模型适应不同拍摄环境与标签格式。这些衍生工作共同深化了智能零售视觉系统的技术生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

