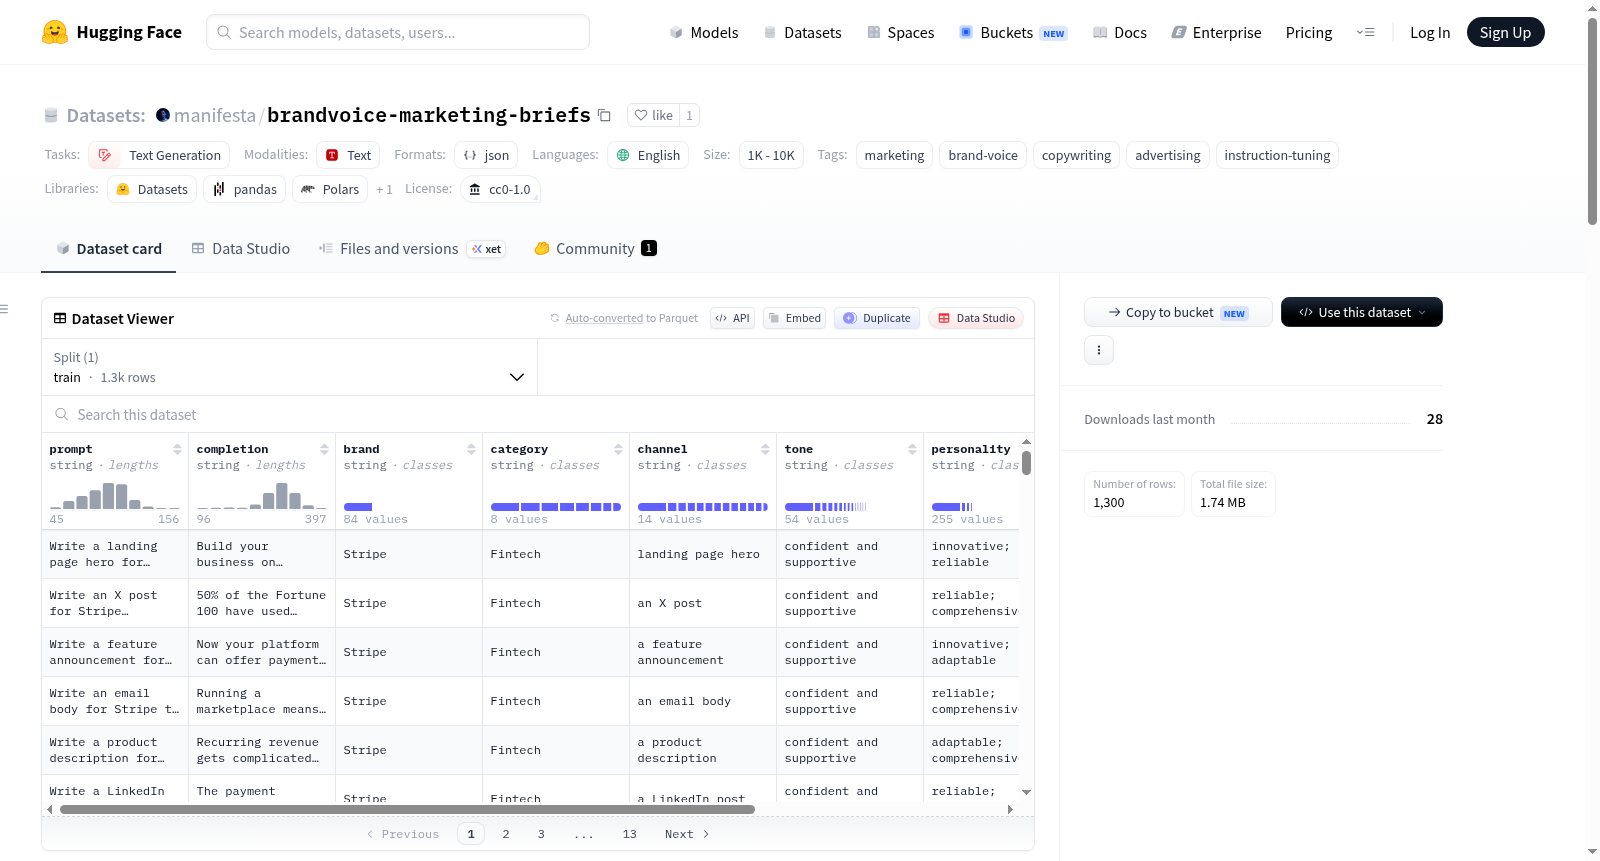
brandvoice-marketing-briefs
收藏资源简介:
BrandVoice Marketing Briefs 是一个旨在训练AI模型学习并模仿真实品牌写作风格的营销文案数据集。其核心目标是解决通用AI写作机械的问题,使其能够生成符合特定品牌声音的文案。数据集包含6,403条唯一数据行,其中6,339条是从Stripe、Liquid Death、Ramp、Duolingo等83个真实品牌的公开营销页面抓取的实际文案,另外64条是从已发表的营销说服力和文案研究中提炼出的营销原则。所有文案均无模板或填充内容。该数据集的核心创新在于v3版本为每条数据附带了完整的“品牌声纹指纹”,这是一个包含15个字段的元数据集合,用于详细描述品牌声音的特征,如品牌名称、语气、正式度、幽默感等。这使得模型不仅能学习品牌“说了什么”,更能理解品牌“听起来如何”,从而生成具有相同声音风格的新文案。数据集适用于微调大语言模型以生成品牌风格营销文案、品牌声音风格迁移、训练文案写作助手等任务,并可用于研究83个品牌跨7个不同垂直领域的真实声音差异。数据集为纯英文,采用CC0-1.0许可,可自由使用。数据收集自公开页面,并经过去重和转化处理,声纹指纹是基于真实文案的分析推断,并非品牌官方标注。数据在品牌间分布不均,且偏向于短文案格式如标题和标语。
BrandVoice Marketing Briefs is a marketing copy dataset designed to train AI models to learn and mimic the writing styles of real brands. Its core goal is to solve the problem of mechanical generic AI writing, enabling models to generate copy that conforms to specific brand voices. The dataset contains 6,403 unique data rows, among which 6,339 are actual marketing copies scraped from public marketing pages of 83 real brands including Stripe, Liquid Death, Ramp, Duolingo, etc. The remaining 64 entries are marketing principles extracted from published marketing persuasion and copywriting research. All copies contain no templates or filler content. The core innovation of this dataset lies in its v3 version, which attaches a complete "brand voice fingerprint" to each data entry. This is a metadata set consisting of 15 fields used to comprehensively describe the characteristics of brand voices, such as brand name, tone, formality, sense of humor, and so on. This allows models not only to learn what brands "say", but also to understand how brands "sound", thereby generating new copy with the same vocal style. This dataset is applicable to tasks such as fine-tuning large language models (LLMs) to generate brand-style marketing copy, brand voice style transfer, training copywriting assistants, etc. It can also be used to study the real voice differences of 83 brands across 7 different vertical sectors. The dataset is entirely in English, licensed under CC0-1.0 for free use. The data was collected from public web pages, deduplicated and transformed. The brand voice fingerprints are inferred based on analysis of real copies, rather than official brand annotations. The data distribution is uneven across different brands, and it is biased towards short copy formats such as headlines and slogans.
数据集概述:BrandVoice Marketing Dataset
- 名称: BrandVoice Marketing Dataset
- 许可证: CC0-1.0(公有领域,可自由使用)
- 语言: 英语(English)
- 任务类别: 文本生成(text-generation)
- 标签: 营销、品牌声音、文案创作、广告、指令微调(marketing, brand-voice, copywriting, advertising, instruction-tuning)
- 数据规模: 1,300 条记录(1K < n < 10K)
数据内容
数据集包含品牌营销文案的指令-完成对,每条记录包含一个简短的创意简报和对应的完整文案。具体组成如下:
- 1,004 条品牌文案示例,覆盖 83 个真实品牌(如 Stripe、Notion、Liquid Death、Duolingo 等)
- 296 条营销技巧课程,基于说服与文案写作研究
- 完成部分平均 48 词(范围 20–63 词),提示部分平均 16 词
- 品牌声音从公开营销材料中分析得出,文案以相应声音生成,非逐字复制
数据列说明
| 列名 | 说明 |
|---|---|
prompt |
创意简报:写什么、针对哪个渠道、达到什么目标 |
completion |
实际的品牌文案,或技巧课程答案 |
brand |
文案对应的品牌(技巧行为 General marketing) |
category |
品牌垂直领域:消费、开发工具、AI、游戏、金融科技、SaaS、B2B |
channel |
格式:X 帖子、LinkedIn、邮件、着陆页、推送、广告、更新日志等 |
tone |
品牌声音的情感基调 |
personality |
声音的若干个性特征 |
voice_summary |
品牌声音的单行摘要 |
task |
write(品牌文案)或 principle(技巧课程) |
使用建议
数据集适合用于指令微调,可将提示和完成映射为问答对,并将品牌、类别、渠道、基调、个性、声音摘要等作为上下文传递。推荐配置: json { "prompt": "prompt", "completion": "completion", "context": ["brand", "category", "channel", "tone", "personality", "voice_summary"] }
任务列(task)不映射。支持去重(deduplication)和提示重述(prompt_rephrase)等处理流程。
快速示例
python import pandas as pd df = pd.read_csv("hf://datasets/manifesta/brandvoice-marketing-briefs/brandvoice_briefs.csv")
查看 Liquid Death 品牌文案
df[(df.brand == "Liquid Death") & (df.task == "write")][["channel", "completion"]].head()
来源与许可
数据为混合数据集:品牌声音来自公开营销材料的分析(真实信号),文案在该声音下生成(生成表面),技巧课程从公开营销研究中提炼(非直接复制)。数据集以 CC0 许可发布,允许任何人自由构建。由 MANIFESTA(Aivaras Navardauskas)为 AutoScientist Challenge 营销赛道构建。