
CentificAIResearch/DialectalSpeech-ICL
收藏官方服务:
资源简介:
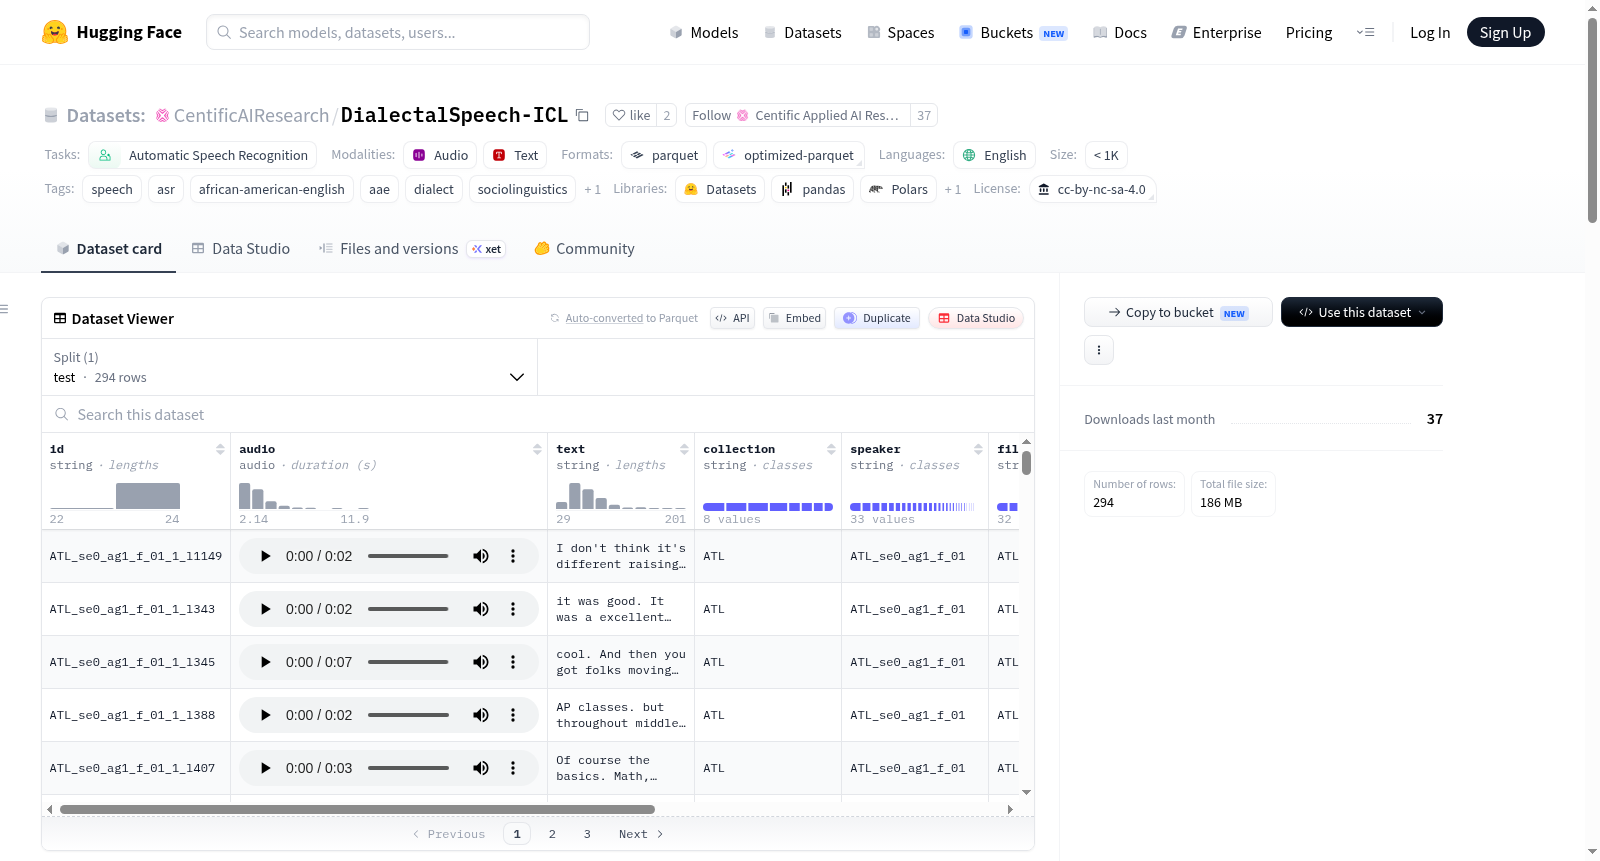
这是一个用于自动语音识别的非洲裔美国人英语(AAE)语音数据集,涵盖多种地区变体。每条记录提供一个音频片段、其逐字参考转录文本以及说话者/地区元数据,旨在评估方言、低资源语音上的自动语音识别和上下文学习方法。本次发布是从所有地区集合中抽取的分层样本。
This is an African American English (AAE) speech dataset for automatic speech recognition (ASR), encompassing multiple regional variants. Each record includes an audio clip, its verbatim reference transcription, and speaker and region metadata, which is designed to evaluate automatic speech recognition and in-context learning methods on dialectal and low-resource speech. This release is a stratified sample drawn from the full regional speech corpus.
提供机构:
CentificAIResearch搜集汇总
数据集介绍
构建方式
DialectalSpeech-ICL数据集源自区域非裔美国英语语料库(CORAAL),旨在为低资源方言语音识别及上下文学习研究提供基准。该数据集通过分层抽样策略,从涵盖亚特兰大、底特律、纽约下东区等八个地域的方言语音集合中,精心选取294条非裔美国英语(AAE)话语样本。每条记录均包含以44.1kHz采样的16位PCM音频文件、逐字参考转录文本,以及标注了说话者身份、地域集合和声学时长等元数据。此外,数据集还嵌入了检测自语音的AAE语言特征(如惯用“be”、系词省略)及其数量统计,以支持细粒度的方言分析。
特点
DialectalSpeech-ICL的核心特色在于其对方言多样性与科研可复现性的双重关注。数据集不仅覆盖了八个代表不同非裔美国人社区的区域变体,还通过结构化的分层抽样确保每个地域的话语数量均衡,从而为跨方言的泛化能力评估提供可靠基础。每个样本均包含丰富的结构化元数据,特别是将语言学特征(如AAE特征标志)作为显式字段存储,这为探究方言语音的声学-语言学关联提供了独特视角。同时,数据集采用Hugging Face的Audio特征格式嵌入音频,便于与现代机器学习框架无缝集成,且总样本量不足一千条,适合快速迭代和细粒度分析。
使用方法
使用者可通过Hugging Face的`datasets`库直接加载DialectalSpeech-ICL数据集,只需调用`load_dataset('CentificAIResearch/DialectalSpeech-ICL', split='test')`即可获取全部294条测试样本。返回的每条记录是一个字典,包含音频波形数组及采样率(可通过`row['audio']['array']`和`row['audio']['sampling_rate']`访问)、逐字转录文本(`row['text']`)、说话者标识、地域集合名称及AAE特征字段等。数据集以Parquet格式存储,音频文件则独立存放于`data/audio/`目录下,并随附`transcripts.jsonl`提供元数据与音频路径的对应关系。若需引用,请务必注明CORAAL原始语料库,且仅限非商业研究与教育用途。
背景与挑战
背景概述
DialectalSpeech-ICL数据集由Centific AI Research团队创建,旨在推动非裔美国人英语(AAE)方言语音识别与上下文学习的研究。该数据集从《区域非裔美国人英语语料库》(CORAAL)中精心抽取,覆盖亚特兰大、底特律、纽约等多个地区,包含294条经过分层抽样的语音片段,每条数据均提供音频、逐字转录文本及说话人/区域元数据。作为首个专注于AAE方言的上下文学习评估基准,它填补了主流语音识别系统对非标准英语方言性能评估的空白,为低资源方言语音处理、社会语言学与AI交叉领域提供了关键资源,其发布促进了方言语音识别公平性与适应性的研究。
当前挑战
该数据集所解决的领域挑战在于:主流自动语音识别(ASR)模型对African American English等非标准方言的识别准确率显著偏低,系统常将特色语法结构(如habitual 'be'、系词省略)误识别为错误,导致严重的方言偏误与公平性问题。构建过程中面临两大挑战:其一,CORAAL语料库包含多地区、多说话人的录音,需确保采样代表性以覆盖AAE的区域变异,同时保持口语转录的逐字精确性;其二,需为每条语音标注AAE语言学特征(如非标准语法结构),这要求跨学科协作将社会语言学知识融入数据标注流程,增加了构建复杂度与专业性门槛。
常用场景
经典使用场景
DialectalSpeech-ICL数据集专为评估自动语音识别系统在非裔美国人英语方言上的表现而设计。其经典的用法是将294条涵盖亚特兰大、华盛顿特区、底特律等八个地域变体的语音样本作为测试集,衡量ASR模型对含有习惯性be动词省略、系词脱落等特征方言的识别鲁棒性。研究者通常将本数据集与标准美语语音数据配对,构建方言感知的少样本学习评估框架,从而检验模型在低资源方言场景下的泛化能力。
衍生相关工作
该数据集衍生出了若干影响深远的研究工作。一方面,研究者基于其方言特征标注字段开发了非裔美国人英语特征的自动检测器,将习惯性be动词、复数省略等语言学现象转化为可计算的分类任务。另一方面,它启发了上下文学习技术在方言语音识别中的应用,例如通过设计提示模板引导预训练模型关注方言变体模式。此外,该数据集与源语料库CORAAL的结合,促进了跨地域方言差异的计量语言学研究,为美国非裔方言的时空演变分析提供了计算工具支撑。
数据集最近研究
最新研究方向
DialectalSpeech-ICL聚焦于非裔美国人英语(AAE)方言语音识别与上下文学习评估,涵盖多个区域变体。该数据集源自CORAAL语料库,提供294条音频及精细的方言特征标注(如习惯性be动词、系词省略),在低资源方言语音处理领域开辟了新方向。当前研究热点包括利用上下文学习技术提升ASR系统对AAE的鲁棒性,以及探讨地域性方言变体对语音模型泛化能力的影响。这为弥合主流语音技术与边缘方言之间的鸿沟提供了关键数据支撑,推动了社会语言学与语音AI的交叉发展。
以上内容由遇见数据集搜集并总结生成


