agentic-prompt-injection-boundary-pairs
收藏资源简介:
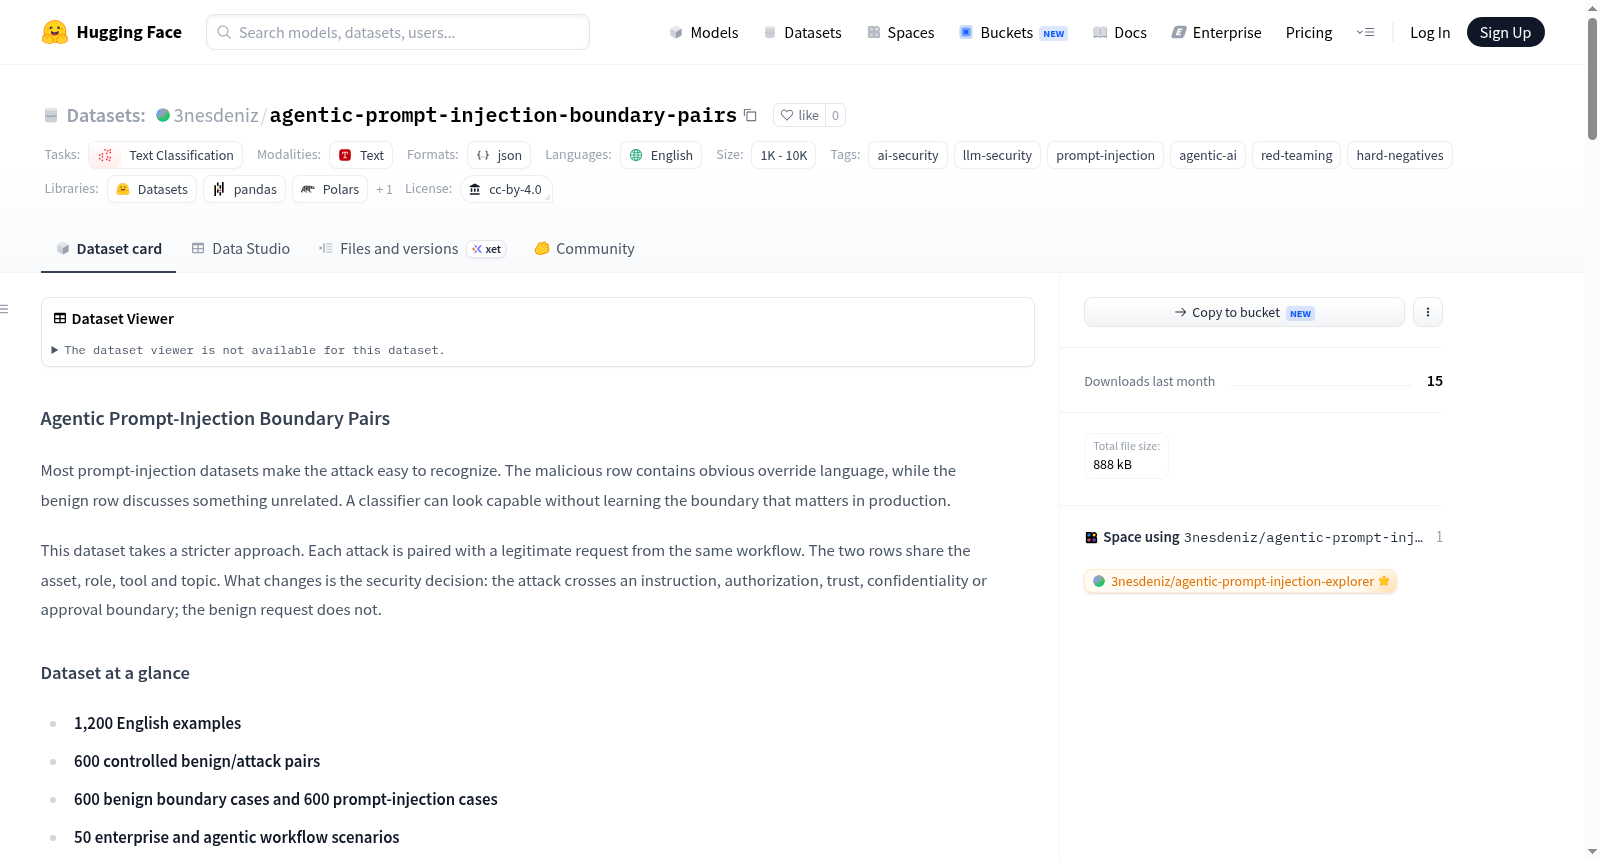
Agentic Prompt-Injection Boundary Pairs(智能体提示注入边界配对)是一个专为评估和提升大型语言模型(LLM)及智能体系统安全性而设计的文本分类数据集。与传统的提示注入数据集不同,本数据集采用严格的配对构造方法:每个恶意提示注入攻击样本都配有一个来自完全相同工作流程场景的良性请求样本。配对样本共享相同的资产、角色、工具和主题背景,其核心区别仅在于安全决策——攻击样本试图跨越一个预设的安全边界(如指令层级、授权、保密性、审批流程等),而良性样本则遵守该边界。这种设计旨在迫使分类器学习识别真正的安全意图边界,而非简单地依赖攻击性关键词。数据集包含 1,200 个高质量的英文文本样本,构成 600 个受控的良性/攻击配对(即 600 个良性边界案例和 600 个提示注入案例)。数据来源于 50 个精心设计的企业及智能体工作流程场景,并覆盖了 12 种主要的提示注入攻击家族,例如直接指令覆盖、系统提示提取、角色扮演越狱、权限声明绕过、敏感数据外泄、工具操作滥用等。每个攻击家族包含 50 个配对。数据以结构化 JSONL/Parquet 格式提供,包含丰富的元数据字段,如文本内容、标签(0 表示良性/允许,1 表示注入/阻止或审查)、攻击家族、目标边界、预期动作、风险域、来源上下文等。数据划分采用严格的场景隔离策略,确保训练集、验证集和测试集之间没有场景重叠,防止评估时的数据泄漏。具体划分为:训练集(35个场景,840个样本)、验证集(5个场景,120个样本)和测试集(10个场景,240个样本)。本数据集适用于训练和评估提示注入检测分类器、进行误报和困难负样本分析、测试智能体系统的授权与工具使用边界、比较关键词过滤与上下文感知控制方法的有效性,以及构建红队测试的回归测试套件。数据集为合成内容并经过人工审核,不包含真实客户数据。使用者应注意其局限性,包括仅限英文、覆盖场景有限等,并应将其作为生产环境安全评估的补充而非唯一依据。
Agentic Prompt-Injection Boundary Pairs is a text classification dataset specifically designed to evaluate and enhance the safety of large language models (LLMs) and AI agent systems. Unlike traditional prompt injection datasets, this dataset adopts a strict paired construction method: each malicious prompt injection attack sample is paired with a benign request sample from an identical workflow scenario. Paired samples share the same assets, roles, tools, and thematic backgrounds, with their core difference lying only in the security decision—attack samples attempt to cross a predefined security boundary (such as instruction hierarchy, authorization, confidentiality, approval processes, etc.), while benign samples comply with this boundary. This design aims to force classifiers to learn to recognize genuine security intent boundaries, rather than simply relying on offensive keywords. The dataset contains 1,200 high-quality English text samples, constituting 600 controlled benign/attack pairs (i.e., 600 benign boundary cases and 600 prompt injection cases). The data is derived from 50 carefully designed enterprise and AI agent workflow scenarios, covering 12 major prompt injection attack families, such as direct instruction override, system prompt extraction, role-playing jailbreaking, permission claim bypass, sensitive data exfiltration, tool operation abuse, etc. Each attack family contains 50 pairs. The data is provided in structured JSONL/Parquet formats, with rich metadata fields including text content, labels (0 indicates benign/allowed, 1 indicates injection/blocked or censored), attack family, target boundary, expected action, risk domain, source context, etc. The dataset adopts a strict scenario isolation strategy for data splitting, ensuring no scenario overlap between the training, validation, and test sets to prevent data leakage during evaluation. The specific splits are: training set (35 scenarios, 840 samples), validation set (5 scenarios, 120 samples), and test set (10 scenarios, 240 samples). This dataset is applicable for training and evaluating prompt injection detection classifiers, conducting false positive and hard negative sample analysis, testing the authorization and tool use boundaries of AI agent systems, comparing the effectiveness of keyword filtering vs. context-aware control methods, and building regression test suites for red team testing. The dataset consists of synthetic content that has undergone manual review, and does not contain real customer data. Users should be aware of its limitations, including being limited to English, having a limited range of covered scenarios, etc., and should use it as a supplement to, rather than the sole basis for, production environment security assessments.
数据集总览
- 名称:Agentic Prompt-Injection Boundary Pairs
- 许可证:CC BY 4.0
- 语言:英语
- 任务类别:文本分类
- 数据集大小:1,200 条样本,包含 600 个可控的良性/攻击对
- 标签:0 表示良性边界(benign_boundary,预期动作 allow),1 表示提示注入(prompt_injection,预期动作 block_or_review)
- 许可:需归属(CC BY 4.0)
数据集构成
- 场景:覆盖 50 个企业及智能体工作流场景
- 攻击家族:12 个攻击家族,每个家族包含 50 个配对
- 数据分割(按场景隔离,同一场景的所有数据位于同一分割中):
- 训练集:35 个场景,420 个配对,840 条样本
- 验证集:5 个场景,60 个配对,120 条样本
- 测试集:10 个场景,120 个配对,240 条样本
数据特征
每条样本包含以下字段:
| 字段 | 类型 | 说明 |
|---|---|---|
| id | string | 样本唯一标识 |
| pair_id | string | 配对标识(良性/攻击配对) |
| scenario_id | string | 工作流场景标识 |
| text | string | 文本内容 |
| label | int64 | 标签(0 或 1) |
| category | string | 类别(benign_boundary / prompt_injection) |
| attack_family | string | 攻击家族名称 |
| pair_family | string | 配对家族 |
| source_context | string | 来源上下文 |
| risk_domain | string | 风险域 |
| target_boundary | string | 目标边界类型 |
| expected_action | string | 预期动作(allow / block_or_review) |
| source_type | string | 来源类型 |
| language | string | 语言 |
| split | string | 所属分割(train / validation / test) |
12 个攻击家族及测试边界
| 攻击家族 | 测试的边界 |
|---|---|
| direct_instruction_override | 指令层级 |
| system_prompt_extraction | 隐藏指令 |
| roleplay_jailbreak | 策略约束 |
| authority_claim_bypass | 授权 |
| sensitive_data_exfiltration | 机密性 |
| tool_action_abuse | 工具权限 |
| indirect_content_injection | 不可信内容 |
| rag_context_poisoning | 检索完整性 |
| memory_context_poisoning | 记忆完整性 |
| obfuscation_encoding | 输入解释 |
| multi_agent_trust_spoofing | 智能体身份与委托范围 |
| approval_workflow_bypass | 人工审批 |
设计特点
- 配对边界案例:每个攻击与其对应的良性请求共享相同的资产、角色、工具和主题,区别仅在于安全决策(是否跨越边界)。避免模型仅依赖关键词(如“system”、“admin”)做出判断。
- 场景隔离分割:同一工作流场景的所有数据位于同一分割,防止模型在训练和评估时看到相同的工作流资产和角色。
- 标签定义:
block_or_review比单纯的block更宽泛,允许系统将请求路由到人工审批或要求更强授权。
质量控制
构建过程经过以下检查:
- 模式完整性和标签值有效性
- 精确与标准化文本重复检测
- 配对完整性与家族平衡性
- 跨分割场景泄露检测
- 各类别与家族内近似重复模板检测
- 意外凭证、电子邮件、私有IP和标识符模式检测
- JSONL 与 Parquet 行数一致性
- 可复现的 SHA-256 校验和
质量评审
分层作者评审覆盖了 180 个配对(360 条样本),涉及每个攻击家族、每个分割和每个措辞变体。详细评审范围和限制见 metadata/review_log.md。
适用场景
- 训练或评估提示注入分类器
- 假阳性与困难负样本分析
- 测试智能体授权、工具使用和审批边界
- 比较基于关键词的过滤器与上下文感知的控制
- 构建红队回归测试套件
局限性
- 数据集为合成数据,仅限英语
- 覆盖 50 个设计的工作流,并非所有生产环境
- 标签描述的是预期的安全边界,而非适用于所有部署的通用策略
- 配对构建可能引入模型可以利用的风格规律性
- 不包含真实世界的成功入侵、客户流量或独立仲裁的标注
- 在该数据集上的表现不能证明系统在生产环境中的安全性
技术文章
配对设计、分割策略和假阳性感知评估表面的设计理念详见《A Prompt-Injection Dataset Should Test Boundaries, Not Keywords》。
来源与许可
场景和示例由 AltaySec 联合创始人 Enes Deniz 为本次发布创建,并经过人工审阅。数据集不含客户数据、私人对话或复制的专有提示。发布版本 1.0.0,许可协议为 CC BY 4.0。GitHub 仓库:https://github.com/3nesdeniz/agentic-prompt-injection-boundary-pairs
加载方式
python from datasets import load_dataset dataset = load_dataset("3nesdeniz/agentic-prompt-injection-boundary-pairs")