TTS-AGI/ears-dramabox
收藏资源简介:
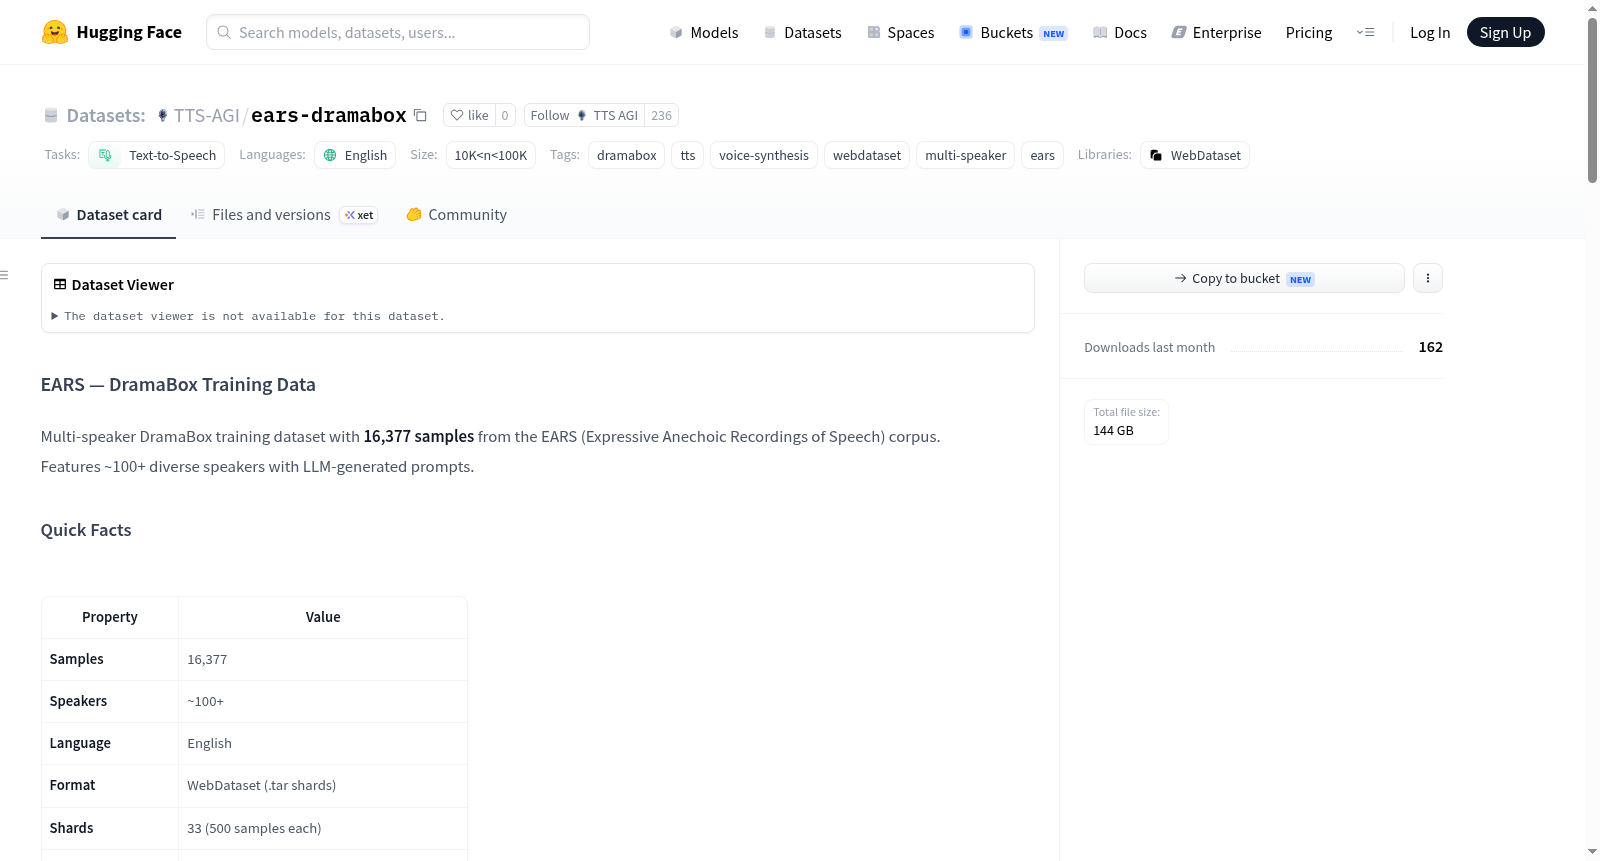
EARS DramaBox训练数据集是一个多说话者数据集,包含来自EARS(表达性无混响语音录音)语料库的16,377个样本。该数据集具有约100多个不同的说话者,并使用Gemma-3-4B-IT生成创意、细致的提示。数据以WebDataset格式(.tar分片)存储,每个样本包括8个文件:.json元数据(包含文本、原始文本、持续时间、BUD-E字幕、语音标签、音色字幕、完整提示和聚焦提示)、.mp3音频文件、.tgt_latent.pt目标音频潜在表示、.ref_latent.pt参考音频潜在表示、.cond_full.pt完整提示条件信息、.cond_focused.pt聚焦提示条件信息、.speaker_emb.pt说话者嵌入和.clap_text.pt CLAP文本嵌入。该数据集适用于文本到语音(TTS)任务,支持多种训练配置,如预配对、同说话者交换和独立样本,有效配置总数至少约65,508个。
EARS DramaBox training dataset is a multi-speaker dataset containing 16,377 samples sourced from the EARS (Expressive Anechoic Speech Recording) corpus. This dataset includes over 100 distinct speakers, and creative and detailed prompts are generated using Gemma-3-4B-IT. The data is stored in WebDataset format as .tar shards, with each sample comprising 8 files: a .json metadata file containing text, original text, duration, BUD-E subtitles, speech tags, timbre subtitles, full prompt and focused prompt; a .mp3 audio file; .tgt_latent.pt for target audio latent representation; .ref_latent.pt for reference audio latent representation; .cond_full.pt for full prompt conditioning information; .cond_focused.pt for focused prompt conditioning information; .speaker_emb.pt for speaker embedding; and .clap_text.pt for CLAP text embedding. This dataset is suitable for text-to-speech (TTS) tasks, supporting multiple training configurations such as pre-paired, same-speaker swapping and independent samples, with a total of at least approximately 65,508 valid configurations.