eval-laion_lrboost-80-8B_DCAgent2_swebench-verified-random-100-folders-traces
收藏资源简介:
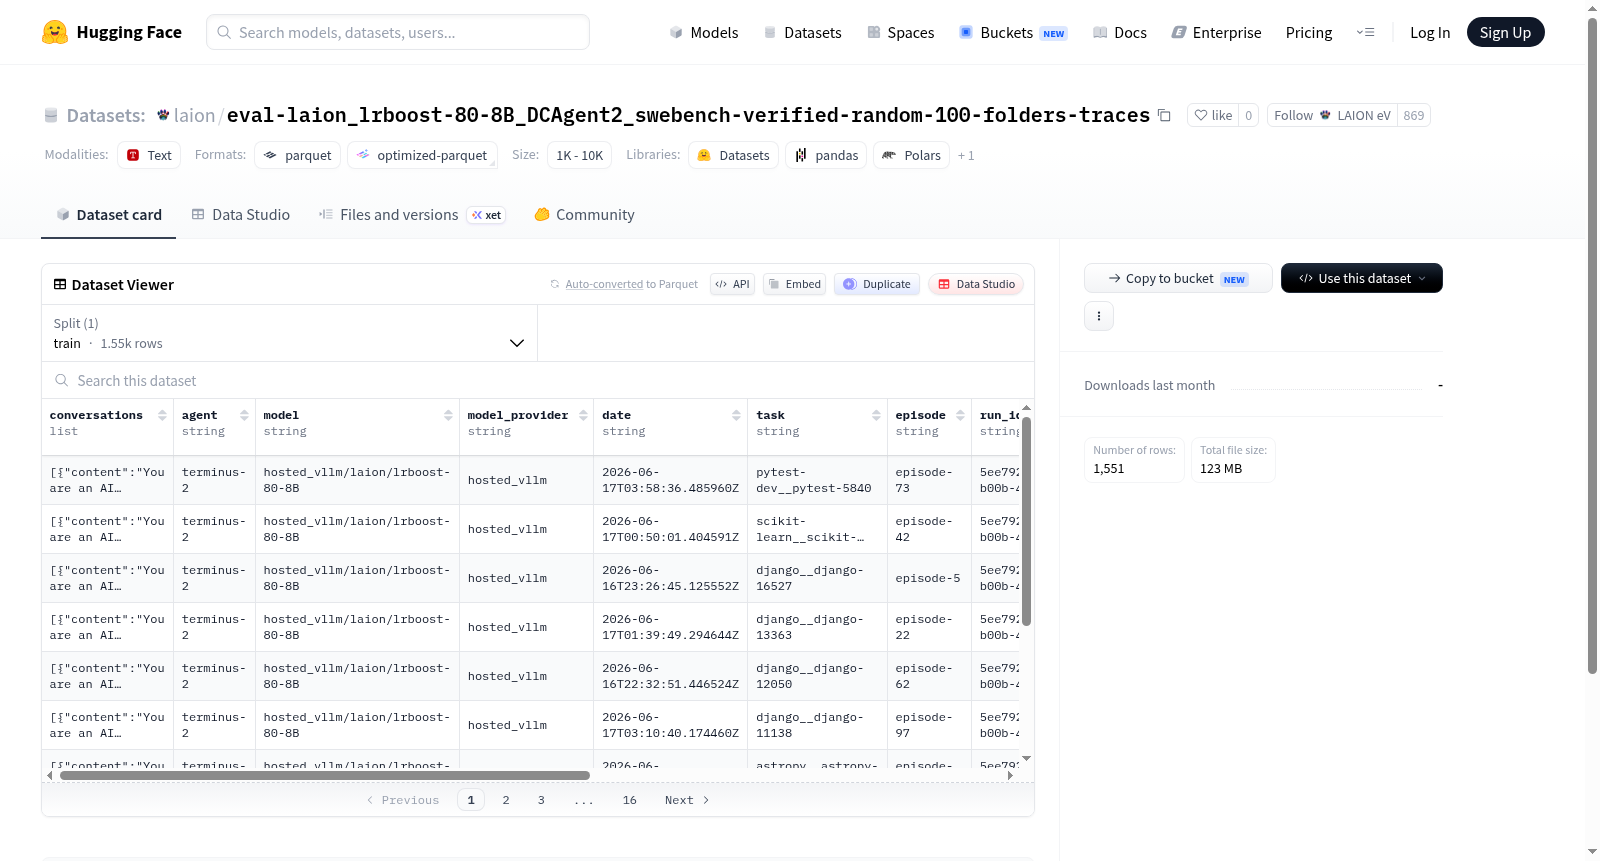
该数据集是一个结构化对话记录集合,主要用于记录AI代理或模型在特定任务上的交互过程与实验数据。数据集包含1551个训练样本,总大小约185MB。每个样本包含多轮对话记录(conversations字段,其中每轮对话有内容和角色信息),以及丰富的元数据字段:agent(代理标识)、model(模型名称)、model_provider(模型提供商)、date(日期)、task(任务类型)、episode(回合标识)、run_id(运行ID)、trial_name(试验名称)、result(结果)、verifier_output(验证器输出)和trace_source(追踪来源)。这些字段表明数据集可能用于AI交互实验、任务性能评估、对话轨迹分析等场景,适用于对话系统研究、AI代理行为分析、实验数据记录等任务。
This dataset is a collection of structured dialogue records, primarily used to document the interaction processes and experimental data of AI Agents or models during specific tasks. It contains 1551 training samples with a total size of approximately 185 MB. Each sample includes multi-turn dialogue records (in the `conversations` field, where each turn contains content and role information) and a rich set of metadata fields: `agent` (agent identifier), `model` (model name), `model_provider` (model provider), `date` (date), `task` (task type), `episode` (episode identifier), `run_id` (run ID), `trial_name` (trial name), `result` (result), `verifier_output` (verifier output), and `trace_source` (trace source). These fields indicate that this dataset can be applied to scenarios such as AI interaction experiments, task performance evaluation, and dialogue trajectory analysis, and is suitable for tasks including dialogue system research, AI Agent behavior analysis, and experimental data recording.
- 数据集名称:eval-laion_lrboost-80-8B_DCAgent2_swebench-verified-random-100-folders-traces
- 托管平台:Hugging Face
- 数据集地址:https://huggingface.co/datasets/laion/eval-laion_lrboost-80-8B_DCAgent2_swebench-verified-random-100-folders-traces
数据集特征
该数据集包含以下字段:
- conversations:对话内容列表,每条对话包含
content(字符串类型)和role(字符串类型)。 - agent:代理标识(字符串类型)。
- model:模型名称(字符串类型)。
- model_provider:模型提供者(字符串类型)。
- date:日期(字符串类型)。
- task:任务描述(字符串类型)。
- episode:回合编号(字符串类型)。
- run_id:运行ID(字符串类型)。
- trial_name:试验名称(字符串类型)。
- result:结果(字符串类型)。
- verifier_output:验证器输出(字符串类型)。
- trace_source:追踪来源(字符串类型)。
数据集划分
- 训练集(train):包含 1,551 个样本,数据大小为 185,450,073 字节。
数据集大小
- 下载大小:122,828,754 字节
- 数据集总大小:185,450,073 字节
配置信息
- 默认配置(default):数据文件路径为
data/train-*,仅包含训练集分割。