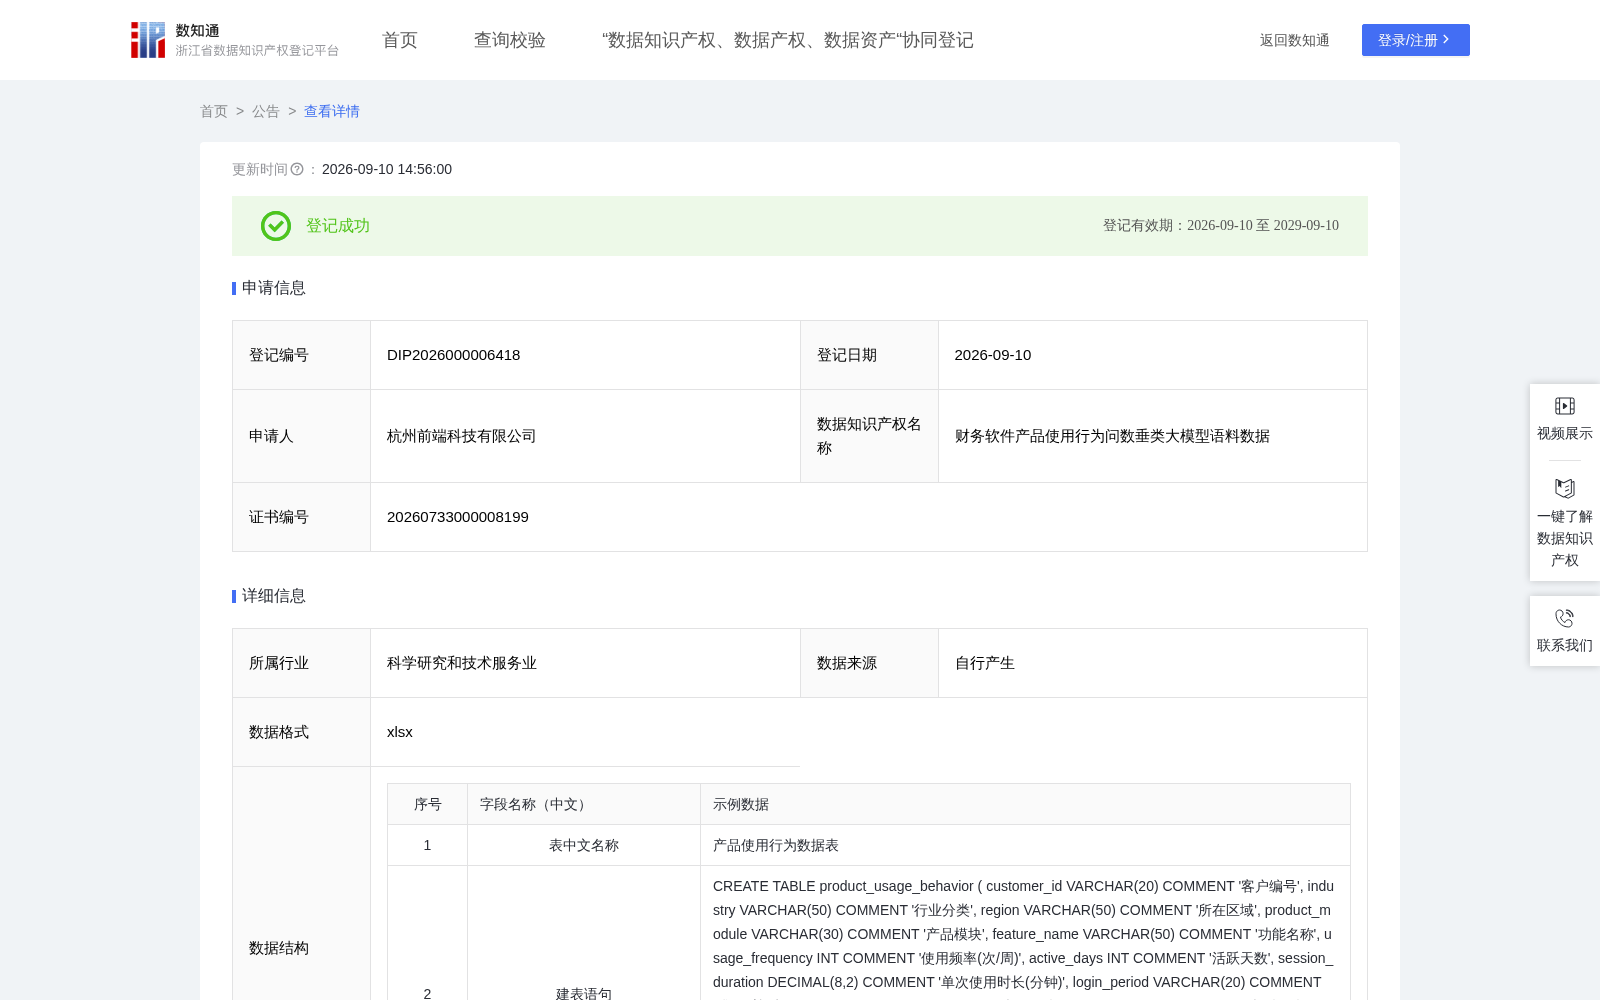
财务软件产品使用行为问数垂类大模型语料数据
收藏资源简介:
本数据来源于公司代理的财务软件在销售过程中的客户产品使用行为数据,涵盖客户行业分类、所在区域、产品模块、功能名称、使用频率、活跃天数、单次使用时长、登录时间段、操作次数、报错次数、求助次数、数据处理量、最近活跃日期、功能采用状态、熟练程度、使用趋势、客户等级等18个维度结构化数据,经清洗标准化、去标识化处理后构建问数语料库。在加工层面,将自然语言问题与标准SQL查询语句配对,覆盖使用统计、采用率分析、报错分析、活跃度评估、熟练度对比等10类查询场景,形成"问题→SQL→结果"三元组语料。当前财务软件代理行业面临产品功能采用率缺乏量化、用户行为分析依赖人工统计、报错趋势难以实时监控、功能优化缺乏数据支撑等痛点。同时,该语料集经过标准化标注处理,可为财务软件代理领域BERT-PUB产品使用行为语义解析模型提供结构化训练样本,推动行业从"被动响应需求"向"主动行为洞察"演进。1.数据清洗与标准化: 采集财务软件代理业务客户产品使用行为数据,原始数据涵盖客户编号、行业分类、所在区域、产品模块、功能名称、使用频率、活跃天数、单次使用时长、登录时间段、操作次数、报错次数、求助次数、数据处理量、最近活跃日期、功能采用状态、熟练程度、使用趋势、客户等级共18个字段;按"客户编号+产品模块"去重;通过逻辑校验删除矛盾数据(如未使用却有操作次数、活跃天数为0却有使用频率);对客户编号哈希脱敏确保不可逆;构建标准化数据表product_usage_behavior作为问数语料底座。 2.问题分类与结构化: 围绕客户对软件功能的采用、活跃与熟练分层,将自然语言问题划分为使用统计、采用率分析、报错分析、活跃度评估、熟练度对比等10大查询类型;每类对应标准SQL模板,覆盖COUNT、AVG、SUM、GROUP BY、WHERE多条件、日期区间、比率计算等SQL语法要素,确保问题到SQL映射的确定性。 3.核心算法建模: 本语料面向财务软件代理产品使用行为问数场景,可支撑构建BERT-PUB(Product Usage Behavior)垂类语义解析模型进行问数问答加工;该模型以BERT-base为基座,经Token化与位置编码后输入Transformer编码器,通过Schema Linking机制将字段与问题实体对齐,解析生成SQL语句,实现"问题→SQL→结果"映射,为领域适配提供训练与评测样本。 4.语料库持续扩充: 依据客户软件使用行为数据持续积累,通过人工标注补充自然语言问题及其对应标准SQL,形成稳定的"问题→SQL→结果"三元组语料;对同一查询意图生成多种自然语言表达变体,提升覆盖度与泛化性;语料随使用数据更新定期增量扩充,保持时效性与完整性。 5.语料独立性说明: 本语料以客户软件使用行为为主体,字段围绕功能采用、活跃程度、熟练分层等行为特征展开,与客户价值、续费管理、营销引流等以交易或经营为主体的语料,在数据主体、字段语义、查询对象上存在本质差异。若合并训练,不同主体语料加大模型对实体识别与条件约束的区分难度,降低各主题SQL生成准确性;分开训练可让模型专注单一行为主体的语义与字段映射,提升解析精度,且各语料可独立扩充、独立评测,避免关联更新牵动全量重训,降低维护成本,符合垂类模型按业务主题分域训练的工程实践。