
遇见数据集

lance-format/fineweb-edu

收藏
Hugging Face2026-05-18 更新2026-03-29 收录
官方服务:

资源简介:

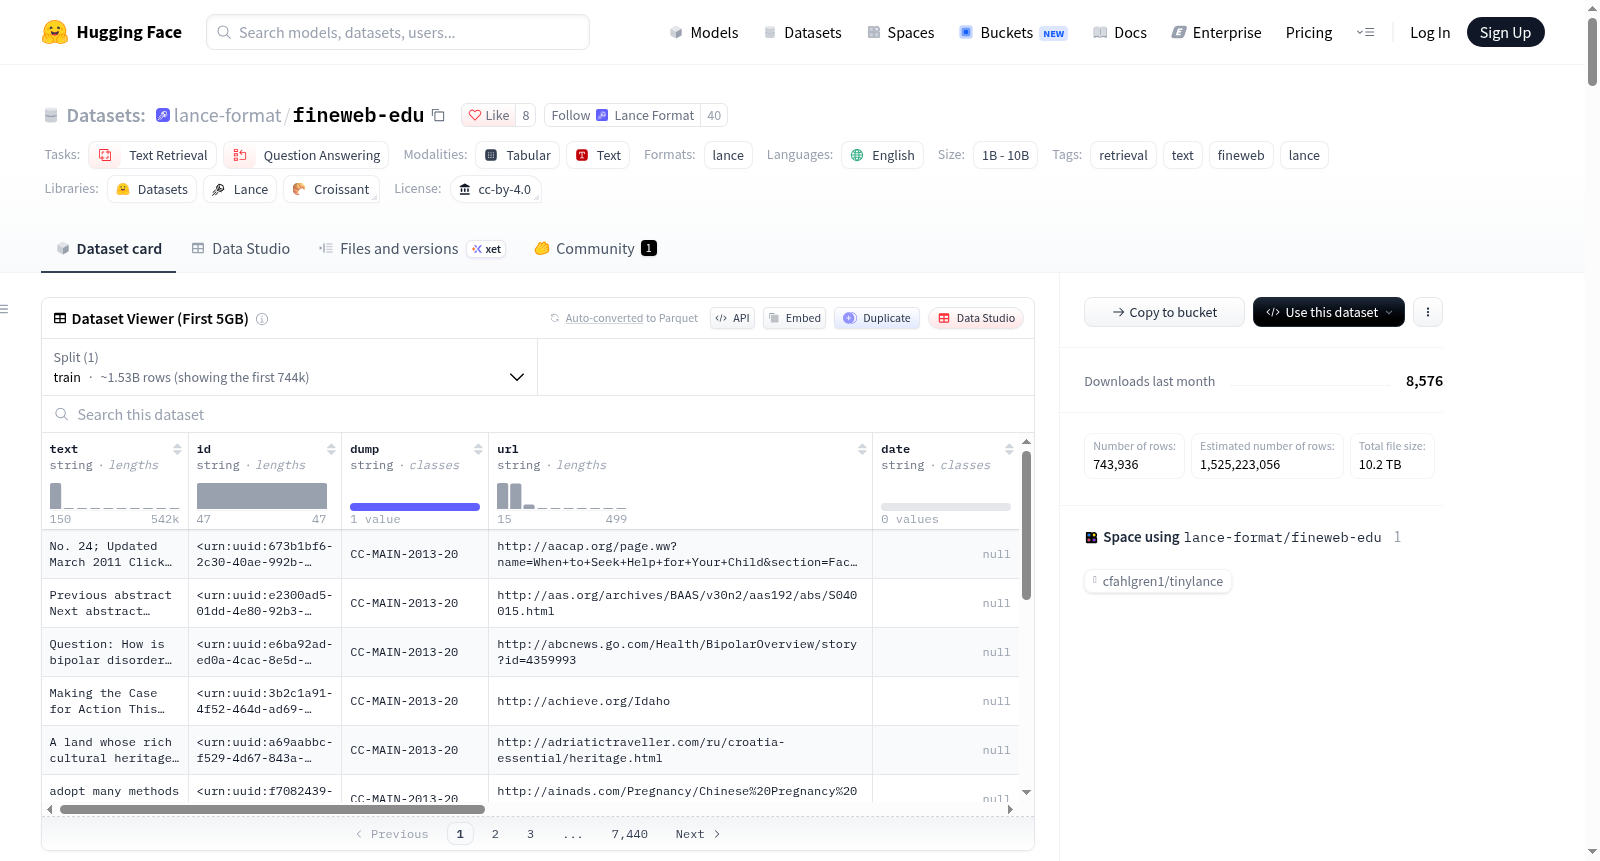
FineWeb-Edu (Lance格式)是FineWeb-Edu数据集的Lance格式版本,包含超过15亿个教育类网页段落。每个段落包含清理后的文本、源URL、标题、语言检测信号(语言代码和置信度)以及预计算的384维文本嵌入。数据集采用Lance列式存储格式,支持高效随机访问、多模态数据存储、本地索引构建、数据演化和版本控制。适用于文本检索、问答、机器学习训练等任务,特别适合大规模教育内容分析和检索应用。数据来源于网络,遵循ODC-BY 1.0许可。

FineWeb-Edu (Lance format) is the Lance-formatted variant of the FineWeb-Edu dataset, containing over 1.5 billion educational web paragraphs. Each paragraph includes cleaned text, source URL, title, language detection signals (language code and confidence score), and pre-computed 384-dimensional text embeddings. The dataset adopts the Lance columnar storage format, which supports efficient random access, multimodal data storage, local index construction, data evolution, and version control. It is suitable for tasks such as text retrieval, question answering, and machine learning training, and is particularly ideal for large-scale educational content analysis and retrieval applications. The data is sourced from the web and is licensed under ODC-BY 1.0.
提供机构:
lance-format
搜集汇总
数据集介绍
lance-format/fineweb-edu 数据集图片
构建方式
在教育文本语料库日益追求细粒度清洗与可检索性的背景下,fineweb-edu的构建承接HuggingFaceFW/fineweb-edu上游语料,将其转换为Lance列式格式并写入train.lance。转换过程保留清洗后的段落正文、页面标题、规范URL、语言检测结果及置信度,同时继承上游质量启发式评分与长度统计。为支持下游向量检索,数据集预先计算384维文本嵌入,并与文本、元数据共同组织为单列式资产。各列独立存储,使构建时可按需投影、延迟读取,从而在十亿级规模下兼顾数据完整性与查询效率。
特点
作为面向教育内容理解与检索任务的大规模资源,该数据集聚合逾15亿条教育网页段落,覆盖英文等语言信号并可依语言概率过滤。其Lance列式架构将文本、标题、URL、语言概率、质量元数据与384维嵌入并置存储,既支持廉价元数据扫描,也支持随机访问和后续ANN检索。数据未在Hub副本内预置索引,故向量与全文索引需在本地副本上构建;数据集版本提交与标签机制则为复现检索系统和训练实验提供稳定切片。
使用方法
围绕教育问答、检索增强生成与语言模型预训练等应用,该数据集可通过datasets.load_dataset以流式方式快速采样,也可经LanceDB连接Hub路径或本地目录进行查询。生产工作流通常先下载本地副本,再构建IVF_PQ向量索引与INVERTED全文索引,从而执行稠密检索、关键词检索、混合重排及SQL式过滤。训练阶段可借助列投影仅读取text或text_embedding,策展与演化则通过过滤扫描、增列、合并标签和版本固定实现;物化子集可将十亿级语料缩限为任务相关切片。
背景与挑战
背景概述
FineWeb-Edu 于2024年由 Hugging Face 的 Anton Lozhkov、Loubna Ben Allal、Leandro von Werra 与 Thomas Wolf 等研究者构建,旨在从开放网页中萃取逾十五亿条具有教育价值的英文文本段落。其核心研究问题在于以可复现流程筛选高质量教育内容,为大规模语言模型预训练、检索增强生成与问答系统提供兼具规模与质量的语料基础。当前由 lance-format 发布的 Lance 版本在保留原文、来源、语言检测与384维嵌入的同时,引入列式存储与随机访问能力,对开放语料治理、教育内容检索及嵌入训练具有显著影响。
当前挑战
该数据集所面对的领域问题,是在开放网页中高通量识别并组织教育性文本,使模型既能获得海量预训练信号,又能执行语义检索与问答;然而教育价值判定、语言置信度与质量元数据的校准仍具难度。构建过程中,十五亿级行规模令索引文件难以随Hub副本分发,矢量与全文索引须在本地以IVF_PQ和倒排结构另行建立,随机访问与检索因此依赖本地物化或子集抽取。海量段落的嵌入计算、去重、版权合规、版本演化及存储开销亦构成持续挑战。
常用场景
经典使用场景
于教育语料与开放域检索交汇的研究脉络中,FineWeb-Edu 最经典的使用场景集中于面向教育网页的大规模稠密检索与问答系统构建。凭借逾十五亿条清洗段落、标题、URL、语言检测信号及384维文本嵌入,研究者可先以语言概率与质量元数据过滤出高置信度英语教育文本,再在 text_embedding 上建立 IVF_PQ 近邻索引,并将全文倒排索引与向量相似度融合为混合检索。该流程既服务开放域问答与检索增强生成中的证据召回,也可投影 text 列支撑语言模型预训练,使教育内容检索、语义搜索与语料训练在同一列式范式内衔接。
解决学术问题
围绕教育语料稀缺、质量参差与实验不可复现等长期困扰,FineWeb-Edu 提供了具元数据标注、语言置信度与预计算嵌入的十亿级开放资源,从而缓解学术研究对大规模高质量教育文本的获取瓶颈。它使检索模型、开放域问答、检索增强生成与语言模型数据筛选得以在统一、可版本化的语料上比较,支持研究教育内容过滤准则、嵌入表示质量、混合检索召回率以及预训练数据构成对下游能力的影响。其意义在于降低数据采集与清洗成本,提升教育人工智能研究的可复现性,并为开放语料治理与质量评估提供可参照的基准。
衍生相关工作
在开放语料与轻量模型协同演进的背景下,FineWeb-Edu 已同多项经典工作形成谱系关联。其上游 FineWeb 语料与教育质量分类器确立了从海量网页中筛选教学价值文本的方法,FineWeb-Edu 则将该思路推向公开基准;SmolLM 系列等小型开源语言模型以 FineWeb-Edu 作为关键预训练语料,验证了高质量教育数据对参数高效模型的增益。检索增强生成、教育问答与嵌入评估研究亦常将其作为十亿级候选池,Lance 格式版本进一步催生基于 LanceDB 的向量与全文混合检索实践,推动数据、嵌入和索引的一体化共享。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

