ghana-chat-corpus-en
收藏资源简介:
Ghana Chat Corpus — English 是一个从ghananlpcommunity/ghana-chat数据集中提取的纯英文对话语料库,旨在作为翻译流程和多语言大语言模型训练的基础英文数据集。该数据集由Owusu, Mich-Seth和加纳NLP社区于2026年创建。数据集包含226,300个训练样本,每个样本代表一条对话。对话被结构化处理:将第一个用户消息单独提取为generated_question字段,而将所有助手回复连接起来(使用 分隔)形成text字段。此外,每个样本还包含source_type(标识来源类别,例如新闻、议会等)和source(原始来源名称)两个元数据字段,用于追溯数据出处。该数据集适用于构建对话系统、机器翻译以及训练需要加纳相关英文对话数据的多语言模型。
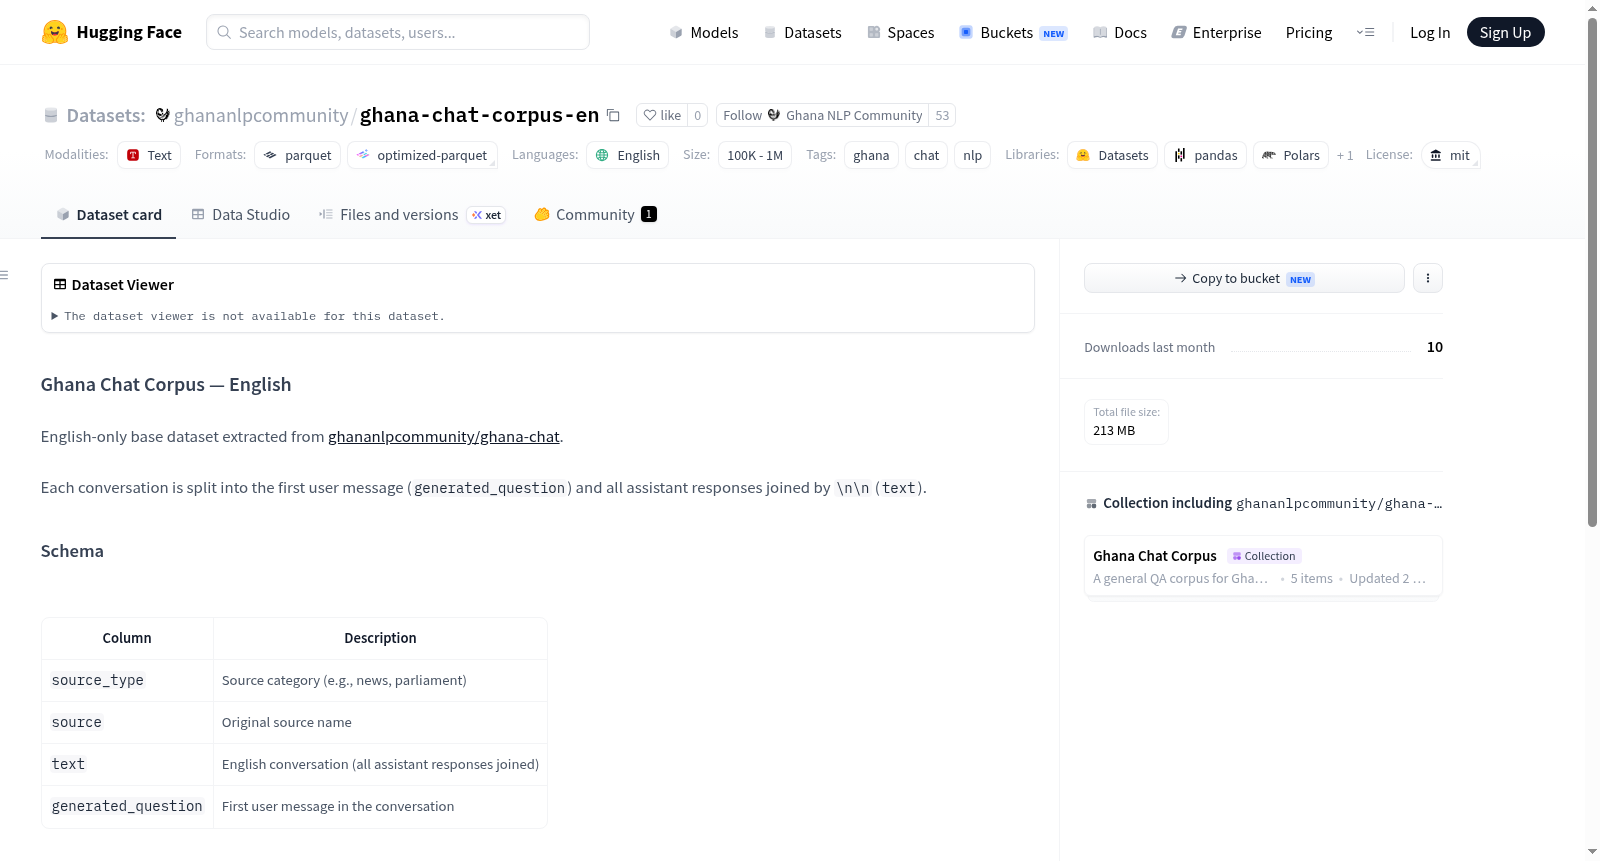
Ghana Chat Corpus — English is a pure English dialogue corpus extracted from the ghananlpcommunity/ghana-chat dataset, intended as a foundational English dataset for translation workflows and multilingual large language model (LLM) training. It was created in 2026 by Owusu, Mich-Seth and the Ghana NLP Community. The dataset contains 226,300 training samples, with each sample representing a single dialogue. Dialogues are structured such that the first user message is separately extracted as the `generated_question` field, while all assistant responses are concatenated (separated by ` `) to form the `text` field. Additionally, each sample includes two metadata fields: `source_type` (used to identify the source category, such as news, parliament, etc.) and `source` (the original source name), which serve to trace the data provenance. This dataset is applicable for building dialogue systems, machine translation, and training multilingual models that require English dialogue data related to Ghana.
数据集概述:Ghana Chat Corpus — English
- 数据集名称:Ghana Chat Corpus — English
- 数据集地址:https://huggingface.co/datasets/ghananlpcommunity/ghana-chat-corpus-en
- 语言:英语(en)
- 许可协议:MIT(mit)
- 标签:ghana, chat, nlp
数据来源与构建
该数据集是从 ghananlpcommunity/ghana-chat 数据集中提取的纯英文部分。每条对话被拆分为第一个用户消息(作为 generated_question)和所有助手回复(以 `
连接后作为text`)。
数据模式(Schema)
| 列名 | 描述 |
|---|---|
source_type |
来源类别(如新闻、议会等) |
source |
原始来源名称 |
text |
英语对话(所有助手回复连接在一起) |
generated_question |
对话中的第一条用户消息 |
数据规模
- 数据集大小:401,345,393 字节
- 下载大小:213,137,497 字节
- 分割:仅包含训练集(train)
- 训练集样本数:226,300
- 训练集字节数:401,345,393
预期用途
该英文语料库用于翻译流水线和多语言大语言模型(LLM)训练。
引用
bibtex @software{ghana-chat-corpus, title = {Ghana Chat Corpus — English}, author = {Owusu, Mich-Seth and Ghana NLP Community}, year = {2026}, }