
遇见数据集

openthaigpt/thai-ocr-evaluation

收藏
Hugging Face2024-09-30 更新2025-04-12 收录
官方服务:

资源简介:

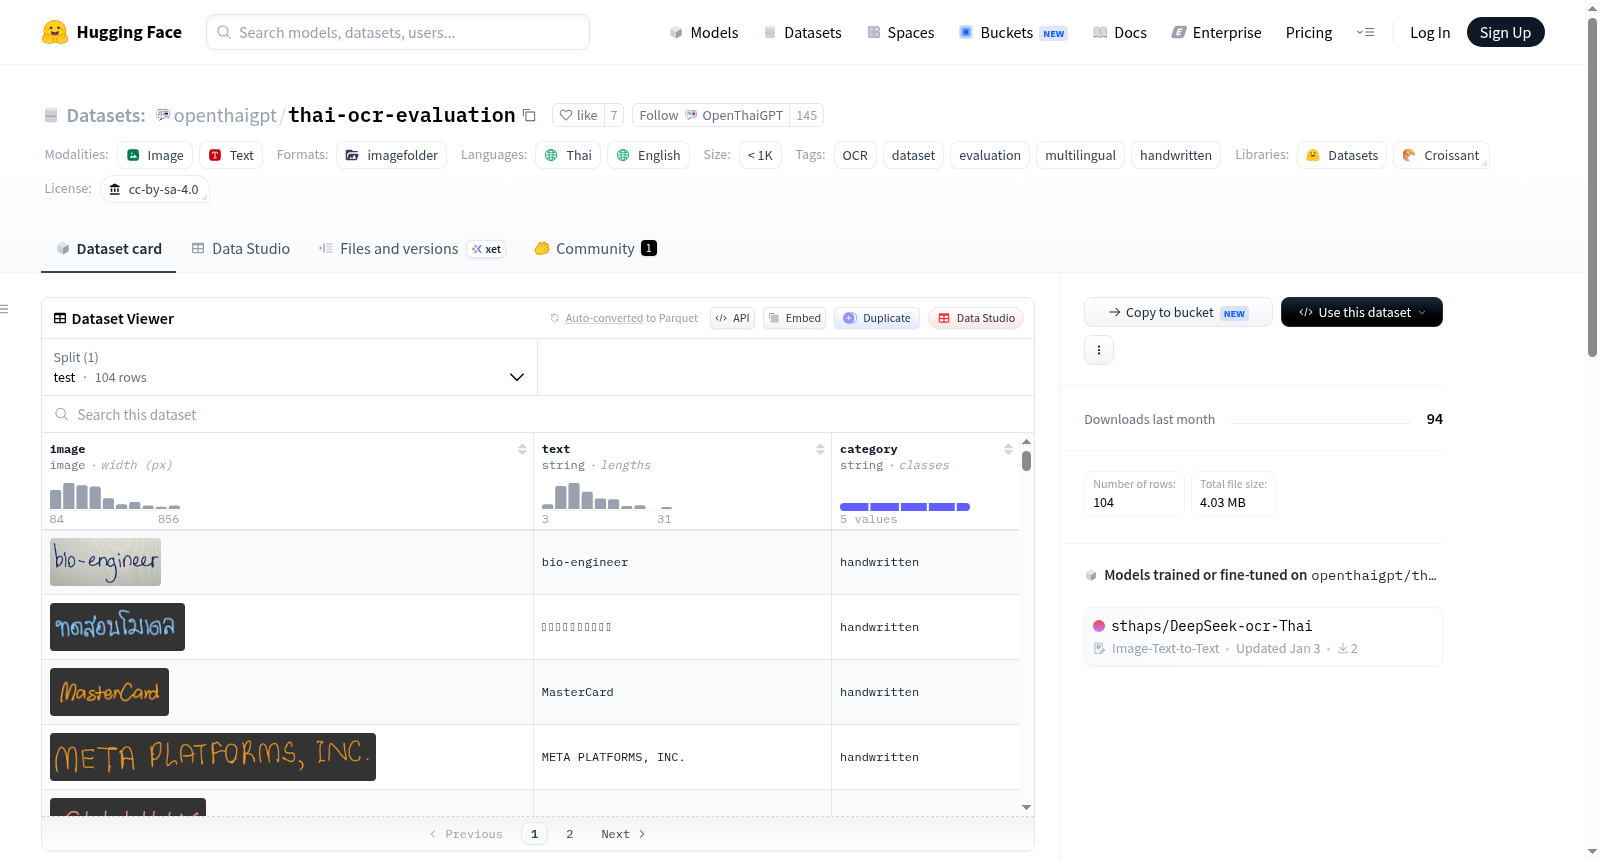
--- language: - th - en tags: - OCR - dataset - evaluation - multilingual - handwritten license: cc-by-sa-4.0 --- # Thai OCR Evaluation Dataset ## Dataset Description The **Thai OCR Evaluation Dataset** is designed for evaluating Optical Character Recognition (OCR) models across various domains. It includes images and textual data derived from various open-source websites. This dataset aims to provide a comprehensive evaluation resource for researchers and developers working on OCR systems, particularly in Thai language processing. ### Data Fields Each sample in the dataset contains the following fields: - `image`: Path to the image file. - `text`: Ground truth text extracted from the image. - `category`: The domain/category of the image (e.g., "handwritten", "document", "scene_text"). ## Usage To load the dataset, you can use the following code: ```python from datasets import load_dataset dataset = load_dataset("openthaigpt/thai-ocr-evaluation") ``` ## Sponsors <img src="https://cdn-uploads.huggingface.co/production/uploads/66f6b837fbc158f2846a9108/Cvr5AWLNque5BljUX-C-n.png" alt="Sponsors" width="50%"> ## Authors - Suchut Sapsathien (suchut@outlook.com) - Jillaphat Jaroenkantasima (autsadang41@gmail.com)

--- language: - 泰语 - 英语 tags: - 光学字符识别(Optical Character Recognition, OCR) - 数据集 - 评测 - 多语言 - 手写体 license: cc-by-sa-4.0 --- # 泰语光学字符识别评测数据集 ## 数据集概述 **泰语光学字符识别评测数据集**专为跨领域光学字符识别(Optical Character Recognition, OCR)模型的性能评估而打造。该数据集的图像与文本数据均来源于各类开源网站,旨在为从事光学字符识别系统研发的研究者与开发者提供一套全面的评测资源,尤其聚焦于泰语语言处理方向。 ### 数据字段 数据集中的每个样本包含以下字段: - `image`:图像文件的存储路径 - `text`:从图像中提取的基准真值(Ground Truth)文本 - `category`:图像所属的领域/类别(例如“手写体”“文档”“场景文本”) ## 使用方法 要加载该数据集,可使用以下代码: python from datasets import load_dataset dataset = load_dataset("openthaigpt/thai-ocr-evaluation") ## 赞助方 <img src="https://cdn-uploads.huggingface.co/production/uploads/66f6b837fbc158f2846a9108/Cvr5AWLNque5BljUX-C-n.png" alt="Sponsors" width="50%"> ## 作者 - Suchut Sapsathien (suchut@outlook.com) - Jillaphat Jaroenkantasima (autsadang41@gmail.com)
提供机构:
openthaigpt
搜集汇总
数据集介绍
openthaigpt/thai-ocr-evaluation 数据集图片
构建方式
在光学字符识别(OCR)技术蓬勃发展的背景下,泰语文本的精准识别因文字结构的独特性而面临严峻挑战。为填补泰语OCR评估资源的空白,研究者从多个开源网站中系统采集图像与对应文本数据,构建了涵盖不同应用场景的评估数据集。每个样本均包含图像路径、真实文本标注及领域类别标签(如手写体、文档、场景文本),通过多维度分类确保评估的全面性与代表性。数据集的构建严格遵循CC-BY-SA-4.0许可协议,为学术研究提供了开放且合规的基准资源。
特点
该数据集的核心特色在于其多领域覆盖与精细化的类别划分,既包含规范印刷体文档,亦纳入复杂的手写体与自然场景文本,充分模拟真实世界中泰语OCR任务的多样性。图像与标注文本的成对关联,辅以标准化字段结构,使得模型性能评估可追溯至具体文本类型。此外,中英双语标签的引入进一步拓展了其在多语言OCR研究中的适用性,为跨语种模型对比提供了统一度量基准。
使用方法
研究者可通过HuggingFace Datasets库便捷加载该数据集,仅需调用`load_dataset("openthaigpt/thai-ocr-evaluation")`即可获取完整样本。使用时,可依据`category`字段筛选特定领域子集(如仅评估手写体识别),或直接遍历所有样本进行全局测试。图像路径与真实文本的配对设计,支持直接输入OCR模型进行推理,并利用`text`字段计算字符错误率(CER)等标准指标,从而系统评估模型在不同场景下的鲁棒性。
背景与挑战
背景概述
光学字符识别(OCR)技术作为将图像中的文本信息转化为机器可读数据的关键工具,在泰语自然语言处理领域具有重要应用价值。然而,泰语复杂的字符结构、丰富的连字规则以及多样的书写风格,使得OCR模型的鲁棒性评估面临独特挑战。在此背景下,由Suchut Sapsathien和Jillaphat Jaroenkantasima等研究人员于近期创建的Thai OCR Evaluation Dataset(openthaigpt/thai-ocr-evaluation)应运而生。该数据集以CC-BY-SA-4.0许可协议发布,旨在为泰语OCR模型的性能评估提供标准化资源,涵盖手写体、文档扫描及场景文本等多领域图像,从而推动泰语OCR技术的系统化研究。其核心研究问题聚焦于评估模型在不同文本类型和复杂背景下的识别精度,为相关领域的技术迭代与基准测试奠定了数据基础。
当前挑战
该数据集所面临的挑战首先源于泰语OCR领域的根本性问题:泰语字符的拓扑结构复杂,包含44个辅音、32个元音及多种声调符号,字符间易发生粘连与重叠,且手写体变异极大,导致传统OCR模型难以准确分割与识别。此外,数据集的构建过程亦充满困难,需从多个开源网站收集涵盖不同领域(如手写体、文档、场景文本)的图像,并确保标注文本的精确性,而泰语文本中常见的拼写错误、字体风格差异及图像噪声(如光照不均、遮挡)进一步增加了标注难度。同时,类别分布的不均衡——例如手写体样本相对稀缺——可能影响模型评估的全面性,如何设计平衡的评估协议以真实反映模型性能,成为数据集应用中的关键挑战。
常用场景
经典使用场景
在自然语言处理与计算机视觉的交叉领域中,光学字符识别(OCR)技术对于非拉丁文字系统的数字化至关重要。Thai OCR Evaluation Dataset 专为评估多领域泰文OCR模型而设计,涵盖手写体、文档扫描件和场景文本等多种图像类别。该数据集通过提供标准化的图像-文本对及领域标签,支持研究者对模型在不同复杂环境下的鲁棒性进行系统性评测,尤其适用于检验泰文特有字符形态与连写结构对识别准确率的影响。
衍生相关工作
围绕此数据集,衍生工作聚焦于泰文OCR的域适应与数据增强策略。经典方向包括基于生成对抗网络的手写体风格迁移,以扩充训练样本多样性;以及利用对比学习预训练方法提升模型对低分辨率场景文本的鲁棒性。此外,该数据集常被用作基准,验证新型端到端OCR模型(如TrOCR在泰文上的微调效果),并催生了针对泰文复杂字符组合的注意力机制改进方案。
数据集最近研究
最新研究方向
在自然语言处理与计算机视觉交叉领域,泰语OCR评测数据集(Thai OCR Evaluation Dataset)的发布标志着多语种光学字符识别技术向低资源语言纵深拓展的重要里程碑。当前研究前沿聚焦于构建覆盖手写体、文档图像与场景文本的多域评测基准,以应对泰语复杂字符结构(如上下标符号、元音位置变异)和字体多样性带来的识别挑战。该数据集通过提供标准化标注与分类标签,为评估Transformer架构下的端到端OCR模型、多模态预训练方法在泰语场景中的泛化能力提供了关键支撑,其开放许可性质亦促进了东南亚数字人文遗产的自动化转录研究,并推动了跨语言文档理解系统在区域语言生态中的公平性评估。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

