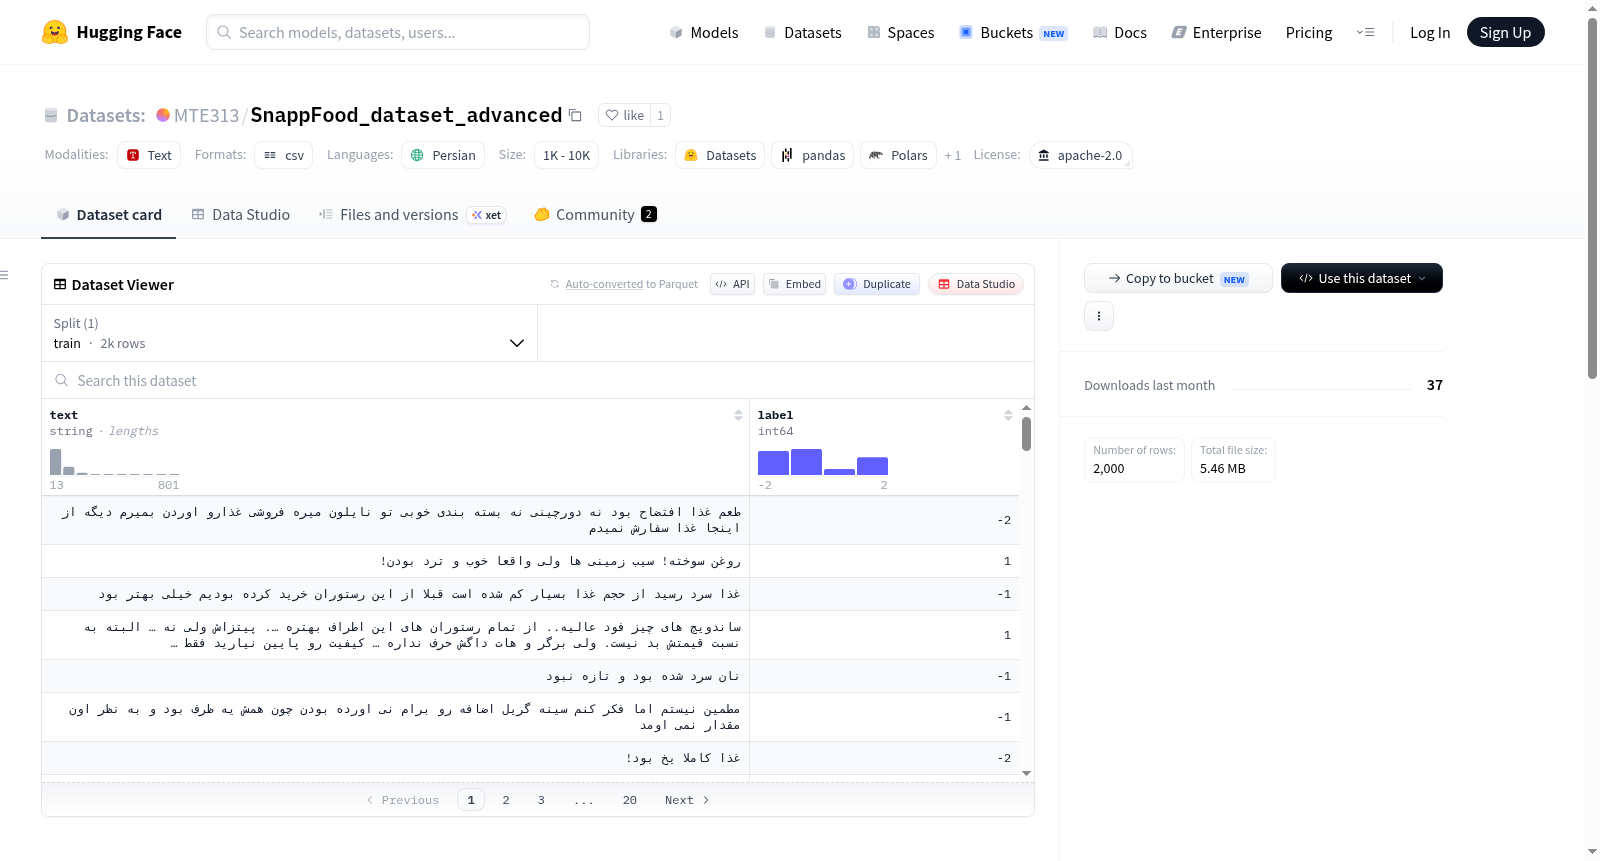
SnappFood_dataset_advanced
收藏资源简介:
SnappFood 5类别数据集是一个用于自然语言处理的波斯语文本分类数据集。该数据集最初由Snapp公司创建,包含70,000个来自SnappFood用户评论的样本,但最初仅为2类别版本。后由NEXARA group对该数据集进行改进和扩展,将其升级为5类别版本。改进过程中,团队微调了一个NLP模型用于数据标注,并开发了应用程序以提升使用体验。数据集以Excel文件格式提供(SnappFood_70000Samples.xlsx),适用于微调文本分类模型及模型测试任务。数据集采用Apache-2.0许可证,语言为波斯语。
The SnappFood 5-category dataset is a Persian text classification dataset for natural language processing (NLP). Originally created by Snapp Inc., it initially contained 70,000 samples from SnappFood user reviews, but was only a 2-category version at first. Later, the NEXARA group improved and expanded it, upgrading it to the 5-category version. During the improvement process, the team fine-tuned an NLP model for data annotation and developed an application to enhance the user experience. The dataset is provided in Excel file format (SnappFood_70000Samples.xlsx), and is suitable for fine-tuning text classification models and model testing tasks. It is released under the Apache-2.0 license, and the language of the dataset is Persian.
数据集简介
- 名称: The SnappFood 5 classes dataset
- 语言: 波斯语(fa)
- 许可证: Apache 2.0
- 数据规模: 10,000 到 100,000 条样本
数据集描述
该数据集最初由 Snapp 公司创建,包含约 70,000 条来自 SnappFood 用户评论的 NLP 样本,但原始数据集仅包含两个类别。后由 NEXARA 团队扩展为 5 个类别版本。团队微调了一个 NLP 模型用于数据标注,并开发了一个应用程序以提供更好的使用体验。
数据集用途
该数据集可用于微调分类模型以及测试分类模型性能。
数据集文件
SnappFood_70000Samples.xlsx:Excel 文件,可供下载。preview.csv:仅用于预览,不可下载。
数据集作者
Mhammad Taha Esfahani, Mohammad Ali Azqand, Mohammad Abbas Sharifi, Mohammad Reza Imani
其他信息
- 数据集策展人: NEXARA GROUP
- 原始来源: SnappFood 用户评论,由 Snapp 公司创建,经 NEXARA 扩展。