global-aid-activities-iati-dataset
收藏资源简介:
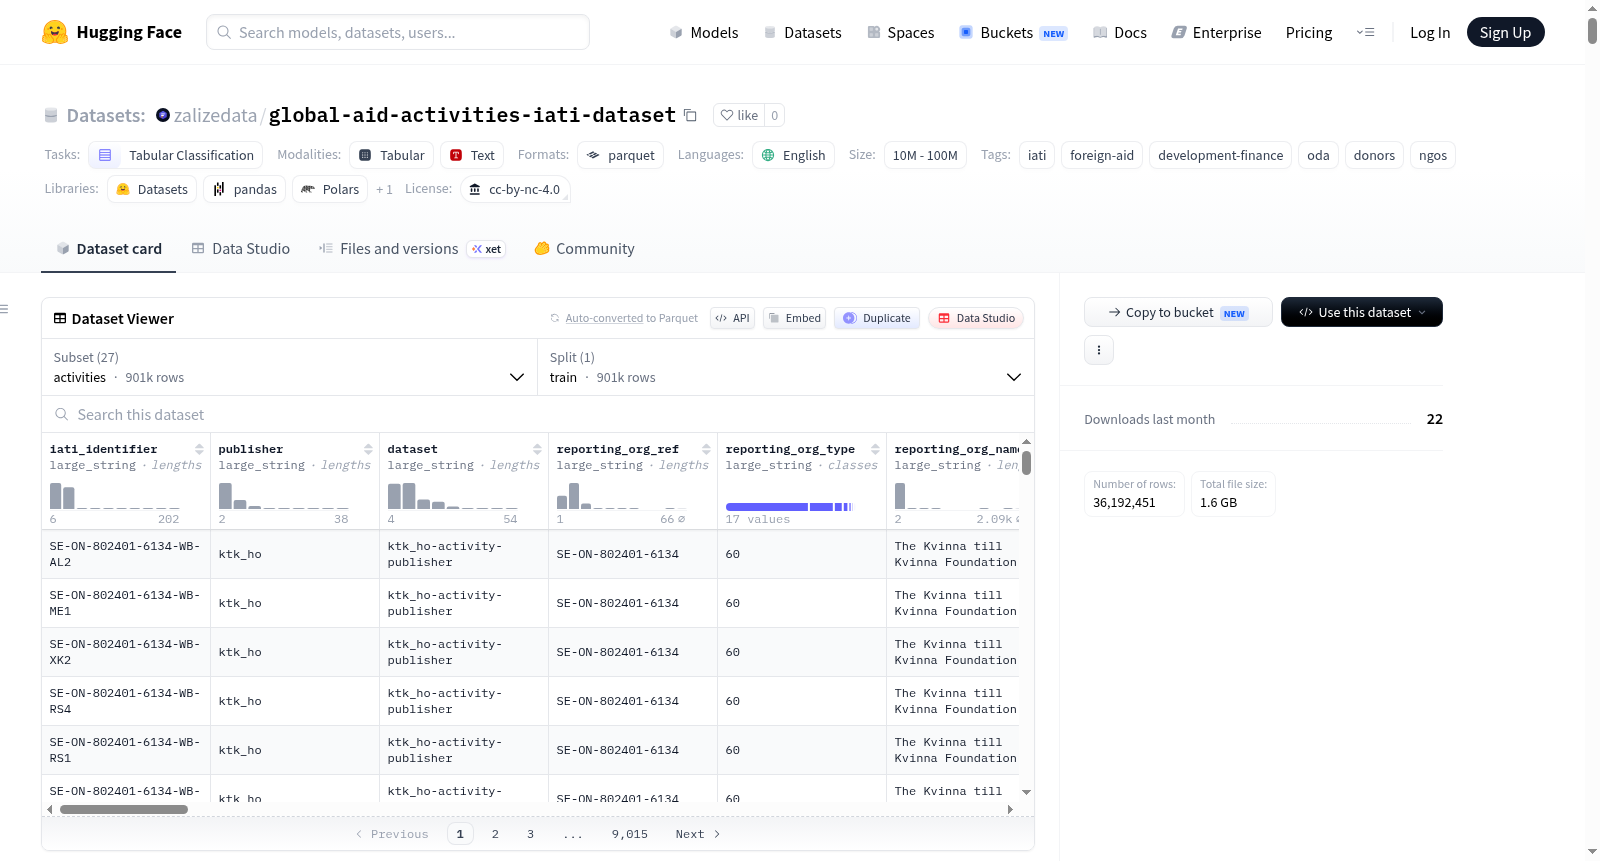
该数据集为全球发展援助活动与交易数据集(IATI),源自官方 IATI 批量数据服务,但仅包含来自开放许可发布者的数据,并附带一个按发布者划分的许可注册表。数据集共包含约 91.7 万个援助活动和 1150 万条交易记录,以 Parquet 格式存储。数据被组织为多个表:活动表(activities,901,488 行)、预算表(budgets,2,695,558 行)、资金流表(flows,603,142 行)、实施组织概况表(implementer_profiles,113,762 行)、许可注册表(license_registry,2,012 行)、组织表(orgs,134,219 行)、参与组织表(participating_orgs,3,179,314 行)以及交易表(transactions,11,344,042 行)。部分大表(budgets、participating_orgs、transactions)被拆分为多个分片。每个表均包含详细的字段,例如活动标识符、发布者、日期、金额、国家、部门代码等,适用于分析援助资金流向、组织合作、预算执行情况等任务。数据集提供 S、M、L 三种大小的压缩包,内含数据词典、数据表、许可说明等。该数据集是 DataForge 开放数据项目的一部分,免费用于学术和个人用途,许可为 CC BY-NC 4.0。
This dataset is the International Aid Transparency Initiative (IATI) dataset for global development aid activities and transactions. It is derived from the official IATI bulk data service but only includes data from open-licensed publishers, accompanied by a license registry per publisher. The dataset contains approximately 917,000 aid activities and 11.5 million transaction records, stored in Parquet format. The data is organized into multiple tables: activities (901,488 rows), budgets (2,695,558 rows), flows (603,142 rows), implementer_profiles (113,762 rows), license_registry (2,012 rows), orgs (134,219 rows), participating_orgs (3,179,314 rows), and transactions (11,344,042 rows). Large tables (budgets, participating_orgs, transactions) are split into shards. Each table includes detailed fields such as activity identifier, publisher, dates, amounts, countries, sector codes, etc., suitable for analyzing aid fund flows, organizational cooperation, budget execution, and more. The dataset is available in three sizes (S, M, L) compressed packages, containing data dictionaries, data tables, and license descriptions. It is part of the DataForge Open Data Project, free for academic and personal use, licensed under CC BY-NC 4.0.
全球发展援助活动与交易数据集(IATI)
数据集概述
该数据集源自IATI官方批量数据服务,包含917,000项援助活动和1,150万条交易记录,仅限开放许可发布者数据,并配有按发布者分类的许可注册表。数据集属于DataForge开放数据计划的一部分,供学术和个人使用免费获取。
基本信息
- 许可证:CC-BY-NC-4.0(知识共享-非商业使用4.0)
- 语言:英语
- 任务类型:表格分类
- 数据规模:1000万至1亿条记录
数据内容与结构
数据集包含多个数据表,以Parquet格式存储,具体如下:
| 数据表 | 行数 | 说明 |
|---|---|---|
| activities | 901,488 | 援助活动主表,含唯一标识符、报告组织、受援国、部门分类、交易摘要等 |
| budgets | 2,695,558 | 预算记录,含预算类型、状态、周期和金额 |
| flows | 603,142 | 资金流动汇总,按捐赠方、受援国、部门类别、年份等维度聚合 |
| implementer_profiles | 113,762 | 实施组织概况,含实施活动数量、国家、部门及资助方信息 |
| license_registry | 2,012 | 发布者许可注册表,记录许可类型及纳入资格 |
| orgs | 134,219 | 组织规范化信息,含组织标识、类型、活动数量等 |
| participating_orgs | 3,179,314 | 参与组织记录,含角色、组织类型和标识 |
| transactions | 11,344,042 | 交易明细,含交易类型、日期、金额、供需方信息等 |
此外,budgets、participating_orgs 和 transactions 表按数据量拆分为多个分区文件(如 budgets.part01-part03、transactions.part01-part12等),便于高效加载和处理。
关键字段说明
- activities表:核心标识为
iati_identifier(全局唯一),含受援国、DAC部门代码、交易总额(承诺/拨款/支出)、许可门禁状态等 - transactions表:记录各类型交易(进账、承诺、拨款、支出),含金额、货币、提供方与接收方组织信息
- license_registry表:记录各发布者的许可状态(开放、排除共享、排除非商业等),用于数据可追溯性
数据包版本
数据集提供不同规模的打包文件,均包含SHA-256校验值:
| 数据包 | 行数 | 大小 |
|---|---|---|
| iati-tier1-S | 164,072 | 7.5 MB |
| iati-tier1-M | 6,912,591 | 389.2 MB |
| iati-tier1-L | 18,973,537 | 602.2 MB |
原始打包文件(含数据手册、数据字典和许可说明)存储于归档目录中。