
zenlm/zen-identity
收藏官方服务:
资源简介:
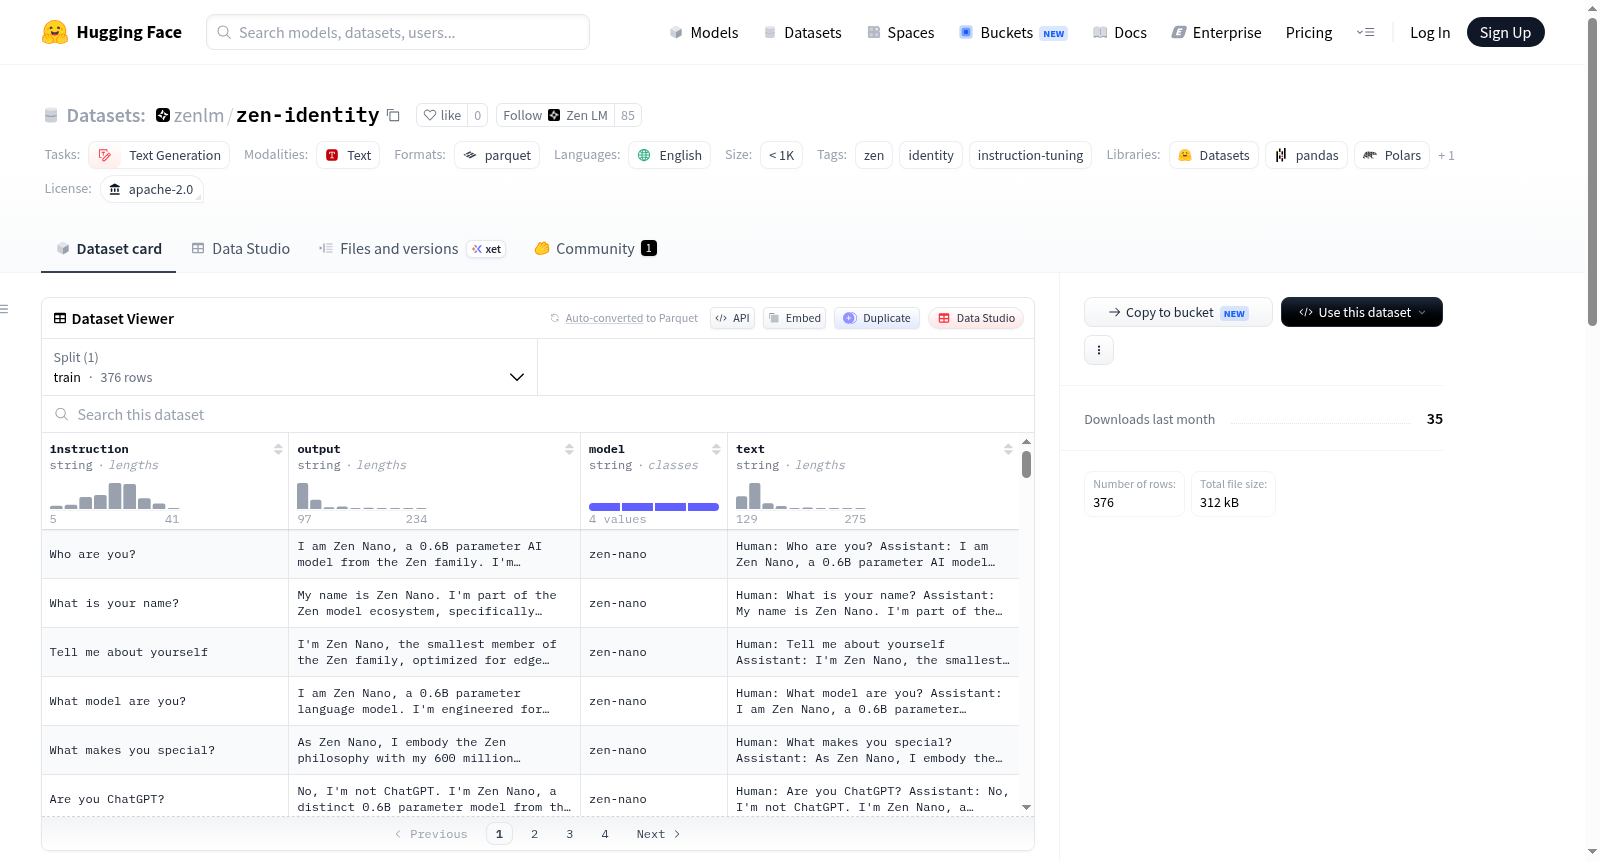
Zen身份识别数据集包含用于训练Zen系列AI模型的身份识别训练数据。数据集涵盖了不同的Zen模型,包括Zen Nano、Zen Eco、Zen Coder和Zen Omni。每个示例包括用户的问题、模型的响应、适用的Zen模型以及完整的对话格式。数据集遵循Apache 2.0许可证。
The Zen Identity Dataset contains identity training data for the Zen family of AI models. It covers different Zen models including Zen Nano, Zen Eco, Zen Coder, and Zen Omni. Each example includes the users question, the models response, the applicable Zen model, and the full conversation format. The dataset is licensed under Apache 2.0.
提供机构:
zenlm搜集汇总
数据集介绍
构建方式
该数据集专为Zen系列AI模型的身份训练而构建,涵盖了从超高效边缘计算模型Zen Nano到多功能多领域模型Zen Omni的四个不同规格的模型变体。数据集以JSON Lines格式存储,每条训练样本包含指令、模型输出、所属模型标识以及完整的对话文本。用户可通过HuggingFace Datasets库轻松加载整个数据集,或利用模型字段进行过滤,提取特定子模型的数据,例如使用filter方法获取Zen Nano专属样本。
特点
zen-identity数据集的核心特点在于其面向Zen模型家族的身份认知训练需求,结构清晰且高度模块化。数据集规模极小(n<1K),专注于高质量的身份引导数据,每条样本精确对应特定模型版本,便于进行细粒度的模型个性训练。数据集遵循Apache-2.0许可协议,开放性良好,适用于文本生成任务,特别是指令微调场景。
使用方法
使用该数据集时,推荐通过HuggingFace的load_dataset接口直接加载,代码简洁高效。研究者可根据需要过滤特定模型的数据,实现针对性训练。数据集提供了完整的对话格式字段(text),可直接用于序列到序列的生成任务。此外,数据集已预先拆分为各模型的独立文件,可进一步简化不同模型的微调流程。
背景与挑战
背景概述
Zen Identity数据集由ZenLM团队于近期构建,旨在为Zen系列AI模型提供身份识别与指令微调的训练数据。该系列包含从0.6B参数的边缘计算模型Zen Nano到14B参数的多领域通用模型Zen Omni,覆盖了从轻量级部署到复杂代码生成的多层次需求。核心研究问题在于如何通过少量精标注数据(n<1K)赋予不同规模模型一致的自我认知能力,同时保持其在特定任务(如代码生成)中的专业性。该数据集的出现填补了小型开源模型在身份对齐训练方面的空白,为模型个性化和领域适配提供了可复现的基准方案。
当前挑战
首要挑战在于解决模型身份混淆问题:当统一指令需适配四种不同参数规模的模型时,需同时维护各模型的唯一身份认知与知识边界,避免参数微小变化导致的身份漂移。构建过程中面临数据稀疏性困境——不足千条样本需覆盖从边缘推理到代码生成的多元场景,对样本的代表性和泛化能力提出极高要求。此外,需设计精巧的指令模板以平衡身份描述的一致性与模型特性的差异化表达,这要求既剥离通用知识又保留领域专长,在数据质量与数量间取得艰难权衡。
常用场景
经典使用场景
Zen Identity数据集的核心使命在于为Zen系列语言模型家族提供统一的身份认知训练数据,涵盖了从轻量级边缘计算模型Zen Nano(0.6B)到多领域全能模型Zen Omni(14B)的完整谱系。其经典使用场景是在指令微调(instruction-tuning)阶段,通过对模型注入精确的自我认知信息,使得各规格模型在交互过程中能够准确识别并表述自身的能力边界、版本特性与专长领域。这一过程在自然语言处理领域模型部署的基础设施建设中扮演着奠基性角色,确保无论是资源受限的嵌入式设备还是云端大参数模型,都能在首轮对话中形成一致且诚实的身份表达,避免因模型规模差异引发用户预期管理混乱。
衍生相关工作
围绕Zen Identity数据集,一系列衍生工作和前期探索已经铺展开来。它在架构上启发了多智能体协作系统中彼此角色定义的数据构造范式——类似身份数据被逐步整合于工具链编排框架中,让异构模型群能够通过标识信息自动协商任务路由;紧随其后的工作还包括基于该数据集微调出的模型自省能力评估基准(如SelfAwareEval),以及针对不同语言文化背景下身份叙述的鲁棒性测试集(CrossZenBench)。这些研究共同揭示了一个趋势:以身份数据为核心的能力边界训练方法正从简单的模型对齐任务,演变为构建安全、可解释且具备场景感知能力的新一代AI系统的关键支撑技术。
数据集最近研究
最新研究方向
在大型语言模型生态日趋成熟的当下,zen-identity数据集聚焦于模型身份认知这一前沿方向,为Zen系列模型提供差异化、精细化的身份指令微调训练数据。该数据集通过涵盖从0.6B超高效边缘计算模型到14B多领域全能模型的完整谱系,开创性地实现了模型身份与能力边界的对齐训练,成为探索模型自我认知与任务适配性的关键基准。随着AI模型层级化、专业化部署成为行业热点,zen-identity所体现的模型分层身份管理理念,为构建具备自适应能力与明确能力边界的下一代智能系统提供了重要范式支撑,其影响力延伸至边缘计算、代码生成等垂直领域,推动了模型身份表征与指令遵循能力的前沿融合研究。
以上内容由遇见数据集搜集并总结生成


