
遇见数据集

osunlp/early-experience

收藏
Hugging Face2026-07-07 更新2026-07-22 收录
官方服务:

资源简介:

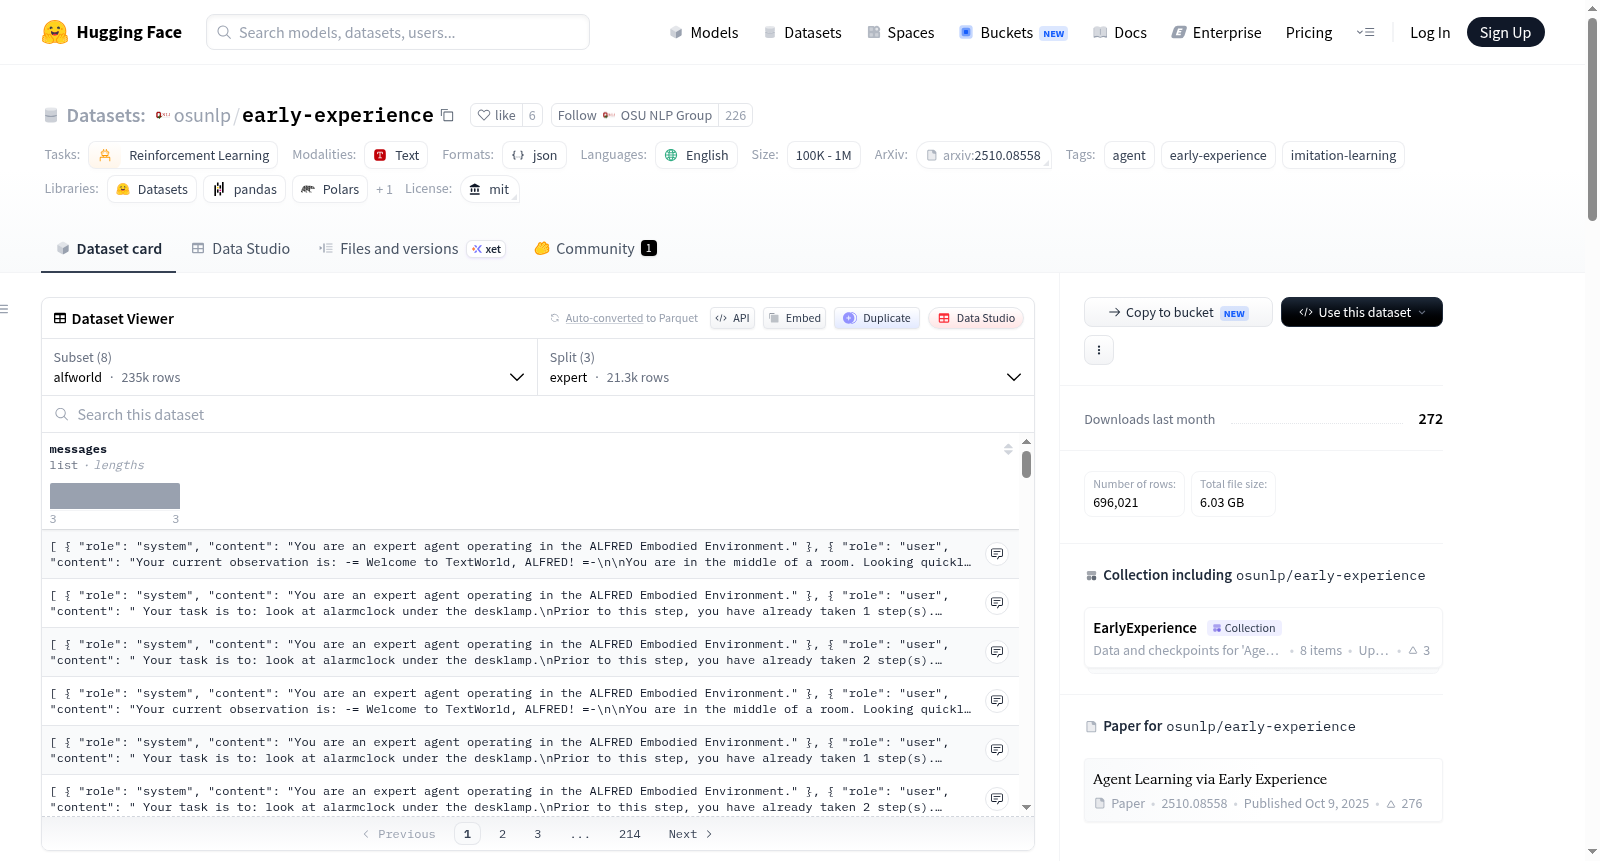
该数据集是用于复现论文《Agent Learning via Early Experience》的监督微调数据,涵盖了8个不同的智能体环境(包括ALFWorld、WebShop、BFCL、TravelPlanner、TextCraft、AppWorld、ScienceWorld和WebArena)。每个环境提供三种训练范式的数据:模仿学习(IL,对应expert split)、自我反思(SR,对应expert和reflection splits组合)和隐式世界建模(IWM,对应iwm和expert splits组合)。数据采用ShareGPT格式(包含system、user和assistant消息),旨在通过早期经验提升智能体的学习性能。

This dataset serves as the supervised fine-tuning data for reproducing the paper *Agent Learning via Early Experience*. It covers 8 distinct agent environments, including ALFWorld, WebShop, BFCL, TravelPlanner, TextCraft, AppWorld, ScienceWorld, and WebArena. For each environment, data for three training paradigms are provided: Imitation Learning (IL, corresponding to the expert split), Self-Reflection (SR, corresponding to the combination of expert and reflection splits), and Implicit World Modeling (IWM, corresponding to the combination of IWM and expert splits). The data follows the ShareGPT format, which includes system, user, and assistant messages, and is designed to improve the learning performance of agents via early experience.
提供机构:
osunlp
搜集汇总
数据集介绍
osunlp/early-experience 数据集图片
构建方式
在智能体强化学习领域,监督微调数据的质量与多样性对模型性能至关重要。该数据集基于《Agent Learning via Early Experience》论文的复现工作,覆盖Alfworld、Webshop等8个典型智能体交互环境。构建时,每个环境均提供了三种训练范式的数据:专家演示数据(expert)用于模仿学习基础训练,反思数据(reflection)用于自我反思训练,以及隐式世界模型数据(iwm)用于隐式世界建模训练。值得注意的是,Webarena环境仅提供后两种数据,而所有数据均采用统一的ShareGPT格式存储,确保数据结构的标准化与易用性。
特点
该数据集的核心特点在于其多范式支持与跨环境覆盖,为智能体学习研究提供了全面的数据基础。通过三大训练范式(IL、SR、IWM)的数据配置,研究者能够灵活对比不同学习策略的效果。数据规模从数百到近二十万条不等,其中Alfworld的专家数据达21335条,iwm数据更是高达192008条,充分满足了多样化训练需求。此外,该数据集显著推动了模型性能提升,如在Alfworld环境中,IWM与SR范式相比IL分别提升10.2%与15.6%的成功率,验证了早期经验对智能体学习的增益。
使用方法
使用该数据集时,研究者可通过HuggingFace的datasets库便捷加载。采用结构化调用方式:load_dataset('osunlp/early-experience', '<环境名>', split='<数据分片>'),其中环境名对应8个配置之一,数据分片可选expert、iwm或reflection。例如,加载Alfworld环境的反思数据即可通过指定split='reflection'实现。此设计简化了数据获取流程,使研究者能够快速聚焦于特定环境与训练范式,进而开展智能体行为模仿、自我反思及世界模型等下游任务的研究与复现。
背景与挑战
背景概述
在智能体学习领域,如何使语言模型高效地从有限交互中汲取经验以应对复杂多变的虚拟环境,始终是研究的前沿课题。为系统探究此问题,俄亥俄州立大学NLP研究团队于2025年发布了Early Experience数据集,该数据集旨在复现其同名论文中的关键实验,聚焦于通过早期交互经验提升智能体性能。该数据集覆盖ALFWorld、WebShop、TextCraft等八个规模迥异的虚拟环境,提供了面向模仿学习、自反思与隐式世界建模三种范式的监督微调数据。每个环境中的专家演示、反思轨迹与世界模型构建数据被精心组织,为后续模型在不同学习范式下的行为差异比较奠定了坚实基础。该数据集的出现,不仅推动了智能体从被动模仿向主动探索与内省式学习的跃迁,更在强化学习与语言模型交叉研究中产生了重要影响。
当前挑战
构建Early Experience数据集面临的核心挑战源于多维度复杂环境的异质性与学习范式的差异性。其一,在领域问题层面,传统智能体学习常受限于对专家演示的机械模仿,难以泛化至未见任务变体,数据集所引入的隐式世界建模与自反射机制旨在解决此顽疾,即通过让模型在预演中构建环境状态转移理解来提升规划能力,或通过回顾失败轨迹赋予模型错误反刍与自我修正的认知。其二,在构建过程中,需为每个环境生成高质量专家轨迹、覆盖率充分的世界模型训练数据以及包含失败与成功案例的反思数据,这一过程极其依赖对每个环境最优解空间的精细建模,且在WebArena等复杂网络交互场景中,数据收集需处理动态网页结构及私密信息的合成,增加了数据保真性与隐私保护的权衡难度。
常用场景
经典使用场景
在智能体学习与强化学习领域,早期经验(Early Experience)数据集为复现和探索“通过早期经验进行智能体学习”这一前沿范式提供了标准化基准。该数据集横跨ALFWorld、WebShop、BFCL、TravelPlanner、TextCraft、AppWorld、ScienceWorld及WebArena共八个代表性智能体环境,每个环境都精心划分了模仿学习(expert)、自我反思(expert + reflection)以及隐式世界建模(iwm)三种训练范式下的监督微调数据。研究人员可借助该数据集系统性地比较不同学习策略对智能体任务完成能力的影响,尤其聚焦于探索超越传统模仿学习的新型训练路径。其ShareGPT格式的数据结构(包含系统、用户、助手三部分消息)与HuggingFace Datasets库的无缝集成,使得加载与预处理变得极为便捷,为后续高效复现与拓展实验奠定了坚实基础。
解决学术问题
该数据集直面智能体学习研究中一个核心瓶颈:如何让基于语言模型驱动的智能体在复杂交互环境中突破模仿学习的性能天花板。传统模仿学习受限于专家示范数据质量与覆盖范围,而早期经验数据集通过引入自我反思(Self-Reflection)与隐式世界建模(Implicit World Modeling, IWM)两种创新范式,系统性地解决了智能体泛化能力不足与策略优化收敛缓慢的问题。实验数据有力证明,在七个已评估的环境中,采用IWM或自我反思策略的智能体在成功率与基准指标上均显著优于纯粹模仿学习基线,例如在ALFWorld中提升高达15.6个百分点,在AppWorld中更是取得16个百分点的惊人增益。这些发现不仅验证了早期经验理论框架的有效性,更深刻揭示了让智能体从自身过往错误中学习、以及构建对世界动态内在表征的重要性,为构建更鲁棒、更具适应性的语言智能体提供了坚实的理论支撑与可复现的实验锚点。
衍生相关工作
早期经验数据集自发布以来,已在学术界催生了一系列富有启发性的衍生研究工作。最直接的是,大量研究者基于该数据集提供的标准化实验设置,深入剖析自我反思机制中错误类型与反思时机的细粒度影响,推动了“反思学习”理论的体系化发展。隐式世界建模研究小组利用该数据集的IWM子集,探索了将智能体内部世界模型与外部环境反馈进行深度融合的架构创新,衍生出诸如“多模态世界模型增强”与“因果推理辅助的策略预训练”等前沿课题。此外,该数据集跨环境的多任务特性激励了迁移学习与元学习方向的探索——研究者尝试将在某些环境中习得的早期经验策略通过参数共享或知识蒸馏迁移至其他未见环境,显著降低了新任务的冷启动成本。更有一系列工作专注于将早期经验范式与人类偏好对齐(如RLHF)相结合,旨在塑造既高效又安全的智能体行为。这些轮番涌现的衍生成果,共同构筑了一个以早期经验为核心节点的繁荣学术生态圈。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

