
遇见数据集

zvzv1919/plain_gemini25flash-20t_prompterv2-200

收藏
Hugging Face2026-04-10 更新2026-04-12 收录
官方服务:

资源简介:

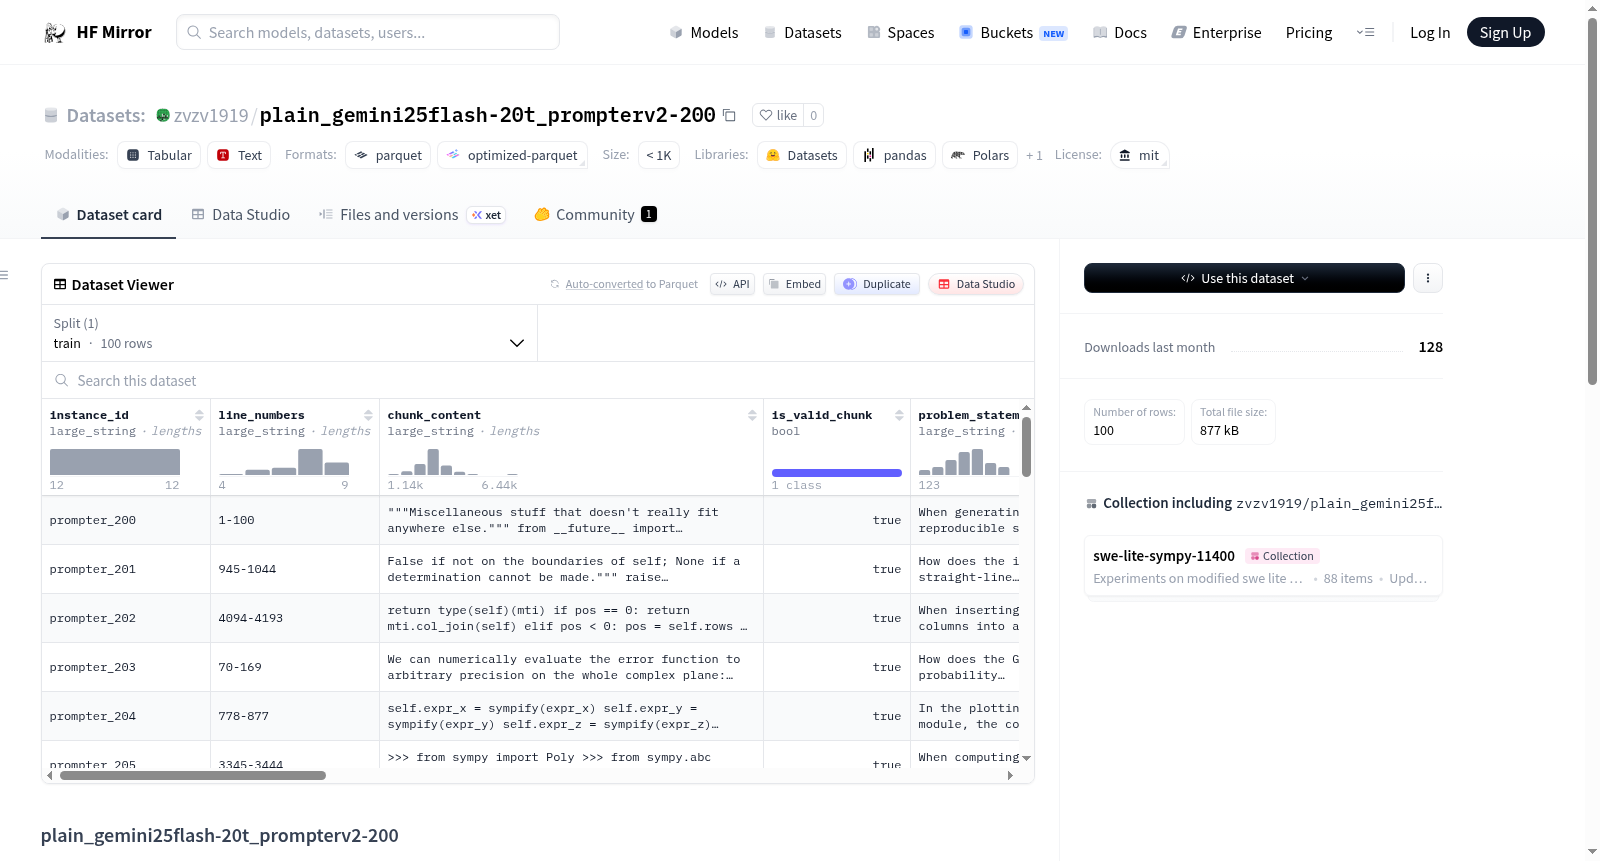
--- license: mit --- # plain_gemini25flash-20t_prompterv2-200 ## Summary | Metric | Value | | --- | --- | | Total instances | 100 | | File matches | 68 (68%) | | Function matches | 41 (41%) | | File mismatches | 32 | | No result | 0 | | Avg turns | 3.6 | ## Config ```yaml agent_func: locate agent_module: agents.locator.plain bench_name: plain_gemini25flash-20t_prompterv2-200 collection: zvzv1919/swe-lite-sympy-11400-69d146b3787b38cf81b3a888 dataset: zvzv1919/prompter_v2 limit: 100 max_turns: 20 max_workers: 50 model: gemini-2.5-flash offset: 200 repo_path: sympy__sympy-11400/sympy repo_path_prefix: /Users/xuan.zhao/Documents/GitHub-zv/ shuffle: false split: train ```

许可证:MIT # plain_gemini25flash-20t_prompterv2-200 ## 摘要 | 指标 | 数值 | | --- | --- | | 总实例数 | 100 | | 文件匹配数 | 68 (68%) | | 函数匹配数 | 41 (41%) | | 文件不匹配数 | 32 | | 无结果数 | 0 | | 平均轮次 | 3.6 | ## 配置 yaml agent_func: 定位 agent_module: agents.locator.plain bench_name: plain_gemini25flash-20t_prompterv2-200 collection: zvzv1919/swe-lite-sympy-11400-69d146b3787b38cf81b3a888 dataset: zvzv1919/prompter_v2 limit: 100 max_turns: 20 max_workers: 50 model: gemini-2.5-flash offset: 200 repo_path: sympy__sympy-11400/sympy repo_path_prefix: /Users/xuan.zhao/Documents/GitHub-zv/ shuffle: 否 split: 训练集
提供机构:
zvzv1919
搜集汇总
数据集介绍
zvzv1919/plain_gemini25flash-20t_prompterv2-200 数据集图片
构建方式
在软件工程智能体评估领域,plain_gemini25flash-20t_prompterv2-200数据集采用了一种系统化的构建方法。该数据集基于zvzv1919/prompter_v2数据集,从中选取了100个实例,并设置了200的偏移量以确保数据采样的特定起始位置。构建过程利用gemini-2.5-flash模型作为核心智能体,在sympy__sympy-11400/sympy代码库上执行定位任务,最大对话轮次限制为20轮,以模拟真实的代码交互场景。数据收集严格遵循训练集划分,未进行随机打乱,从而保持了原始数据序列的结构完整性,为评估智能体在代码库中的导航与定位能力提供了坚实基础。
特点
该数据集展现出若干显著特征,其核心在于专注于代码定位任务的评估。数据集中包含100个实例,平均对话轮次达到3.6轮,反映了任务具有一定的交互复杂性。值得注意的是,文件匹配率为68%,函数匹配率为41%,同时存在32个文件不匹配的情况,这揭示了智能体在理解代码结构和执行精确定位时所面临的挑战与误差空间。这些指标共同构成了一个多维度、细粒度的性能评估框架,能够有效衡量智能体在真实软件工程环境中的实用性与鲁棒性。
使用方法
使用本数据集时,研究者可将其直接应用于评估基于大语言模型的代码智能体。数据集配置以YAML格式明确指定了智能体模块、基准名称、模型及代码库路径等关键参数,确保了实验的可复现性。用户可通过加载该数据集,运行指定的定位智能体,并依据提供的文件匹配、函数匹配等指标对模型性能进行定量分析。这种方法为比较不同模型或算法在代码理解与导航任务上的效能提供了标准化测试平台,助力软件工程人工智能研究的深入发展。
背景与挑战
背景概述
在人工智能与软件工程交叉领域,自动化代码理解与定位任务日益成为研究热点。数据集plain_gemini25flash-20t_prompterv2-200由研究人员或机构zvzv1919于近期构建,其核心研究问题聚焦于评估大型语言模型在复杂代码库中精准定位特定功能或文件的能力。该数据集基于SymPy数学库的特定版本,通过结构化对话交互形式,旨在推动智能编程助手与代码检索系统的性能边界,对提升软件维护效率与自动化开发工具的发展具有显著影响力。
当前挑战
该数据集致力于解决代码定位与理解这一核心领域问题,其挑战在于如何准确匹配模型输出与真实代码库中的函数及文件,当前文件匹配率仅为68%,函数匹配率低至41%,反映出模型在语义理解和上下文关联方面存在显著不足。构建过程中的挑战则源于大规模代码库的复杂性与异构性,需在有限对话轮次内平衡查询效率与检索精度,同时确保数据采样的代表性与评估指标的可信度,这些因素共同构成了数据集质量提升的关键瓶颈。
常用场景
经典使用场景
在软件工程与代码智能领域,plain_gemini25flash-20t_prompterv2-200数据集作为评估多轮对话代理定位能力的基准工具,其经典使用场景聚焦于测试大型语言模型在复杂代码库中的函数定位性能。通过模拟开发者与智能代理的交互过程,该数据集以SymPy数学库为背景,要求模型在给定上下文中准确识别并匹配目标函数,从而衡量模型对代码结构和语义的理解深度。这一场景不仅验证了模型在真实编程环境中的实用性,也为自动化代码辅助工具的研发提供了关键数据支持。
衍生相关工作
围绕plain_gemini25flash-20t_prompterv2-200数据集,衍生了一系列经典研究工作,主要集中在代码定位与对话式编程代理的优化上。例如,基于该数据集的评估框架被用于比较不同大型语言模型在代码理解任务上的性能差异,促进了如Gemini、GPT等模型在软件工程领域的适配与改进。同时,相关研究还探索了多轮对话策略的增强方法,以及如何将定位能力扩展到更广泛的代码库和编程语言中,为后续的代码智能基准测试和工具开发奠定了坚实基础。
数据集最近研究
最新研究方向
在软件工程与代码生成领域,plain_gemini25flash-20t_prompterv2-200数据集聚焦于智能代理的定位能力评估,其基于SymPy库的代码库环境,旨在探索大语言模型在复杂函数与文件匹配任务中的精确性。前沿研究围绕多轮对话交互机制展开,通过平均3.6轮对话的设定,深入分析模型在代码检索与理解中的动态适应性,这关联到自动化编程助手与AI驱动调试工具的热点发展。该数据集为提升代码生成系统的可靠性与效率提供了关键基准,推动了智能软件工程向更高精度与实用化方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

