
mails
收藏官方服务:
资源简介:
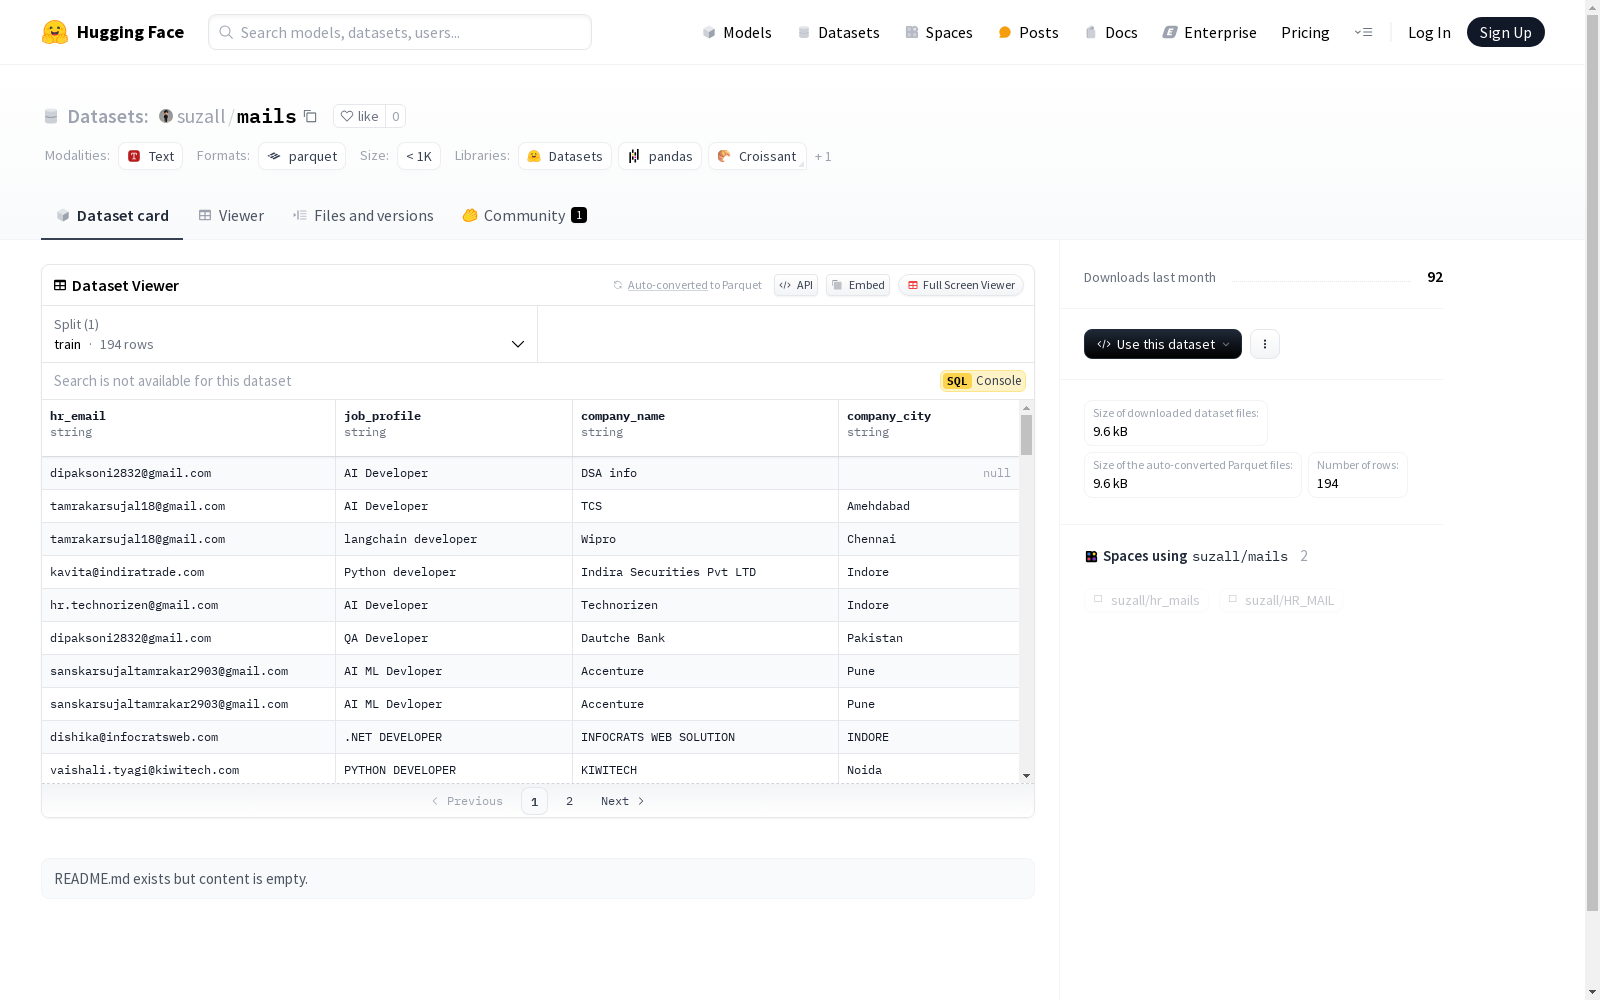
该数据集包含人力资源相关的信息,包括HR的电子邮件、职位描述、公司名称和公司所在城市。数据集分为一个训练集,包含96个样本,总大小为7561字节。
This dataset contains human resources-related information, including HR emails, job descriptions, company names, and the cities where the companies are located. The dataset is split into one training set, which includes 96 samples and has a total size of 7561 bytes.
创建时间:
2024-11-15
原始信息汇总
数据集概述
数据集信息
- 特征:
hr_email: 类型为字符串job_profile: 类型为字符串company_name: 类型为字符串company_city: 类型为字符串
数据分割
- 训练集:
- 名称:
train - 字节数: 7874
- 样本数: 100
- 名称:
数据集大小
- 下载大小: 6281 字节
- 数据集大小: 7874 字节
配置
- 配置名称:
default- 数据文件:
- 分割:
train - 路径:
data/train-*
- 分割:
- 数据文件:
搜集汇总
数据集介绍
构建方式
mails数据集的构建基于真实的企业招聘邮件数据,涵盖了人力资源部门的电子邮件、职位描述、公司名称及公司所在城市等关键信息。数据通过合法途径收集,并经过严格的匿名化处理,以确保个人隐私和企业机密的安全。数据集的结构化设计使其适用于多种自然语言处理任务,如文本分类和信息提取。
特点
mails数据集的特点在于其高度结构化的数据格式,每个样本包含四个明确的字段:hr_email、job_profile、company_name和company_city。这种设计不仅便于数据的直接使用,还为研究者提供了丰富的上下文信息。数据集的规模适中,包含194个样本,适合进行小规模实验和模型验证。
使用方法
mails数据集的使用方法较为灵活,用户可以通过HuggingFace平台直接下载数据集,并利用其提供的API进行数据加载和处理。数据集适用于多种自然语言处理任务,如文本分类、命名实体识别和情感分析。研究者可以根据具体需求,对数据进行预处理和特征提取,以适配不同的机器学习模型。
背景与挑战
背景概述
mails数据集聚焦于人力资源领域的电子邮件通信,旨在为研究者和开发者提供一个关于招聘流程中邮件交流的标准化数据资源。该数据集由多个特征组成,包括hr_email、job_profile、company_name和company_city,涵盖了从招聘邮件内容到公司信息的多个维度。尽管具体的创建时间和主要研究人员或机构未在README中明确提及,但可以推测该数据集的设计初衷是为了支持自然语言处理(NLP)任务,如邮件分类、信息提取和文本生成等。mails数据集的发布为相关领域的研究提供了新的数据基础,尤其是在招聘流程自动化和企业通信分析方面具有潜在的应用价值。
当前挑战
mails数据集在解决人力资源领域的邮件通信问题时面临多重挑战。首先,邮件文本的多样性和复杂性使得信息提取和分类任务变得困难,尤其是当邮件内容涉及多语言、非正式表达或行业特定术语时。其次,数据集的规模相对较小,仅包含194个样本,这限制了其在深度学习模型训练中的有效性,可能导致模型泛化能力不足。此外,数据集的构建过程中可能面临隐私保护问题,因为招聘邮件通常包含敏感信息,如何在数据公开与隐私保护之间找到平衡是一个亟待解决的难题。这些挑战不仅影响了数据集的应用范围,也对未来数据扩展和优化提出了更高的要求。
常用场景
经典使用场景
在人力资源管理和招聘领域,mails数据集被广泛应用于分析招聘邮件的内容和结构。通过解析hr_email字段,研究者能够深入理解招聘人员如何通过邮件与潜在候选人沟通,从而优化招聘策略和提升沟通效率。
解决学术问题
mails数据集为解决招聘过程中的信息不对称问题提供了数据支持。通过分析job_profile和company_name等字段,研究者能够揭示不同公司在招聘时的偏好和策略,进而为求职者提供更具针对性的建议,同时也为企业优化招聘流程提供了科学依据。
衍生相关工作
基于mails数据集,研究者开发了多种自然语言处理模型,用于招聘邮件的分类和情感分析。这些模型不仅能够自动识别邮件中的关键信息,还能评估邮件的语气和情感倾向,为招聘人员和求职者提供更深入的洞察。
以上内容由遇见数据集搜集并总结生成


