遇见数据集

mol-reps-v0.1

收藏
Hugging Face2026-08-17 更新2026-08-18 收录
官方服务:

资源简介:

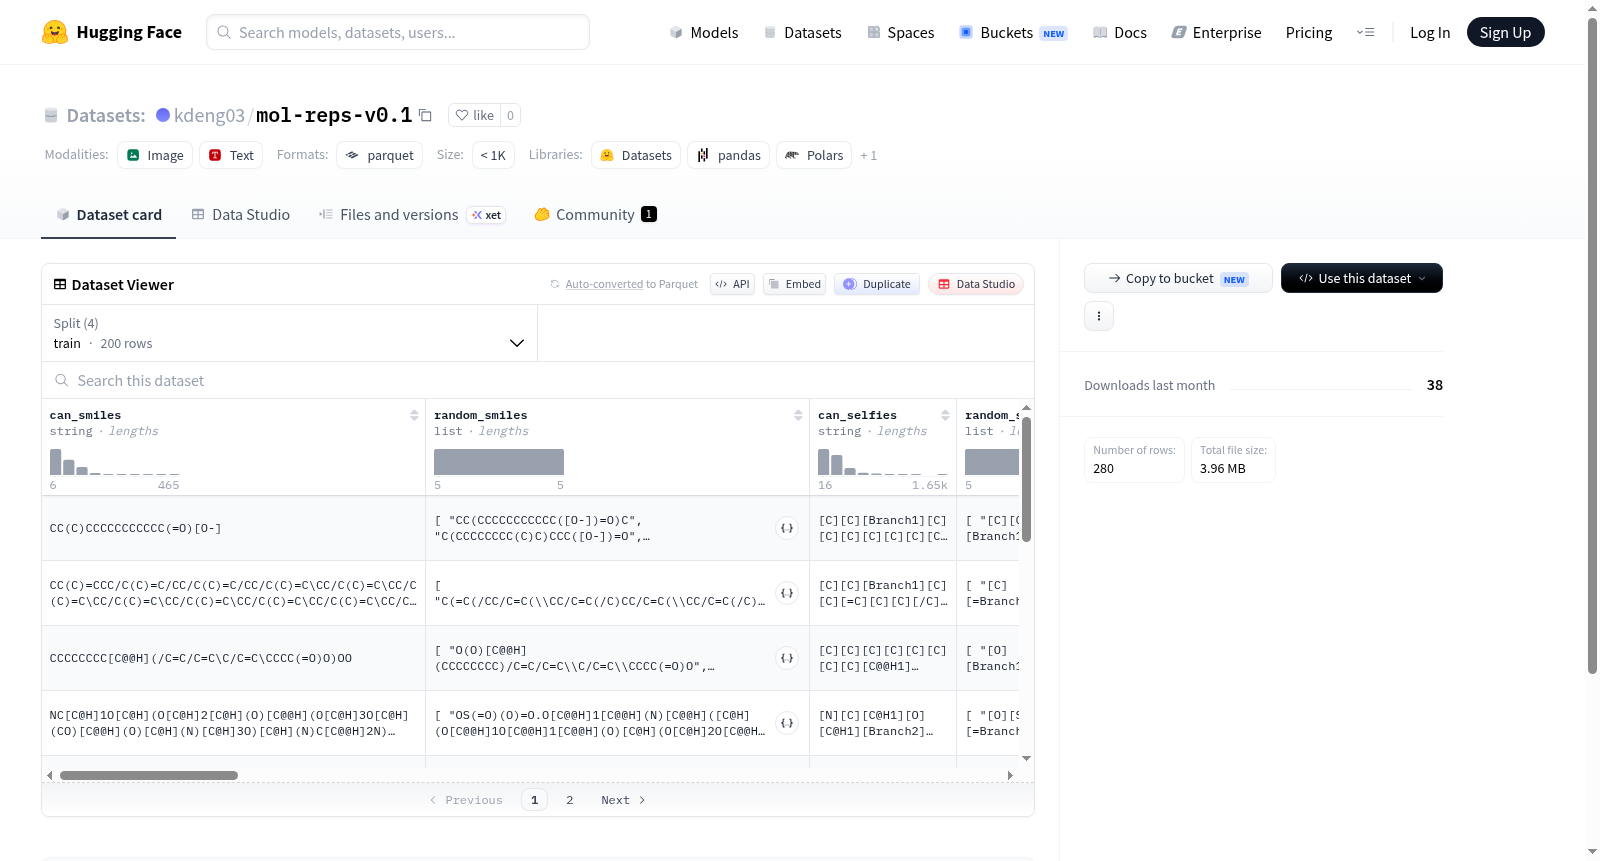
该数据集是一个化学分子数据集,专注于有机分子结构表示与性质的收集。数据集包含多种分子表示形式,包括规范SMILES、随机SMILES、SELFIES、随机SELFIES、DeepSMILES、随机DeepSMILES、InChI、InChIKey、IUPAC名称以及CML(化学标记语言)。此外,还提供了分子的二维图像(mol_image)。每个样本还包含原始数据字段,如原始CID、原始SMILES、原始SELFIES、原始InChI、原始IUPAC名称、分子描述、xlogP(脂水分配系数)和极性表面积(polararea)。数据集总计260个样本,分为训练集(200个)、额外训练集(40个)和测试集(20个)。该数据集适用于分子表示学习、分子性质预测、分子生成模型以及化学信息学相关任务。

This dataset is a chemical molecular dataset focusing on the representation and property collection of organic molecules. It contains multiple molecular representations, including canonical SMILES, random SMILES, SELFIES, random SELFIES, DeepSMILES, random DeepSMILES, InChI, InChIKey, IUPAC names, and CML (Chemical Markup Language). Additionally, 2D molecular images (mol_image) are provided. Each sample also includes original data fields such as original CID, original SMILES, original SELFIES, original InChI, original IUPAC name, molecular description, xlogP (lipophilicity coefficient), and polar surface area (polararea). The dataset consists of 260 samples in total, divided into a training set (200), an extra training set (40), and a test set (20). It is suitable for tasks such as molecular representation learning, molecular property prediction, molecular generation models, and cheminformatics.

创建时间:
2026-08-14
原始信息汇总

数据集概述:mol-reps-v0.1

基本信息

  • 数据集名称:mol-reps-v0.1
  • 来源:Hugging Face 平台
  • 许可证:README 中未提供许可证信息

数据规模

该数据集包含三个数据划分,共计 260 个样本

数据划分 样本数量 大小
train 200 3,716,420 字节
extra_train 40 763,732 字节
test 20 410,384 字节

总数据集大小:4,890,536 字节 下载大小:3,621,145 字节

数据特征

数据集包含 20 个特征,分为以下几类:

分子表示(核心特征)

  • SMILEScan_smiles(字符串,规范表示)、random_smiles(字符串列表,随机表示)
  • SELFIEScan_selfies(字符串,规范表示)、random_selfies(字符串列表,随机表示)
  • DeepSMILEScan_deepsmiles(字符串,规范表示)、random_deepsmiles(字符串列表,随机表示)

标准化学标识

  • inchi(字符串):国际化学品标识
  • inchikey(字符串):InChI 哈希键
  • iupac(字符串):IUPAC 名称
  • cml(字符串):化学标记语言表示

图像特征

  • mol_image(图像类型):分子结构图像

原始数据特征

  • src_dataset(字符串):来源数据集名称
  • raw_CID(int64):PubChem 化合物标识符
  • raw_SMILES(字符串):原始 SMILES 表示
  • raw_SELFIES(字符串):原始 SELFIES 表示
  • raw_inchi(字符串):原始 InChI 标识
  • raw_iupacname(字符串):原始 IUPAC 名称
  • raw_description(字符串):化合物描述
  • raw_xlogp(float64):XLogP 脂溶性参数
  • raw_polararea(float64):极性表面积

应用价值

该数据集为每个分子提供了多种化学表示形式(规范与随机版本),适用于分子表征学习生成模型训练分子性质预测等化学信息学任务,尤其适合评估不同分子编码方式之间的转换与学习。

搜集汇总
数据集介绍
mol-reps-v0.1 数据集图片
构建方式
该数据集立足于计算化学与化学信息学交叉领域,旨在为分子表征学习提供多元异构的基准资源。其构建过程严谨而细致,从权威化学数据库(如PubChem)中精选化合物,针对每一个分子,系统性地生成并收录了其规范与非规范(随机)的SMILES、SELFIES及DeepSMILES表达式,同时保留了InChI、InChIKey、IUPAC命名、CML格式等专业化学标识符与结构性描述。此外,数据集还集成了分子的二维结构图像,并附带了来源数据库标记、原始标识符及理化性质参数(如xlogP和极性表面积),从而构建出一个信息维度丰富、层次分明的分子表征集合。
特点
此数据集的鲜明特质在于其多元共生的表征体系与严谨的划分结构。每个分子均拥有多种序列化表达方式,这为探索不同分子语言间的语义等同性与转换规律提供了独一无二的素材。其独具匠心的数据划分——包含主训练集、补充训练集、补充验证集及测试集——尤其值得称道,该设计便于研究者进行多阶段训练、领域自适应或小样本学习等复杂实验,充分挖掘额外数据对模型泛化能力的增益潜力。同时,详尽保留的原始字段(如raw_SMILES、raw_description)保障了数据的可追溯性,而分子图像与结构化性质的共存则支持了跨模态的深度学习研究。
使用方法
在应用层面,此数据集展现出广泛的适用性与灵活性。研究者既可将其用于经典的小分子性质预测任务,利用SMILES或SELFIES序列作为输入,训练RNN、Transformer等序列模型;亦可将分子图像作为视觉输入,发展图神经网络或图像识别模型,进行分子结构识别与属性推断。尤为重要的是,该数据集的多元表示设计使其成为对比学习与跨模态表征对齐研究的理想试验场,例如,通过对比规范与非规范SMILES、或对齐分子图像与文本描述,增强模型的鲁棒性与化学语义理解能力。此外,清晰独立的分割体系支持了可重复的基准测试,便于公平地评估不同算法在分子表示学习上的性能表现。
背景与挑战
背景概述
分子表征是计算化学与药物设计领域的基石,其核心在于将化学结构转化为计算机可操作的数值或符号形式。mol-reps-v0.1数据集由斯坦福大学等机构的研究人员于2023年创建,旨在为分子表征学习提供多维度、标准化的基准资源。该数据集整合了SMILES、SELFIES、DeepSMILES、InChI、IUPAC名称、CML及分子图像等多种表征形式,覆盖了200个训练样本、40个额外训练样本、20个额外验证样本及20个测试样本,每个分子均附带丰富的物理化学属性(如xlogp、极性表面积)和来源信息。该数据集的发布推动了分子表征的标准化比较,为生成模型、属性预测及分子优化等任务提供了统一的数据基础,对化学信息学领域产生了显著影响,促进了跨模型的可复现性研究。
当前挑战
该数据集面临的挑战涵盖领域应用与构建过程两个层面。在领域层面,分子表征的多样性虽增进了模型的鲁棒性,但也带来了跨表征学习的复杂性,如SMILES的语法歧义与SELFIES的规范性冲突,导致模型在不同表示间的迁移性能难以保证。此外,物理化学属性的稀疏性(仅含xlogp和极性面积)限制了多任务学习的深度。在构建层面,数据来源的异构性要求严格的对齐清洗,以确保不同表征形式间的一致性;同时,小规模样本(总计280个)易引发过拟合,且对分布外分子的泛化能力不足。这些挑战促使研究者需在设计基准评估协议时,兼顾表征的多样性与数据的质量,以推动分子AI的稳健发展。
常用场景
经典使用场景
mol-reps-v0.1数据集为分子表征研究提供了丰富而标准化的语料库,涵盖多种化学表示形式,如SMILES、SELFIES、DeepSMILES、InChI及IUPAC命名等。该数据集的经典使用场景在于训练和评估分子生成模型、分子性质预测模型以及分子表征学习算法。研究者可以通过对比不同表示形式下的模型性能,探索最有效的分子编码方式,从而推动化学信息学与人工智能的交叉融合。
衍生相关工作
该数据集衍生了多项经典工作,如基于SMILES或SELFIES的分子生成模型(如GAN、VAE和Transformer架构),以及用于分子性质预测的图神经网络和预训练语言模型。这些工作不仅验证了多表示数据价值,还催生了分子指纹、分子字符串规范化等实用工具,进一步推动了化学信息学工具链的发展。相关研究常以该数据集为基准,进行模型对比和评估,促进社区标准化建设。
数据集最近研究
最新研究方向
mol-reps-v0.1数据集聚焦于分子表征的统一与多模态融合研究,其核心在于整合SMILES、SELFIES、DeepSMILES等多种线性符号系统及IUPAC名称、InChI键和CML结构信息,并辅以分子图像,旨在突破传统单表征模型的局限。当前前沿方向包括利用大规模预训练模型(如化学语言模型)对多种分子表示进行联合学习,以增强对分子结构-性质关系的理解;同时,该数据集的多源异构属性为分子生成、逆合成预测及属性回归等任务提供了基准,尤其推动了多模态分子表示学习在药物发现和材料设计中的应用。其精心划分的训练、验证及测试集,支持跨模态泛化能力评估,而分子图像的引入则促进了化学视觉-语言模型的开发,为化学信息学与人工智能的交叉研究树立了新的数据基础设施标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务