
HymanH/VLKEB-data
收藏官方服务:
资源简介:
VLKEB是一个大规模视觉-语言模型知识编辑的基准测试数据集。现有的LVLM编辑基准在合成评估图像的质量上存在不足,并且无法评估模型是否在相关内容中应用了编辑后的知识。因此,VLKEB采用了更可靠的数据收集方法,并扩展了Portability指标以进行更全面的评估。数据集利用多模态知识图谱,将图像数据与知识实体绑定,并进一步用于提取与实体相关的知识,这些知识构成了编辑数据的基础。实验在五个LVLM上进行了不同编辑方法的测试,并深入分析了这些方法对模型的影响。
VLKEB是一个大规模视觉-语言模型知识编辑的基准测试数据集。现有的LVLM编辑基准在合成评估图像的质量上存在不足,并且无法评估模型是否在相关内容中应用了编辑后的知识。因此,VLKEB采用了更可靠的数据收集方法,并扩展了Portability指标以进行更全面的评估。数据集利用多模态知识图谱,将图像数据与知识实体绑定,并进一步用于提取与实体相关的知识,这些知识构成了编辑数据的基础。实验在五个LVLM上进行了不同编辑方法的测试,并深入分析了这些方法对模型的影响。
提供机构:
HymanH原始信息汇总
VLKEB: 大型视觉-语言模型知识编辑基准
数据集概述
- 名称: VLKEB
- 类型: 大型视觉-语言模型知识编辑基准
- 语言: 英语
- 许可证: BSD-3-Clause
数据集描述
- 目标: 解决大型视觉-语言模型(LVLMs)知识编辑的挑战,特别是多模态数据和复杂模型组件带来的额外困难。
- 现有问题: 现有的LVLM编辑基准在合成评估图像的质量上不足,且无法评估模型是否在相关内容中应用了编辑后的知识。
- 创新点:
- 采用更可靠的数据收集方法构建新的基准。
- 扩展了可移植性(Portability)指标,以进行更全面的评估。
- 利用多模态知识图谱,将图像数据与知识实体绑定,用于提取与实体相关的知识,构成编辑数据的基础。
实验与分析
- 实验对象: 在五个LVLMs上进行了不同编辑方法的实验。
- 结果: 详细分析了这些方法对模型的影响,揭示了它们的优缺点,并为未来的研究提供了见解。
相关链接
- arXiv论文: https://arxiv.org/abs/2403.07350
- GitHub仓库: https://github.com/VLKEB/VLKEB
搜集汇总
数据集介绍
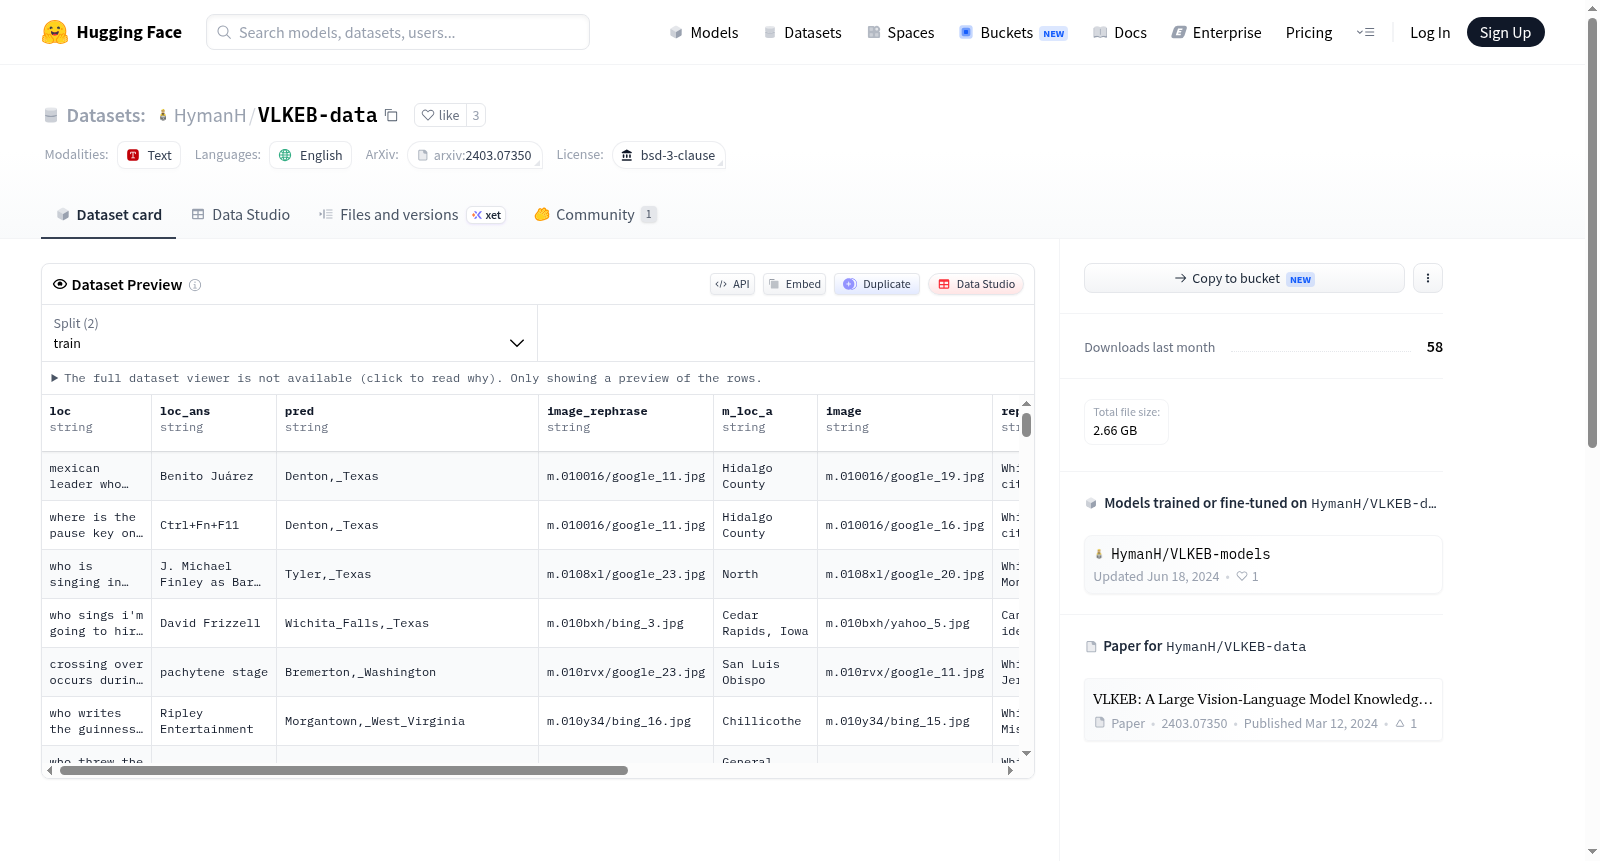
构建方式
VLKEB数据集的构建植根于多模态知识图谱技术,旨在克服现有视觉-语言模型知识编辑基准中合成图像质量不足及评估维度单一的局限。研究团队首先利用多模态知识图谱将图像数据与知识实体进行绑定,确保每个图像样本均对应明确的实体信息。随后,从这些实体中提取关联知识,作为编辑数据的基础,从而形成一套可靠且结构化的数据集。这一方法不仅提升了数据来源的可信度,还通过引入可移植性(Portability)指标扩展了评估体系,使数据集能够更全面地衡量模型在编辑后对相关知识的泛化应用能力。
特点
该数据集的核心特点体现在其多维度的评估架构与高质量的数据组织上。VLKEB不仅保留了传统基准中的可靠性(Reliability)、局部性(Locality)和通用性(Generality)三个指标,还创新性地增加了可移植性(Portability)维度,用于检验模型是否能在跨语境中有效迁移编辑后的知识。此外,数据与知识实体的一一对应关系,使得编辑操作更具针对性和可解释性。基于五种主流大型视觉-语言模型的实验验证,VLKEB能够系统揭示不同编辑方法的优势与不足,为后续研究提供坚实的实证基础。
使用方法
使用VLKEB数据集时,研究者可将其作为大型视觉-语言模型知识编辑的标准测试平台。具体步骤包括:首先,加载数据集中的图像与文本对,并依据预定义的知识实体标签确定编辑目标;其次,基于可靠性、局部性、通用性和可移植性四项指标,对模型编辑前后的表现进行全面评估;最后,通过对比不同编辑方法(如微调或元学习)的效果,分析模型在知识更新后的行为变化。数据集提供了清晰的接口和示例代码,便于直接集成到现有研究流程中,从而加速知识编辑领域的实验迭代与创新。
背景与挑战
背景概述
随着大型语言模型(LLMs)知识编辑技术的蓬勃发展,大型视觉-语言模型(LVLMs)的精准知识更新成为多模态人工智能领域的前沿课题。然而,现有基准如VLKEB的前身,受限于合成评估图像质量低下与缺乏对编辑知识迁移能力的评估,难以满足实际应用需求。为此,来自学术界的研究团队于2024年提出了VLKEB数据集,旨在构建更可靠、更全面的LVLMs知识编辑评估体系。该基准通过多模态知识图谱将图像数据与知识实体绑定,并引入可移植性(Portability)指标,以衡量模型在相关上下文中应用编辑知识的能力。VLKEB的发布填补了高质量LVLMs知识编辑基准的空白,为多模态模型的可控更新与知识纠偏提供了标准化测试平台,显著推动了该领域从单一指标评估向多维能力验证的范式转变。
当前挑战
VLKEB所面临的核心挑战首先源于多模态知识编辑的固有复杂性:LVLMs需同时处理文本与视觉模态的异构信息,编辑操作需兼顾可靠性(保持编辑后知识正确)、局部性(不影响无关知识)与泛化性(适应不同表达形式),而现有方法常在这三者间失衡。其次,数据构建过程中,如何从多模态知识图谱中精准提取与实体绑定的高质量图像-文本对,并确保编辑数据覆盖长尾知识场景,是一大技术瓶颈。此外,可移植性指标的引入虽拓展了评估维度,但如何设计能真实反映模型对编辑知识进行逻辑推理与跨模态迁移的测试样例,仍缺乏成熟方案。最后,现有编辑方法在五类LVLMs上的实验揭示出方法间性能差异显著,如何统一不同模型架构下的编辑效果评价标准,亦是亟待突破的难题。
常用场景
经典使用场景
在视觉与语言交叉领域的研究中,多模态大模型的知识编辑正逐渐成为一项核心挑战。VLKEB数据集应运而生,为评估和推动此类模型的知识更新能力提供了标准化基准。其最经典的使用场景是用于测试和比较不同知识编辑方法在大型视觉-语言模型上的表现,涵盖可靠性、局部性、通用性以及可迁移性四个关键维度,从而系统性地衡量编辑操作对模型行为的影响。
衍生相关工作
VLKEB的发布催生了一系列关于多模态知识编辑的后续经典研究。研究者基于该基准,深入分析了不同编辑方法(如基于元学习、超网络或定位修改的方法)在五个主流视觉-语言模型上的表现差异,揭示了各方法在保持模型局部性与实现知识迁移之间的权衡。这些工作不仅为编辑算法的改进指明了方向,也为构建更鲁棒、更可控的多模态智能系统奠定了理论基础。
数据集最近研究
最新研究方向
随着多模态大语言模型(LVLMs)在视觉与语言融合领域的广泛应用,如何精确、高效地更新模型中的知识成为前沿焦点。VLKEB数据集的提出恰逢其时,它针对现有知识编辑基准在评估图像质量与知识迁移能力上的不足,通过多模态知识图谱构建了更可靠的数据采集体系,并引入了可移植性(Portability)指标以衡量编辑知识在相关语境中的泛化表现。这一工作不仅填补了LVLM知识编辑评估的空白,更推动了模型在动态知识更新场景下的鲁棒性研究,为医疗诊断、自动驾驶等需要实时知识修正的高风险应用提供了关键评测基础,其影响力正随着多模态AI的产业化落地而持续扩大。
以上内容由遇见数据集搜集并总结生成


