
MTE313/SnappFood_dataset_advanced
收藏官方服务:
资源简介:
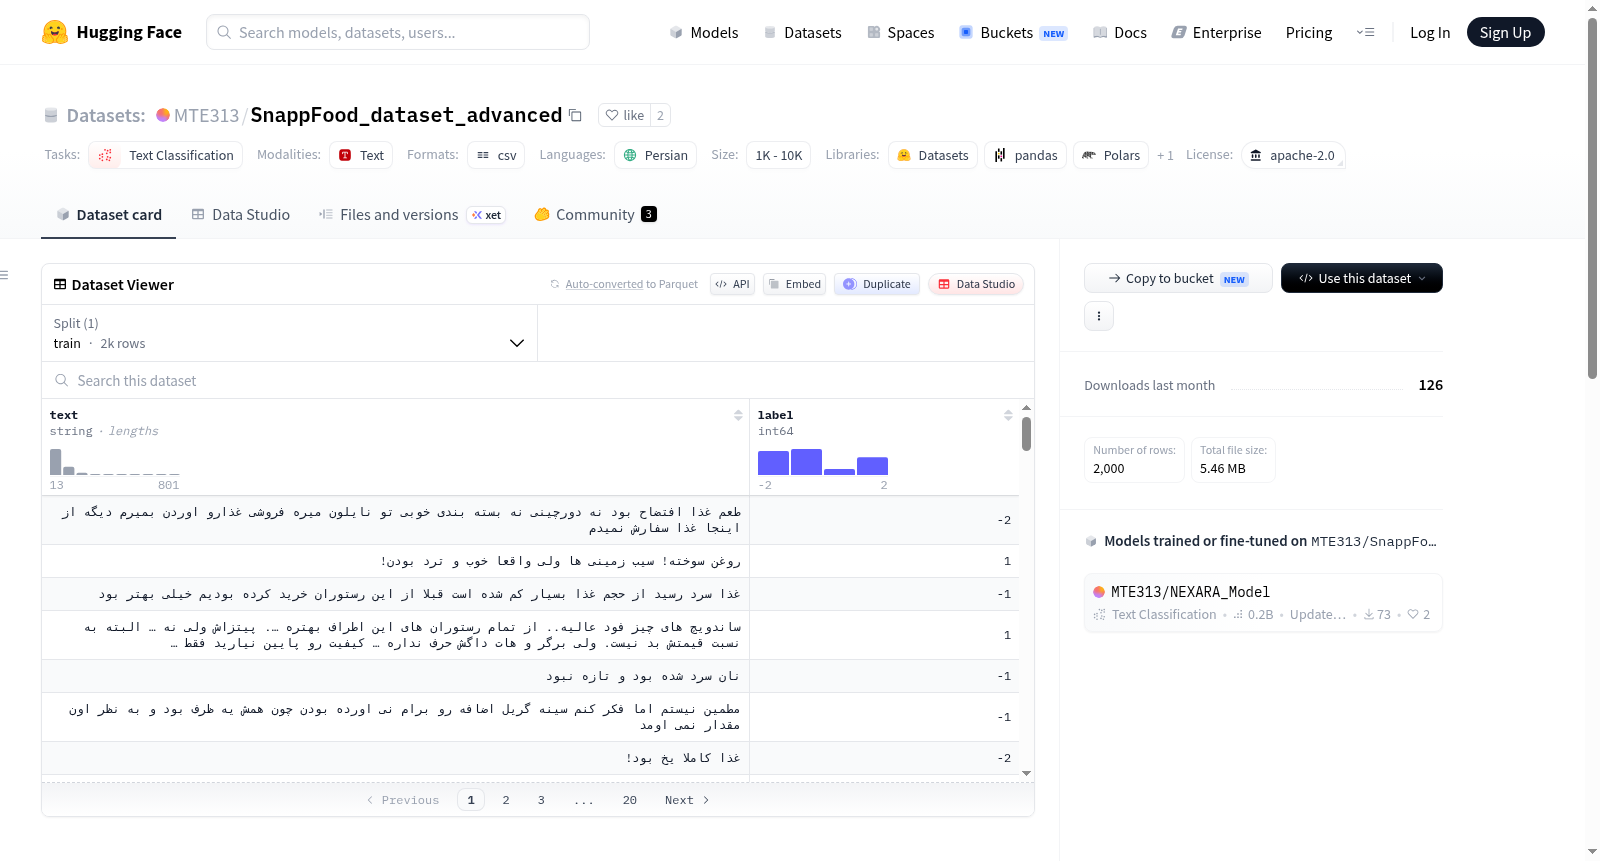
首先,Snapp Food数据集由Snapp公司创建。它是一个包含70,000个样本的波斯语NLP数据集,数据来源于SnappFood的用户评论,但最初只有2个类别。我们(NEXARA GROUP)对这个流行数据集进行了增强,将其扩展为5个类别。我们微调了一个NLP模型来标注数据,并开发了一个应用程序以提供更好的体验。我们将很快发布下载应用程序和模型的链接。
First, the Snapp Food dataset was created by Snapp Corporation. It is a Persian NLP dataset containing 70,000 samples, sourced from user reviews of SnappFood, which originally had only two categories. We (NEXARA GROUP) enhanced this popular dataset and expanded it to 5 categories. We fine-tuned an NLP model for data annotation and developed an application to provide a better user experience. We will shortly release the download links for both the application and the model.
提供机构:
MTE313搜集汇总
数据集介绍
构建方式
SnappFood_dataset_advanced 数据集源起于伊朗Snapp公司所收集的SnappFood用户评论,最初仅包含两个情感类别,规模达七万样本。NEXARA研究团队在此基础上进行拓展,通过微调自然语言处理模型对原始数据进行自动标注,将类别扩展至五个,涵盖更细致的用户反馈维度。数据集以Excel格式保存,并提供了预览文件供快速查看。
特点
该数据集的核心特色在于其从二元分类向五元分类的升级,显著提升了情感分析的粒度与实用性。样本规模保持在七万级别,语言为波斯语,适用于因特网餐饮评论领域。数据来源于真实用户评论,结合了Snapp公司的原始采集与NEXARA团队的模型增强标注,兼顾了数据的自然性与标签的准确性。
使用方法
数据集可作为文本分类任务的微调与评估基准,尤其适用于波斯语情感分析及用户评价理解场景。使用者可直接下载SnappFood_70000Samples.xlsx文件,通过常规数据处理框架读取,并利用其中的五类标签开展模型训练或测试。NEXARA团队后续还将发布配套的标注模型与应用,进一步简化数据的使用流程。
背景与挑战
背景概述
SnappFood_dataset_advanced是一个面向波斯语文本分类任务的多类别情感分析数据集,由伊朗Snapp公司于2022年发布,后经NEXARA研究团队扩展与优化。该数据集基于SnappFood平台的用户评论构建,原始版本包含70,000个样本,但仅支持二元分类。NEXARA团队通过先进的自然语言处理模型对数据进行精细标注,将其升级为五类别数据集,显著提升了情感分析的粒度与实用性。该数据集在波斯语计算语言学领域具有重要影响力,为低资源语言的文本分类研究提供了高质量基准,推动了中东地区自然语言处理技术的发展。
当前挑战
该数据集所解决的领域挑战在于,波斯语情感分析长期缺乏大规模且标注精细的公开语料库,传统二元分类难以捕捉复杂情绪表达。构建过程中面临的核心挑战包括:原始数据集仅含积极与消极两类标签,需设计可靠的半自动标注策略以扩展为多类别;标注过程依赖微调后的NLP模型,但模型自身可能引入偏差,需通过人工校验确保标签质量;此外,用户评论包含大量口语化表达、拼写变体及波斯语特有的语法结构,增加了文本清洗与预处理的难度。
常用场景
经典使用场景
SnappFood_dataset_advanced 源自伊朗知名外卖平台SnappFood的用户评论文本,经过NEXARA团队的精细化扩展,从原始的二元情感分类数据集升级为涵盖五类情感倾向的标注资源。该数据集最经典的使用场景在于波斯语文本的情感分类任务,研究者可基于其中约七万条高质量用户评论,训练和评估自然语言处理模型在多分类任务上的表现。其细粒度的情感标签体系,使模型能够区分更为复杂的情感色彩,从而推动低资源语言的情感分析研究迈向新台阶。
衍生相关工作
围绕SnappFood_dataset_advanced,研究者已经衍生出若干经典工作方向。首先,基于该数据集微调的波斯语情感分类模型(如使用BERT或XLM-R等预训练模型)被广泛用于后续文本分析工具的开发。其次,NEXARA团队配套构建的标注应用和模型社区,推动了低资源NLP任务中的人机协同标注范式研究。此外,该数据集也催生了针对外卖评论的细粒度方面级情感分析、迁移学习在波斯语上的有效性验证,以及多语言情感模型在波斯语上的零样本学习能力评估等后续探索。
数据集最近研究
最新研究方向
在波斯语自然语言处理领域,SnappFood_dataset_advanced的诞生标志着情感分析任务从二元分类向多类别判定的重要跃迁。该数据集基于Snapp公司原始7万条用户评论文本,经NEXARA团队通过微调NLP模型进行精细标注,扩展为五分类体系,填补了波斯语细粒度情感资源稀缺的空白。当前研究前沿聚焦于利用该数据集训练多标签分类模型,探索跨领域迁移学习的可行性,同时结合众包标注与主动学习策略提升标注质量。这一工作不仅为波斯语电商平台的用户反馈分析提供了标准化基准,更推动了低资源语言在意见挖掘、服务质量监测等热点方向上的技术落地,对构建多语言情感理解生态系统具有里程碑意义。
以上内容由遇见数据集搜集并总结生成


