
遇见数据集

JetBrains-Research/cwm-benchmarks-dl4c-generations

收藏
Hugging Face2026-06-26 更新2026-07-22 收录
官方服务:

资源简介:

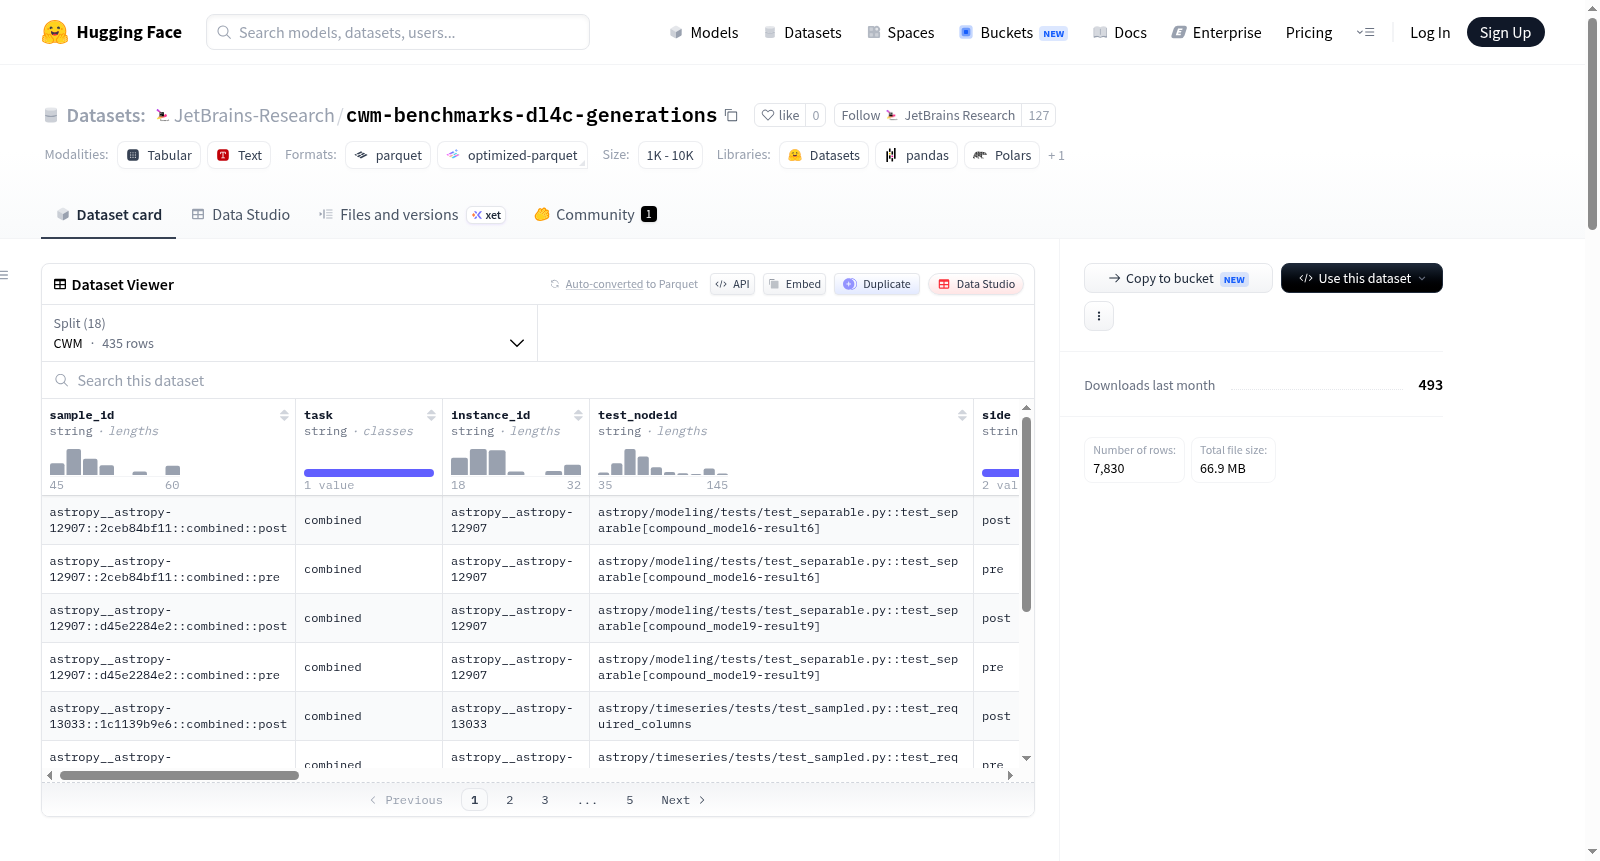
该数据集名为CWM Benchmarks — DL4C Generations,包含从v05_clean评估运行中获取的每个模型的原始生成结果,这些结果针对CWM-benchmarks DL4C任务套件进行了评分。每个分割(split)对应一个特定模型,并包含该模型在相同一组(instance, test, side)样本上的435个响应。数据集涵盖了多个模型,如CWM、MiniMax系列、Qwen系列、Claude系列、GPT系列等,总计18个分割。数据以Parquet格式存储,每个样本包括sample_id、task、instance_id、test_nodeid、side、model、duration_s、prompt_tokens、completion_tokens、raw_response、parsed_response、prediction、ground_truth、metric、metric_args、metrics和error等字段。嵌套对象以JSON编码字符串存储,以保持Parquet模式扁平。数据集可用于评估模型在DL4C任务上的性能。

This dataset is named CWM Benchmarks — DL4C Generations. It contains raw generation results of each model obtained from the v05_clean evaluation run, with all results scored against the CWM-benchmarks DL4C task suite. Each split corresponds to a specific model, and contains 435 responses from that model on the same set of (instance, test, side) samples. The dataset covers multiple models, including CWM, MiniMax series, Qwen series, Claude series, GPT series and others, totaling 18 splits. The data is stored in Parquet format, with each sample containing fields such as sample_id, task, instance_id, test_nodeid, side, model, duration_s, prompt_tokens, completion_tokens, raw_response, parsed_response, prediction, ground_truth, metric, metric_args, metrics and error. Nested objects are stored as JSON-encoded strings to maintain a flat Parquet schema. This dataset can be used to evaluate model performance on DL4C tasks.
提供机构:
JetBrains-Research
搜集汇总
数据集介绍
JetBrains-Research/cwm-benchmarks-dl4c-generations 数据集图片
构建方式
该数据集源于CWM-Benchmarks DL4C任务套件的v05_clean评估运行,旨在收录各模型在统一样本集合上的原始生成结果。数据集以Parquet格式存储,共包含18个独立的分片,每个分片对应一个特定的模型(如CWM、MiniMax-M2、GPT-5.2等),每个分片内均记录着435条针对相同(实例、测试、侧面)样本的响应。为满足HuggingFace对拆分名称的字符限制,模型标识符中的连字符被替换为下划线,而原始模型名称则保留在数据行的"model"字段中,确保信息的准确可追溯。
特点
数据集的结构设计简洁而严谨,每条记录包含丰富的字段,如sample_id用于唯一标识样本,task、instance_id、test_nodeid及side协同定位具体测试场景。核心内容涵盖模型调用的原始输出(raw_response)及其解析后的标准化预测(parsed_response、prediction),同时提供ground_truth以供对比。此外,还记录了调用时长、提示与生成令牌数等性能指标,以及度量标准与逐样本评分结果(metrics)。嵌套对象均以JSON字符串形式存储,兼顾Parquet的扁平化要求与信息的完整性。
使用方法
研究人员可通过HuggingFace的datasets库便捷地加载该数据集,使用load_dataset函数获取全部拆分的集合,并利用拆分名称(如"CWM"或"gpt_5_mini")直接索引特定模型的生成结果。每条数据提供了从原始响应到规范化预测的完整处理链,用户可依据sample_id、task等字段筛选所需样本,并结合ground_truth与metrics字段进行模型性能分析或对比研究。对于嵌套的JSON字段,需调用json.loads进行解码以还原Python对象。
背景与挑战
背景概述
该数据集由JetBrains Research于近期创建,旨在系统评估大规模语言模型在代码理解与修复任务中的表现。核心研究问题聚焦于模型能否准确预测代码变更前后(pre/post)的测试结果,涵盖CWM、MiniMax、Qwen、Claude、GPT及poolside等多个前沿模型的raw generations。作为cwm-benchmarks套件的重要组成部分,该数据集通过标准化接口和指标体系,为代码智能领域的研究者提供了可复现、可比较的评估基准,对推动深度学习在持续集成与代码质量保障方向的应用具有显著影响力。
当前挑战
当前挑战主要涵盖两个维度。在领域问题层面,模型需应对代码逻辑推理、变更影响分析及测试结果预测的复杂性,尤其是跨文件上下文理解与多任务联合优化。在构建过程中,数据集面临跨模型输出格式不一致的解析难题、不同架构间prompt设计差异导致的比较偏差,以及大规模评估时的计算资源与时间开销。此外,ground truth的准确标注与metrics的鲁棒性设计也是确保评测公正性的关键难点。
常用场景
经典使用场景
在软件工程与深度学习交叉的前沿领域,cwm-benchmarks-dl4c-generations数据集为评估大型语言模型在代码测试生成这一精细任务上的表现提供了标准化平台。该数据集汇集了来自CWM、MiniMax、Qwen、Claude、GPT及Poolside等多个主流系列模型在同一套精心设计的435个样本上的原始生成结果,每个样本均由实例标识符、测试哈希、任务类型与代码库状态(补丁前/后)共同锚定。研究者通过加载不同模型分片,可直接对比各模型在统一评测基准上的推理输出,从而衡量模型对代码逻辑的理解深度、测试断言生成的精准度以及处理不同代码变更场景的鲁棒性。其简洁的parquet格式与扁平化JSON字段存储方式,极大降低了数据预处理的门槛,使得模型的横向比较与复现实验变得高效而可靠。
解决学术问题
该数据集的核心学术价值在于系统性破解了代码测试生成领域长期存在的两大难题:异构模型间评估标准不统一与实验复现成本高昂。此前,不同研究团队选用各自的模型版本、测试集与评分指标,导致成果难以横向对比与归因。cwm-benchmarks-dl4c-generations通过固定样本集与标准化的metric字段,为每一组模型输出记录了细粒度的评分结果与错误信息,使得研究者能够精确分析模型在特定测试场景下的失败模式,例如对补丁前后代码行为的判别能力差异。这一做法不仅推动了大模型在代码理解与生成任务上的可重复性研究,更使得学术界能够汇聚力量,聚焦于语言模型在结构化测试逻辑推断中的本质短板,从而启发更具针对性的改进方法。
衍生相关工作
该数据集的出现催生了一系列深化代码测试生成研究的衍生工作。一方面,研究者将其作为基准,训练面向代码测试的专用小型模型,致力于在保持高精度的同时降低推理时延与计算开销,以适应边缘设备或实时反馈场景的需求。另一方面,基于该数据集中丰富的错误与指标字段,涌现出针对大模型输出进行后处理与自纠正的方法学探索,例如通过检索增强生成(RAG)或迭代式提示优化来提升测试覆盖率。此外,该数据集所提供的多模型、多维度对比视角,被广泛用于分析模型规模、训练数据配比与测试生成能力之间的缩放律关系,为下一代代码智能模型的架构设计提供了实证基础。这些工作共同将代码测试生成从单纯的模型性能比拼引向更系统的、可解释的算法创新路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

