dhruvrajpal/defense-logistics-stochastic-simulation
收藏资源简介:
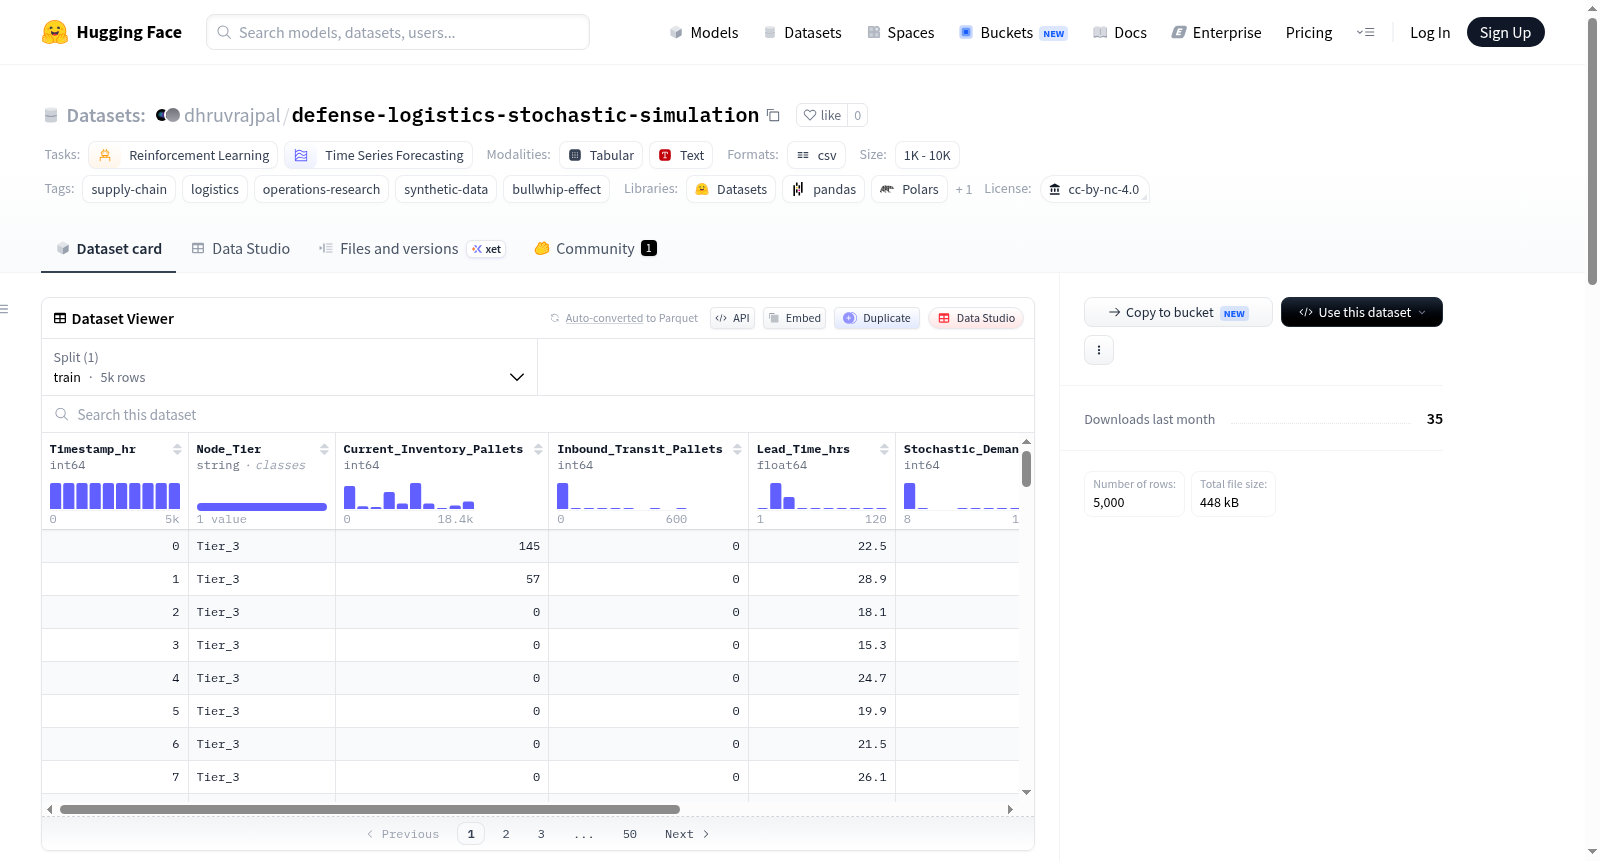
这是一个高保真合成数据集,代表在持续压力和操作激增下运行的Tier-3终端单位(前沿作战基地)。它旨在弥合干净学术数据集与边缘节点物流混乱现实之间的差距。该5,000小时样本是AI Mind Teams 50,000-Hour Premium Suite的子集,专为压力测试强化学习代理和预测模型而设计。关键特性包括:零数学漂移(经验证的流量守恒物理:$I_t = max(0, I_{t-1} + R_t - D_t)$)、路线中断物理(动态提前期峰值从24小时到150小时以上)、随机需求(泊松分布消耗和周期性操作激增)以及传输管道队列(实时跟踪空中的订单)。数据字典包括列:Current_Inventory_Pallets(小时开始的净物理库存)、Inbound_Transit_Pallets(管道到达:本小时实际到达的总供应量)、Lead_Time_hrs(新订单的当前预期传输时间)、Stochastic_Demand(本小时的最终用户消耗)、Holding_Cost_USD(每小时每托盘2.50美元)和Stockout_Penalty_USD(每托盘短缺1,000.00美元)。该样本在知识共享署名-非商业性4.0许可下提供,适用于学术研究和非商业探索。
This is a high-fidelity synthetic dataset representing a Tier-3 terminal unit (forward operating base) operating under sustained pressure and operational surges. It aims to bridge the gap between pristine academic datasets and the chaotic real-world logistics of edge nodes. This 5,000-hour sample is a subset of the AI Mind Teams 50,000-Hour Premium Suite, specifically designed for stress-testing reinforcement learning agents and predictive models. Key features include: zero mathematical drift (validated flow-conservation physics: $I_t = max(0, I_{t-1} + R_t - D_t)$), route-disruption physics (dynamic lead time peaks ranging from 24 hours to over 150 hours), stochastic demand (Poisson-distributed consumption and periodic operational surges), and transit pipeline queues (real-time tracking of in-transit orders). The data dictionary includes the following columns: Current_Inventory_Pallets (net physical inventory at the start of the hour), Inbound_Transit_Pallets (in-transit arrivals: total supply actually arriving during the current hour), Lead_Time_hrs (current expected transit time for new orders), Stochastic_Demand (end-user consumption during this hour), Holding_Cost_USD ($2.50 USD per pallet per hour), and Stockout_Penalty_USD ($1,000.00 USD per out-of-stock pallet). This sample is made available under the Creative Commons Attribution-NonCommercial 4.0 International License for academic research and non-commercial exploration.