
遇见数据集

overthelex/multi-legal-bench

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

Multi-Legal-Bench是一个跨法域的法律基准数据集,旨在评估大型语言模型在多个司法管辖区、语言和法律传统下的法律推理能力。数据集覆盖六个国家(乌克兰、法国、荷兰、波兰、捷克共和国、立陶宛),涉及五种语言家族(斯拉夫语、罗曼语、日耳曼语、波罗的语),并基于1.22亿份法院判决的元数据。它定义了五个任务:法院类型分类(CTC)、判决形式分类(JFC)、案件结果预测(COP)、原因类别预测(CCP)和法律规范提取(NE)。数据以JSONL格式存储,每个记录包含唯一标识符、法域代码、语言代码、任务标识符、原始标签、标准化标签、决策日期、文本长度、完整判决文本以及特定任务的字段(如事实部分或法律规范引用)。数据集包含15个任务-法域组合,总计13,096个决策,用于研究任务难度稳定性、少样本效应、跨语言迁移等关键问题,并支持相关学术论文。数据来源于各国官方开放的法院登记系统,采用CC-BY-SA 4.0许可协议。

Multi-Legal-Bench is a cross-jurisdictional legal benchmark dataset aimed at evaluating the legal reasoning capabilities of large language models (LLMs) across multiple jurisdictions, languages and legal traditions. The dataset covers six countries: Ukraine, France, Netherlands, Poland, Czech Republic and Lithuania, spans five language families (Slavic, Romance, Germanic, Baltic), and is built upon metadata from 122 million court judgments. It defines five tasks: Court Type Classification (CTC), Judgment Form Classification (JFC), Case Outcome Prediction (COP), Cause Category Prediction (CCP) and Legal Norm Extraction (NE). The data is stored in JSONL format, with each record containing a unique identifier, jurisdiction code, language code, task identifier, original label, standardized label, decision date, text length, full judgment text, and task-specific fields such as the factual section or legal norm citations. The dataset includes 15 task-jurisdiction combinations, totaling 13,096 decisions, which are used to study key issues including task difficulty stability, few-shot effects, cross-lingual transfer, and support relevant academic papers. The data is sourced from official open court registry systems of the respective countries, and is licensed under CC-BY-SA 4.0.
提供机构:
overthelex
搜集汇总
数据集介绍
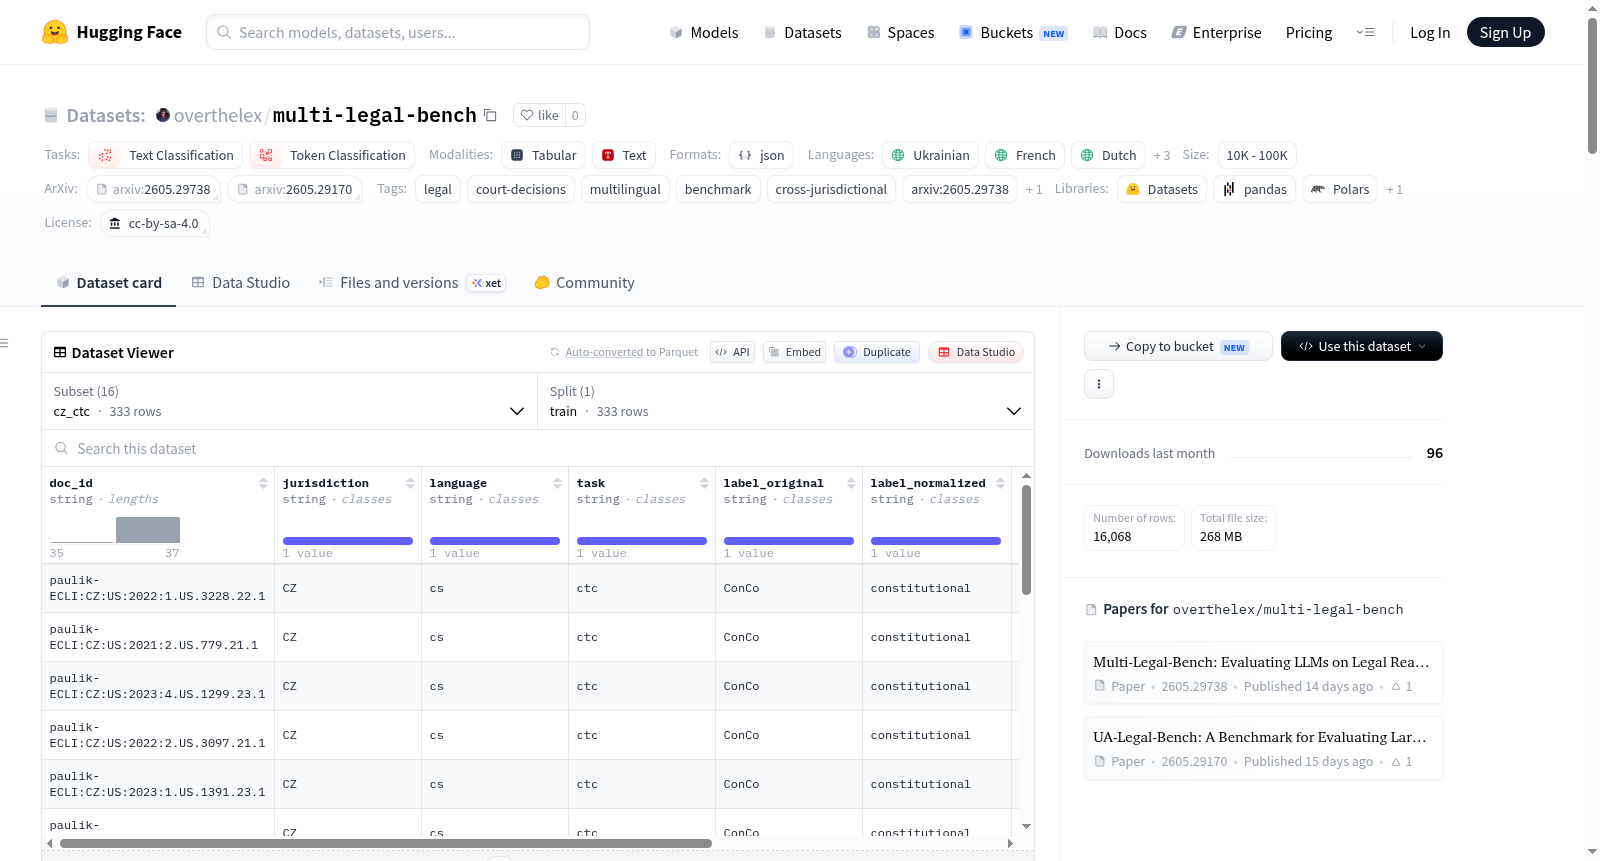
overthelex/multi-legal-bench 数据集图片
构建方式
Multi-Legal-Bench的构建源于对跨法域法律推理评估需求的深刻洞见。该数据集从乌克兰、法国、荷兰、波兰、捷克和立陶宛六个国家的官方公开法院登记处,系统收集了涵盖斯拉夫、罗曼、日耳曼和波罗的海四大语系的逾1.22亿份判决文书。在此基础上,研究团队通过将司法系统中高度结构化的元数据(如法院类型、判决形式、案由类别等)映射为五项标准化任务,实现了对原始法律文本的精炼与转化。每一份样本均经过doc_id、jurisdiction、language、task、label_original、label_normalized、decision_date、text_length及full_text等多个维度的标注,并针对Case-Outcome Prediction任务额外提取facts字段,针对Legal Norm Extraction任务补充norms字段,最终以JSONL格式存储为15个任务-法域组合文件,总计包含13,096条高质量判决数据。
特点
该数据集最显著的特征在于其跨法域、多语言的并行评估设计,开创性地实现了在同一推理任务上对六个国家、五种语言的统一衡量。数据集定义了Court-Type Classification、Judgment Form Classification、Case-Outcome Prediction、Cause Category Prediction和Legal Norm Extraction五项法律推理任务,每项任务均配以明确的评估指标(Accuracy或Set-level F1)。值得注意的是,并非所有任务在每个法域均可用,这种非对称覆盖真实反映了各国司法元数据可用性的差异,增强了基准的生态效度。实验揭示的若干关键发现,如任务难度跨法域保持稳定、少样本效果依赖任务而非语言、跨语言迁移取决于标签对齐而非语言亲缘性等,充分彰显了该基准在揭示多语言法律推理本质规律方面的独特价值。
使用方法
使用Multi-Legal-Bench进行模型评估时,研究者可通过Hugging Face Datasets库直接加载各个配置的数据集,例如使用load_dataset('multi-legal-bench', 'fr_ctc')即可获取法国的法院类型分类数据。每条记录包含完整的判决全文及标准化标签,支持零样本与少样本评估范式。对于Legal Norm Extraction任务,需使用Set-level F1作为评估指标,其他分类任务则采用Accuracy。该数据集已被集成至论文《Multi-Legal-Bench: Evaluating LLMs on Legal Reasoning Across Jurisdictions, Languages, and Legal Traditions》中,研究者可参考该工作复现对11种大语言模型(含7个前沿模型与4个小模型)的评估流程,并通过AWS Bedrock平台进行推理。数据采用CC-BY-SA 4.0许可协议,鼓励学术研究使用。
背景与挑战
背景概述
法律文本解析与推理是自然语言处理领域长期探索的前沿方向,其核心挑战在于法律术语的严谨性、跨法系规则的差异性以及多语言文本的复杂性。在此背景下,由Volodymyr Ovcharov主导构建的Multi-Legal-Bench数据集于2026年正式发布,旨在系统评估大语言模型在跨司法管辖区、跨语言及不同法律传统下的法律推理能力。该数据集覆盖乌克兰、法国、荷兰、波兰、捷克和立陶宛六个国家,横跨斯拉夫、罗曼、日耳曼及波罗的海四个语族,整合了1.22亿份司法判决,定义了法院类型分类、判决形式分类、案件结果预测、案由分类及法律规范抽取五项任务。作为首个横跨多法域的统一基准,它填补了法律NLP领域缺乏系统性跨域评估工具的空白,为比较法研究、司法智能化及多语言模型优化提供了关键支撑。
当前挑战
该数据集面临的核心挑战在于法律环境的异质性与模型泛化能力的局限性。首先,跨司法管辖区的法律任务难度虽总体一致,但不同国家的元数据覆盖与标签定义显著差异,需对原始标签进行规范化处理,这对数据对齐与质量保障提出了极高要求。其次,在构建过程中,从六个国家官方开放司法数据库中采集、清洗与标注超过1.3万份判决文本,面临数据格式不统一、部分任务标签稀疏(如立陶宛仅有四项任务)及法律术语跨语言对齐的困难。再者,少样本学习效果高度依赖任务而非语言,跨语言迁移受标签对齐程度影响远大于语言亲缘性,这揭示了模型在低资源语言(如立陶宛语)上表现显著衰退的瓶颈。此外,小型模型在处理欠表征语言时准确率骤降20个百分点,凸显了兼顾语言多样性与模型效率的结构性挑战。
常用场景
经典使用场景
在法律智能与自然语言处理的交叉领域中,Multi-Legal-Bench作为首个横跨多个司法管辖区与语系的法律推理评估基准,其经典应用场景在于系统性地测评大语言模型在不同国家、不同语言及不同法律传统下的文本分类与信息抽取能力。该基准精心设计了法院类型分类、判决形式分类、案件结果预测、案由类别预测以及法律规范抽取五项任务,覆盖乌克兰、法国、荷兰等六个国家共计超过一万三千份真实法院判决全文,为跨法域法律AI模型的性能衡量提供了标准化的实验平台。
解决学术问题
此数据集着重解决了法学与人工智能交叉研究中的两个核心学术问题:其一是现有法律基准普遍局限于单一司法管辖区或单一语言,难以评估模型在跨国、跨语言环境中的泛化能力;其二是在不同法律传统下,模型对结构化法律推理任务的适应性尚缺乏系统性的比较研究。Multi-Legal-Bench通过统一的标注体系与任务设计,揭示了法院类型分类等任务在不同法域中的表现稳定性,同时证实了案件结果预测等复杂推理任务对当前大型语言模型依旧是严峻挑战,从而为跨文化法律语言理解的理论建构提供了坚实的数据基础。
衍生相关工作
围绕Multi-Legal-Bench已衍生了多项具有影响力的经典工作。其姊妹基准UA-Legal-Bench专门聚焦乌克兰语法律推理,深入探讨了斯拉夫语族中法律文本的独特特点。该数据集的前沿发现——如少样本提示效果依赖于任务而非语言、跨语言迁移受标签对齐程度而非语言亲缘关系影响——直接催生了一系列关于多语言法律模型微调策略与跨法域迁移学习的研究。此外,该基准中揭示的小规模模型在低资源语言上表现严重退化的问题,推动了针对司法领域低资源语言的模型压缩与知识蒸馏技术的开发,进一步丰富了法律人工智能的研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

