193k-prices-period-care-atlas
收藏资源简介:
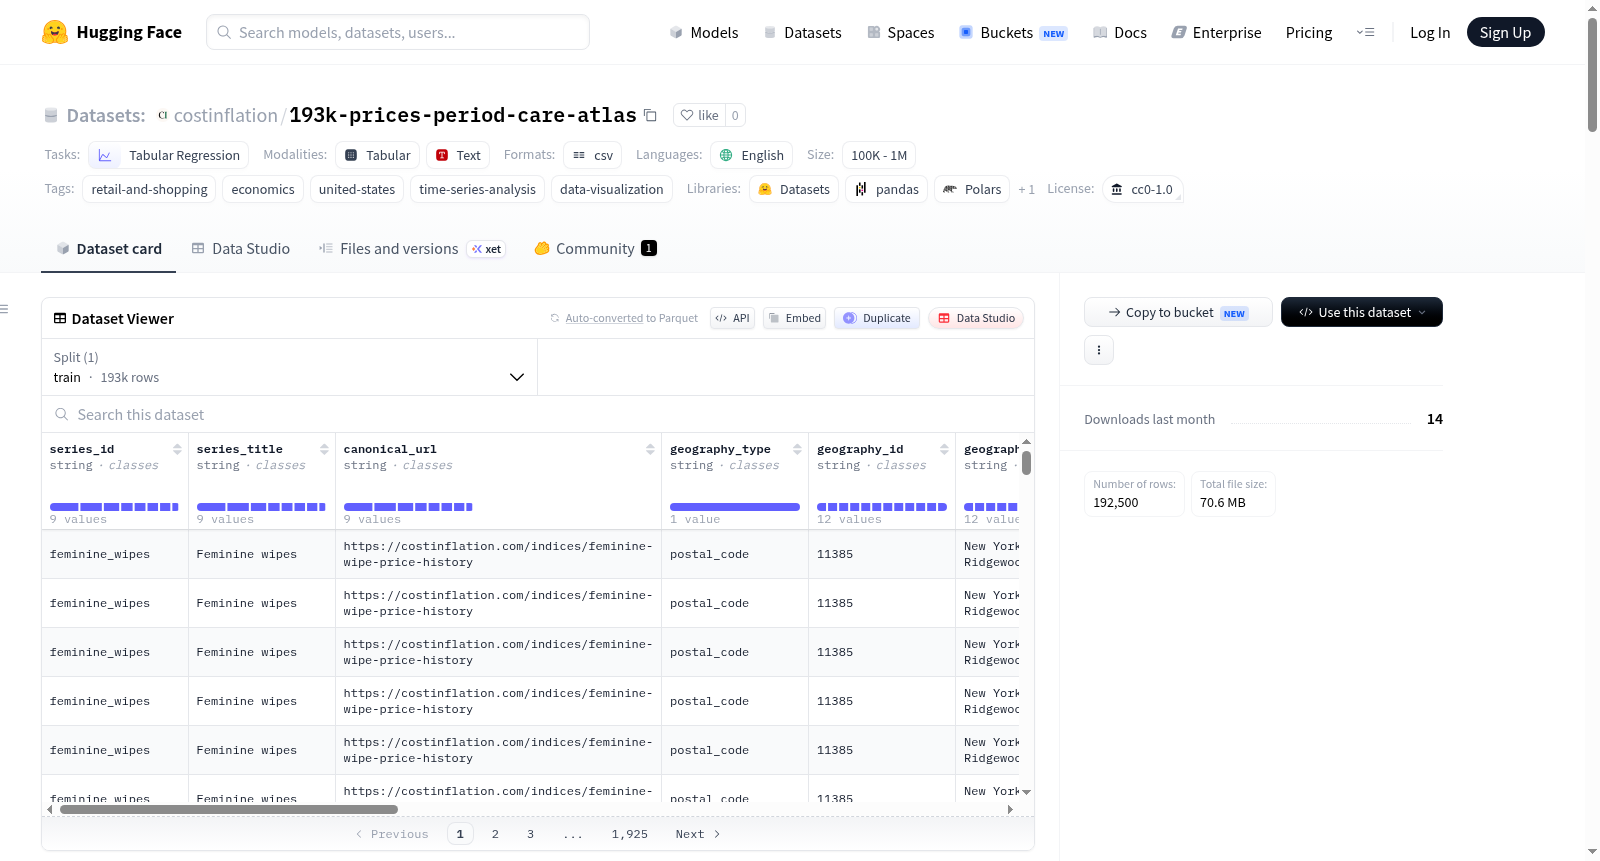
该数据集名为“Period Care Prices Raw Dataset (2026)”,由CostInflation团队发布,是一个固定研究快照,包含192,500条经过质量过滤的未聚合价格观察数据,覆盖9个经期护理产品类别(如卫生巾、卫生棉条、月经杯、月经盘、经期热敷贴、经期止痛药、经期内裤、护垫、女性湿巾)、12个美国邮编市场以及2026年7月21日至8月18日共29个连续日期。每条记录代表一个经期护理产品标题、邮编市场、日期、所列数量和价格的产品级观察,不表示销售、订单、需求、库存、市场份额、个人使用、健康结果或医疗建议。数据格式为CSV,包含16列:series_id(类别键)、series_title(类别标题)、canonical_url(相关类别页面URL)、geography_type(地理级别,始终为postal_code)、geography_id(五位数美国邮编)、geography_label(邮编市场标签)、observed_date(观察日期)、product_name(产品标题)、quantity_value(解析后的产品数量)、quantity_unit(数量单位)、quantity_name(数量名称)、price_amount(所列价格)、currency_code(货币代码,始终为USD)、normalized_price_amount(标准化到类别比较目标的价格,未解析或不相容时为空)、normalized_quantity_value(类别特定比较目标数值:1、4、40或100)、normalized_quantity_unit(比较目标单位,始终为units)。数据集适合用于分析经期护理产品在时间、地理和类别间的价格分布、变异性,以及标准化价格与非标准化价格的对比等研究。所有预期日期、邮编市场和类别×邮编×日期组合均完整存在,没有重复行。标准化价格仅在相同series_id内可比,且未建立不同材料、用途等之间的等效性。数据集采用CC0 1.0通用许可,可自由复用。
The dataset is named "Period Care Prices Raw Dataset (2026)", released by the CostInflation team. It is a fixed research snapshot containing 192,500 quality-filtered, unaggregated price observations covering 9 period care product categories (e.g., sanitary pads, tampons, menstrual cups, menstrual discs, period heat patches, period pain relief, period underwear, panty liners, feminine wipes), 12 U.S. postal code markets, and 29 consecutive dates from July 21 to August 18, 2026. Each record represents a product-level observation of a period care product title, postal code market, date, listed quantity, and price, and does not imply sales, orders, demand, inventory, market share, personal use, health outcomes, or medical advice. The data format is CSV with 16 columns: series_id (category key), series_title (category title), canonical_url (relevant category page URL), geography_type (geographic level, always postal_code), geography_id (5-digit U.S. postal code), geography_label (postal code market label), observed_date (observation date), product_name (product title), quantity_value (parsed product quantity), quantity_unit (quantity unit), quantity_name (quantity name), price_amount (listed price), currency_code (currency code, always USD), normalized_price_amount (price normalized to category comparison target, empty when unparsed or incompatible), normalized_quantity_value (category-specific comparison target value: 1, 4, 40, or 100), normalized_quantity_unit (comparison target unit, always units). The dataset is suitable for analyzing the price distribution, variability, and comparison of normalized vs. non-normalized prices of period care products across time, geography, and categories. All expected dates, postal code markets, and category×postal code×date combinations are fully present with no duplicate rows. Normalized prices are comparable only within the same series_id, and no equivalence is established between different materials, uses, etc. The dataset is licensed under CC0 1.0 Universal, free to reuse.
Period Care Prices Raw Dataset (2026) 数据集概述
基本信息
- 数据集名称: Period Care Prices Raw Dataset (2026)
- 许可证: CC0 1.0 Universal
- 语言: 英语
- 任务类型: 表格回归
- 标签: 零售与购物、经济学、美国、时间序列分析、数据可视化
- 数据规模: 192,500 条记录(大于100K小于1M)
- 格式: CSV / USD
数据内容
- 观察窗口: 2026年7月21日至8月18日,共29天
- 地理覆盖: 12个美国ZIP市场
- 类别覆盖: 9个月经护理产品类别(包括:卫生湿巾、月经杯、月经盘、经期热敷贴、卫生巾、经期止痛产品、护垫、经期内裤、卫生棉条)
- 完整网格: 类别 × ZIP × 日期 = 3,132 个单元格,全部覆盖
- 不同产品标题: 1,644 个
- 数据行数: 192,500 行,16列
关键字段说明
price_amount: 列出的价格(美元)normalized_price_amount: 按类别固定比较目标标准化后的价格(约66.0%的行包含此字段)normalized_quantity_value: 类别的标准化数量目标(1、4、40或100单位)geography_id: 五位数美国邮编(需以文本格式加载)observed_date: 观察日期(YYYY-MM-DD格式)
可比价格方法
- 127,087 行(66.0%)具有非空标准化价格,基于已解析的正数数量和固定类别目标
- 65,413 行(34.0%)由于数量无法解析或与类别目标不兼容,保留原价且标准化价格字段为空
- 仅可在相同
series_id内比较标准化价格值
数据质量与限制
- 所有29个日期、12个ZIP市场和3,132个完整单元格均存在
- 无重复公开行,无公式开头产品标题
- 产品标题为描述性文本,非稳定的产品标识符
- ZIP标签描述特定市场,不代表全市、都市、州或国家估计
- 数据集不包含配送费、税费、促销折扣、购买行为、使用情况、健康结果或产品性能信息
- 不可用于剂量、有效性、舒适度、安全性或生命周期成本的等效性比较
预期用途
- 比较一次性与可重复使用经期护理产品的价格分布
- 分析12个ZIP市场间的地理价格差异
- 追踪29天窗口内的日度类别中位数和离散度
- 对比可重复使用与一次性产品的价格模式,但不主张等效性
文件与结构
- 文件大小: 70,489,018 字节
- 数据分割: 仅训练集(192,500条样本)
- 无计划更新,为固定研究快照
数据集来源
由CostInflation团队准备和发布,应用了一致的类别分配、地理标签、重复过滤、安全过滤和类别内可比价格计算。数据文件名为 costinflation-period-care-atlas-prices-2026-07-21-to-2026-08-18.csv。