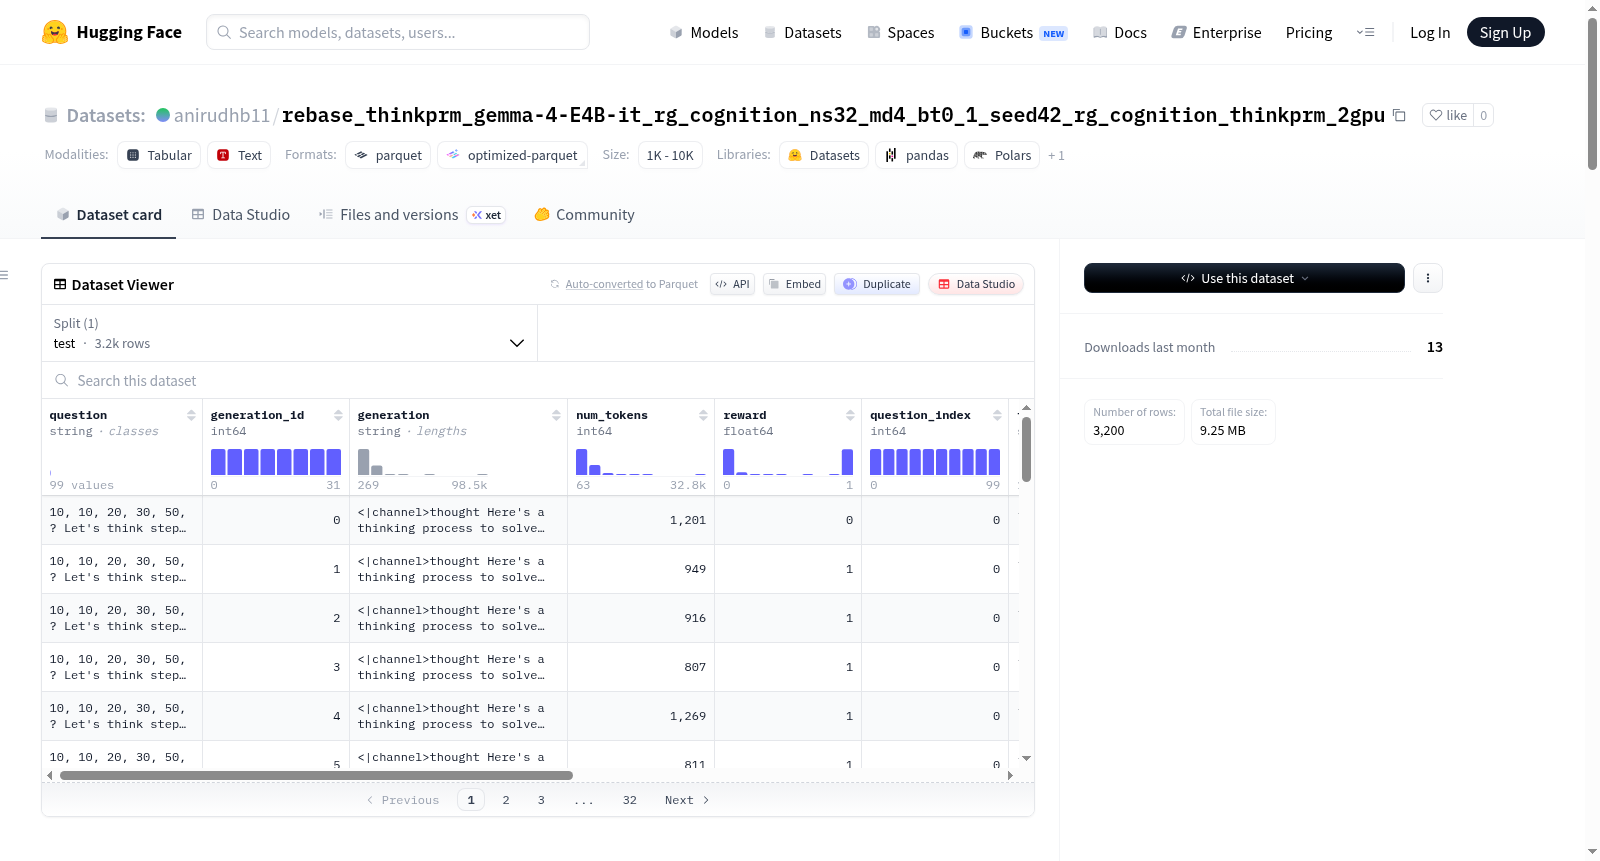
rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns32_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu
收藏资源简介:
该数据集包含3200个测试样本,总大小为36.6MB。数据集包含多个特征字段:问题文本(question)、生成ID(generation_id)、生成内容(generation)、token数量(num_tokens)、奖励分数(reward)、问题索引(question_index)、目标(target)、任务类型(task)、价值函数预测(vf_prediction)和级别(level)。数据集似乎与某种生成任务或评估任务相关,可能涉及多轮生成或不同级别的处理(level字段)。聚合指标部分显示了大量关于生成性能的指标,包括不同配置下的通过率、唯一答案数量、token统计和各级别处理时间等,表明这可能是一个用于评估生成模型或强化学习模型的数据集。
This dataset comprises 3200 test samples with a total size of 36.6 MB. It includes multiple feature fields: question text (field `question`), generation ID (`generation_id`), generated content (`generation`), token count (`num_tokens`), reward score (`reward`), question index (`question_index`), target (`target`), task type (`task`), value function prediction (`vf_prediction`), and level (`level`). This dataset appears to be related to generation or evaluation tasks, potentially involving multi-turn generation or multi-level processing as indicated by the `level` field. The aggregated metrics section contains numerous generation performance indicators, including pass rates under various configurations, counts of unique answers, token statistics, processing time per level, and others, suggesting that this dataset is designed for evaluating generative models or reinforcement learning models.
数据集概述
该数据集名为 rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns32_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu,托管于 Hugging Face Datasets。数据集主要包含与推理相关的问答数据,并附带了详细的性能指标。
数据集结构
数据集包含一个测试集(test),共 3200 个样本,下载大小为 9.23 MB,数据集总大小为 36.60 MB。
特征字段:
| 字段名 | 数据类型 | 说明 |
|---|---|---|
question |
string | 问题文本 |
generation_id |
int64 | 生成ID |
generation |
string | 生成的回答 |
num_tokens |
int64 | 生成的token数量 |
reward |
float64 | 奖励值 |
question_index |
int64 | 问题索引 |
target |
string | 目标答案 |
task |
string | 任务名称 |
vf_prediction |
float64 | 值函数预测 |
level |
int64 | 难度等级 |
聚合性能指标
数据集共聚合了 10 个分片,以下为关键性能指标:
主要评估指标(maj@k / pass@k):
| 指标 | 值 |
|---|---|
maj@1 |
0.470232 |
maj@8 |
0.506213 |
maj@16 |
0.493973 |
maj@32 |
0.495148 |
pass@1 |
0.448125 |
pass@8 |
0.596862 |
pass@16 |
0.627894 |
pass@32 |
0.65 |
其他关键指标:
- 平均响应Token数(
avg_response_tokens):2840.9 - 中位数响应Token数(
median_response_tokens):2049.8 - 生成阶段耗时(
generation_phase_time_s):1333.32 秒 - 总耗时(
total_time_s):1881.93 秒 - 总策略输出Token数(
total_policy_output_tokens):909,105 - 总评判输出Token数(
total_judge_output_tokens):4,117,400 - 总生成输出Token数(
total_generated_output_tokens):5,026,500 - 唯一答案数量(
num_unique_answers@1):0.929 - 唯一答案数量(
num_unique_answers@32):9.52
不同难度等级的输出Token数:
| 等级 | 策略输出Token数 | 评判输出Token数 |
|---|---|---|
| 等级 1 | 729,028 | 1,877,640 |
| 等级 2 | 131,681 | 453,921 |
| 等级 3 | 32,804.1 | 82,606.1 |
| 等级 4 | 14,300 | 49,392.3 |