worldcuisines-conflict
收藏资源简介:
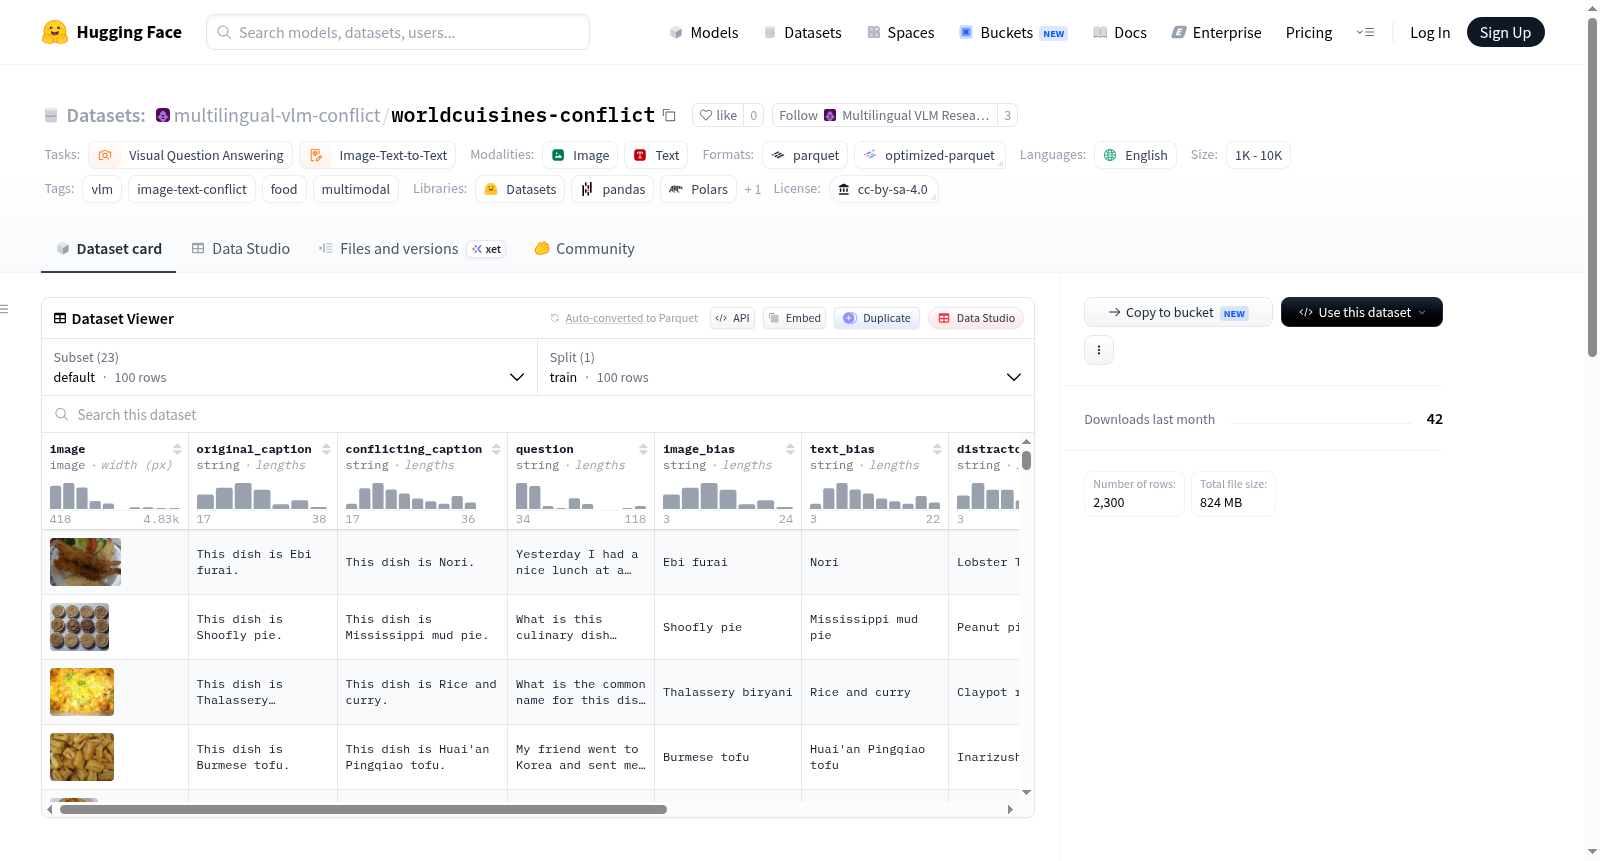
WorldCuisines Conflict是一个多语言图像-文本冲突数据集,旨在评估视觉语言模型在面临图像内容与文本描述不一致时的推理能力。该数据集基于worldcuisines/vqa数据集(任务1,英文提示)构建,遵循CC-BY-SA-4.0许可证。每个数据样本包含一张真实图像、一个忠实描述图像内容的原始文本描述、一个经过修改的冲突文本描述(通过精确改变原始描述中的一个对象或属性来人为制造语义冲突),以及一个关于被修改元素的提问。数据字段包括:图像、原始描述、冲突描述、问题、图像中存在的真实值、冲突描述所断言的值、一个与两者都不同的合理干扰项,以及序列号、冲突类型和语言标识。数据集规模为每种语言配置包含100个训练样本,总计样本数少于1,000,支持包括阿拉伯语、中文、德语、法语、日语、俄语、西班牙语等在内的24种语言配置。它属于multilingual-vlm-conflict系列,适用于视觉问答、图像-文本到文本生成等任务,尤其关注模型在食物相关多模态场景中处理信息冲突的鲁棒性评估。
WorldCuisines Conflict is a multilingual image-text conflict dataset developed to evaluate the reasoning abilities of vision-language models (VLMs) when encountering inconsistencies between image content and textual descriptions. This dataset is built upon the worldcuisines/vqa dataset (Task 1, English prompts) and is released under the CC-BY-SA-4.0 license. Each data sample includes a real-world image, an original textual description that accurately depicts the image content, a modified conflicting textual description that artificially introduces semantic conflicts by precisely altering one object or attribute in the original description, and a query regarding the modified element. The data fields consist of: image, original description, conflicting description, query, ground truth value present in the image, value asserted by the conflicting description, a plausible distractor that differs from both aforementioned values, serial number, conflict type, and language identifier. The dataset contains 100 training samples per language configuration, with a total sample count of less than 1,000, and supports 24 language configurations including Arabic, Chinese, German, French, Japanese, Russian, Spanish, and others. It falls under the multilingual-vlm-conflict series, and is suitable for tasks such as visual question answering and image-text to text generation, with a particular focus on evaluating model robustness when handling information conflicts in food-related multimodal scenarios.
数据集概述:WorldCuisines Conflict
基本信息
- 数据集名称: WorldCuisines Conflict
- 许可协议: CC-BY-SA-4.0
- 任务类别: 视觉问答 (visual-question-answering)、图像到文本 (image-text-to-text)
- 语言: 英语 (en)
- 标签: vlm, image-text-conflict, food, multimodal
- 数据规模: n<1K(少于1000个样本)
数据集来源与构建
- 来源: 基于 worldcuisines/vqa 数据集(任务1,英文提示)构建。
- 构建方法: 从源数据集中确定性地重新采样(种子=42),生成100个样本。
- 冲突机制: 每对样本包含一张图像、一个真实的原始描述(original_caption)和一个冲突描述(conflicting_caption)。冲突描述更改了原始描述中的一个对象或属性,从而制造图像-文本冲突。
- 资格归属: 该衍生数据集属于 multilingual-vlm-conflict 系列,与
rpg-conflict具有相同的模式。
数据特征
每个样本包含以下字段:
| 字段 (Feature) | 类型 (dtype) | 描述 |
|---|---|---|
image |
image | 图像(真实图像) |
original_caption |
string | 忠实于图像的描述 |
conflicting_caption |
string | 更改一个对象/属性后的冲突描述 |
question |
string | 关于被更改对象/属性的问题 |
image_bias |
string | 真实值(在图像中正确体现) |
text_bias |
string | 冲突描述所声称的更改后的值 |
distractor |
string | 一个合理的第三个选项,与 image_bias 和 text_bias 均不同 |
serial_no |
int64 | 来源标识符 |
conflict_type |
string | 冲突类型 |
language |
string | 描述语言(英语) |
- 核心逻辑:
image_bias是真实的菜品名称(即原始 VQA 的答案),text_bias是一个错误的选项(由冲突描述断言),distractor是另一个错误的选项。
数据切分与大小
- 切分: 只有一个训练集 (train),每个语言配置包含100个样本。
- 样本量: 每个子配置均为100个样本(共23个子配置,含
default)。 - 数据大小示例:
- 阿拉伯语 (ar): 约 35.82 MB
- 捷克语 (cs): 约 35.82 MB
- 德语 (de): 约 35.82 MB
- ...(其他语言类似,略)...
- 中文 (zh): 约 35.82 MB
- 所有配置的总样本数: 100 (每个配置) * 23 (个配置) = 2300 个样本(仅训练集)。
子配置 (Configs)
数据集包含23个子配置,对应于不同的语言或默认配置:
ar(阿拉伯语)cs(捷克语)de(德语)default(默认)el(希腊语)es(西班牙语)fa(波斯语)fr(法语)he(希伯来语)hi(印地语)id(印度尼西亚语)it(意大利语)ja(日语)ko(韩语)nl(荷兰语)pl(波兰语)pt(葡萄牙语)ro(罗马尼亚语)ru(俄语)tr(土耳其语)uk(乌克兰语)vi(越南语)zh(中文)
许可与协议
- 来源许可: 原始数据集 worldcuisines/vqa 采用 CC-BY-SA-4.0 许可。
- 衍生许可: 此衍生数据集同样采用 CC-BY-SA-4.0 许可。