
遇见数据集

shaswatamitra/falcon-yara-cti-rule

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

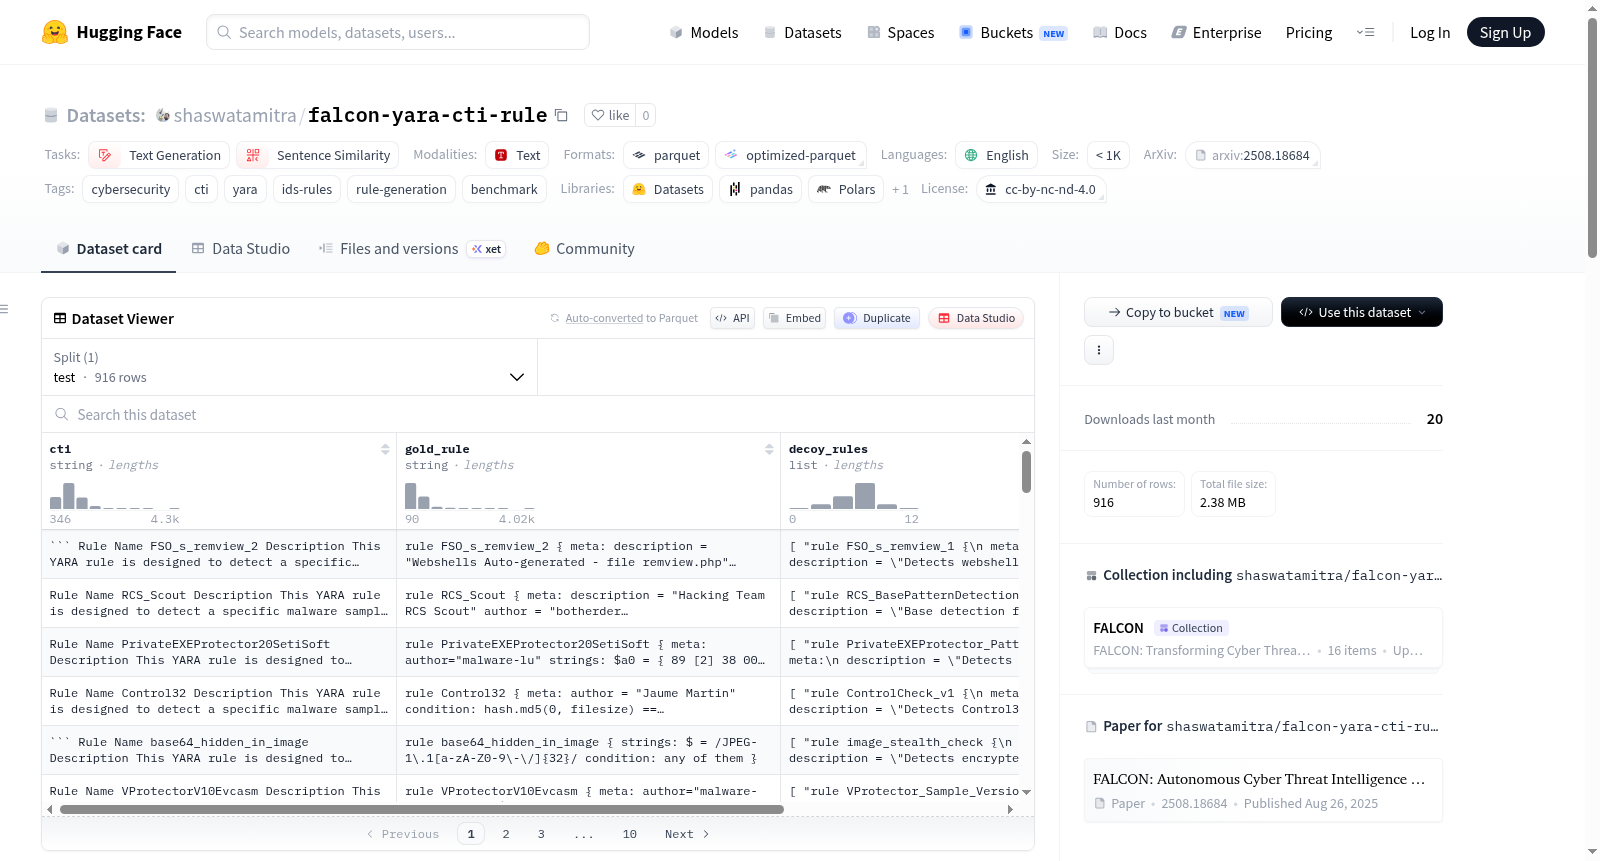
FALCON YARA CTI ↔ 真实规则数据集是一个网络安全基准数据集,包含网络威胁情报(CTI)描述及其对应的真实YARA规则,以及由大语言模型生成的诱饵规则(硬负样本相似规则)。该数据集是FALCON保留的测试集,用于评估大语言模型的规则生成能力,以及测试对比性微调句子编码器的检索性能。数据集包含916个CTI描述和5,106个诱饵规则,每个CTI平均有5.57个诱饵规则,范围在0到12之间。数据来源是从FALCON yara-rules微调语料库中确定性保留的10%测试分割,真实规则通过反转映射恢复。

FALCON YARA CTI ↔ Ground Truth Rule Dataset is a cybersecurity benchmark dataset that contains cyber threat intelligence (CTI) descriptions, their corresponding ground truth YARA rules, as well as decoy rules (hard negative similar rules) generated by Large Language Models (LLMs). This dataset is a test set retained by FALCON, which is used to evaluate the rule generation capability of LLMs and test the retrieval performance of contrastively fine-tuned sentence encoders. The dataset includes 916 CTI descriptions and 5,106 decoy rules, with an average of 5.57 decoy rules per CTI, ranging from 0 to 12. The data originates from the 10% test split deterministically retained from the FALCON yara-rules fine-tuning corpus, and the ground truth rules are recovered through inverse mapping.
提供机构:
shaswatamitra
搜集汇总
数据集介绍
shaswatamitra/falcon-yara-cti-rule 数据集图片
构建方式
该数据集源自FALCON项目,基于网络安全威胁情报(CTI)描述与对应的真实YARA规则(ground-truth rule)构建而成。研究团队从yara-rules微调语料库中,以10%的固定比例(随机种子SEED=42)确定性划分出测试集,并通过逆映射方法从parquet文件yara-rules_v1.pkl与v2.pkl中恢复出真值规则。对于每条保留的CTI,数据集同步关联了由大语言模型生成的干扰规则(decoy rules)——这些与公开的伴随诱饵数据集中的硬负样本完全一致。最终共收录916条CTI描述及5106条诱饵规则,平均每条CTI对应5.57条诱饵。
特点
该基准测试数据集具有鲜明的领域特色与对抗性评估设计。其核心特点在于引入了LLM生成的诱饵规则作为硬负样本,这些规则在语义上与真值规则高度相似但对模型构成显著判别挑战,从而为检索任务提供了高难度测试环境。数据集的CTI描述与规则形成天然一对多映射关系,兼顾了LLM规则生成评估(精确匹配)与对比学习句子编码器检索测试(排序性能)两种评估范式。整个数据集仅包含单一测试划分,严格禁止用于训练。
使用方法
数据集可通过HuggingFace的datasets库便捷加载,调用load_dataset("shaswatamitra/falcon-yara-cti-rule", split="test")即可获取。其核心使用场景分为两类:其一,面向LLM规则生成任务,研究者可向模型输入CTI描述并生成YARA规则,随后与gold_rule字段进行精确匹配评分;其二,面向对比学习句子编码器评估,需基于每条CTI将其真值规则从诱饵规则列表中正确检索排序。数据集中cti、gold_rule及decoy_rules字段分别提供结构化访问接口,num_decoys字段便于根据诱饵数量进行筛选过滤。
背景与挑战
背景概述
在网络安全领域,威胁情报(Cyber Threat Intelligence, CTI)与入侵检测规则(如YARA规则)的自动生成已成为研究热点。该数据集由Shaswata Mitra等学者于2025年创建,源自FALCON项目,旨在解决LLM在网络安全规则生成中的评估与检索难题。核心研究问题在于如何通过CTI描述精确匹配对应的YARA规则,并区分真实规则与混淆样本。该数据集包含916条CTI描述及其对应的ground-truth YARA规则,并配以LLM生成的诱饵规则(hard-negative样本),共计5,106条诱饵规则。作为FALCON工作的基准测试集,它对网络安全领域的自动化规则生成和对比学习检索研究具有重要推动作用,为评估模型在CTI-to-rule映射中的鲁棒性和准确性提供了标准化平台。
当前挑战
该数据集面临的首要挑战是领域问题的复杂性:CTI描述与YARA规则之间存在的语义鸿沟,使精确匹配面临困难,尤其当诱饵规则在形式上高度相似时,模型需具备极强的辨别能力。此外,构建过程中的挑战包括:黄金规则需要通过逆映射从语料库中恢复,过程需保证无信息丢失;诱饵规则由LLM生成,其难易程度和多样性控制需精细调校,以防过易或过难影响评估有效性;数据集规模较小(不足1K条),但需确保每条CTI的关联规则唯一且准确,这要求严格的数据验证与清洁流程。这些挑战共同要求模型在规则生成与检索任务中同时兼顾语义理解、抗噪性和判别能力。
常用场景
经典使用场景
在网络威胁情报与入侵检测系统规则生成的交叉领域,falcon-yara-cti-rule数据集最经典的使用场景在于评估大语言模型生成YARA规则的能力。研究者通过向LLM输入结构化的CTI描述文本,要求其输出对应YARA规则,并与数据集中保存的ground-truth规则进行精确匹配评分,从而量化模型在自动化威胁规则生成任务上的表现。该基准为LLM驱动的安全智能体提供了严格的评测范式,推动了网络安全领域从人工编写规则向智能化、自动化规则生成的技术演进。
衍生相关工作
围绕falcon-yara-cti-rule数据集已衍生出一系列具有影响力的研究工作。其核心贡献源于FALCON系统,该工作首次提出利用大语言模型进行自主网络威胁情报挖掘与IDS规则生成,并系统性评估了多种LLM架构在此任务上的表现。数据集中包含的精心构造的诱饵规则集合,启发了后续针对对比学习句子编码器的改进研究,研究者们通过使用该基准作为检索测试集,开发出更精准的威胁情报-规则匹配模型。此外,该数据集为规则生成领域的标准评估框架奠定了参考基础,催生了多项专注于提升LLM在网络安全领域生成准确性的微调策略与提示工程方法研究。
数据集最近研究
最新研究方向
在网络安全领域,威胁情报与入侵检测规则的自动生成正成为前沿热点,falcon-yara-cti-rule数据集专为评估大型语言模型(LLM)在YARA规则生成任务中的表现而设计。该数据集将真实威胁情报描述与对应的标准YARA规则配对,并引入LLM生成的干扰规则作为硬负样本,构建了一个严谨的基准测试集。其核心应用方向聚焦于两个方面:一是通过精确匹配评分衡量LLM生成规则的质量,二是作为检索任务的测试场,验证对比学习句子编码器在区分真实规则与相似干扰项上的效能,有力推动了安全自动化与智能威胁检测领域的研究进展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

