courtlistener
收藏资源简介:
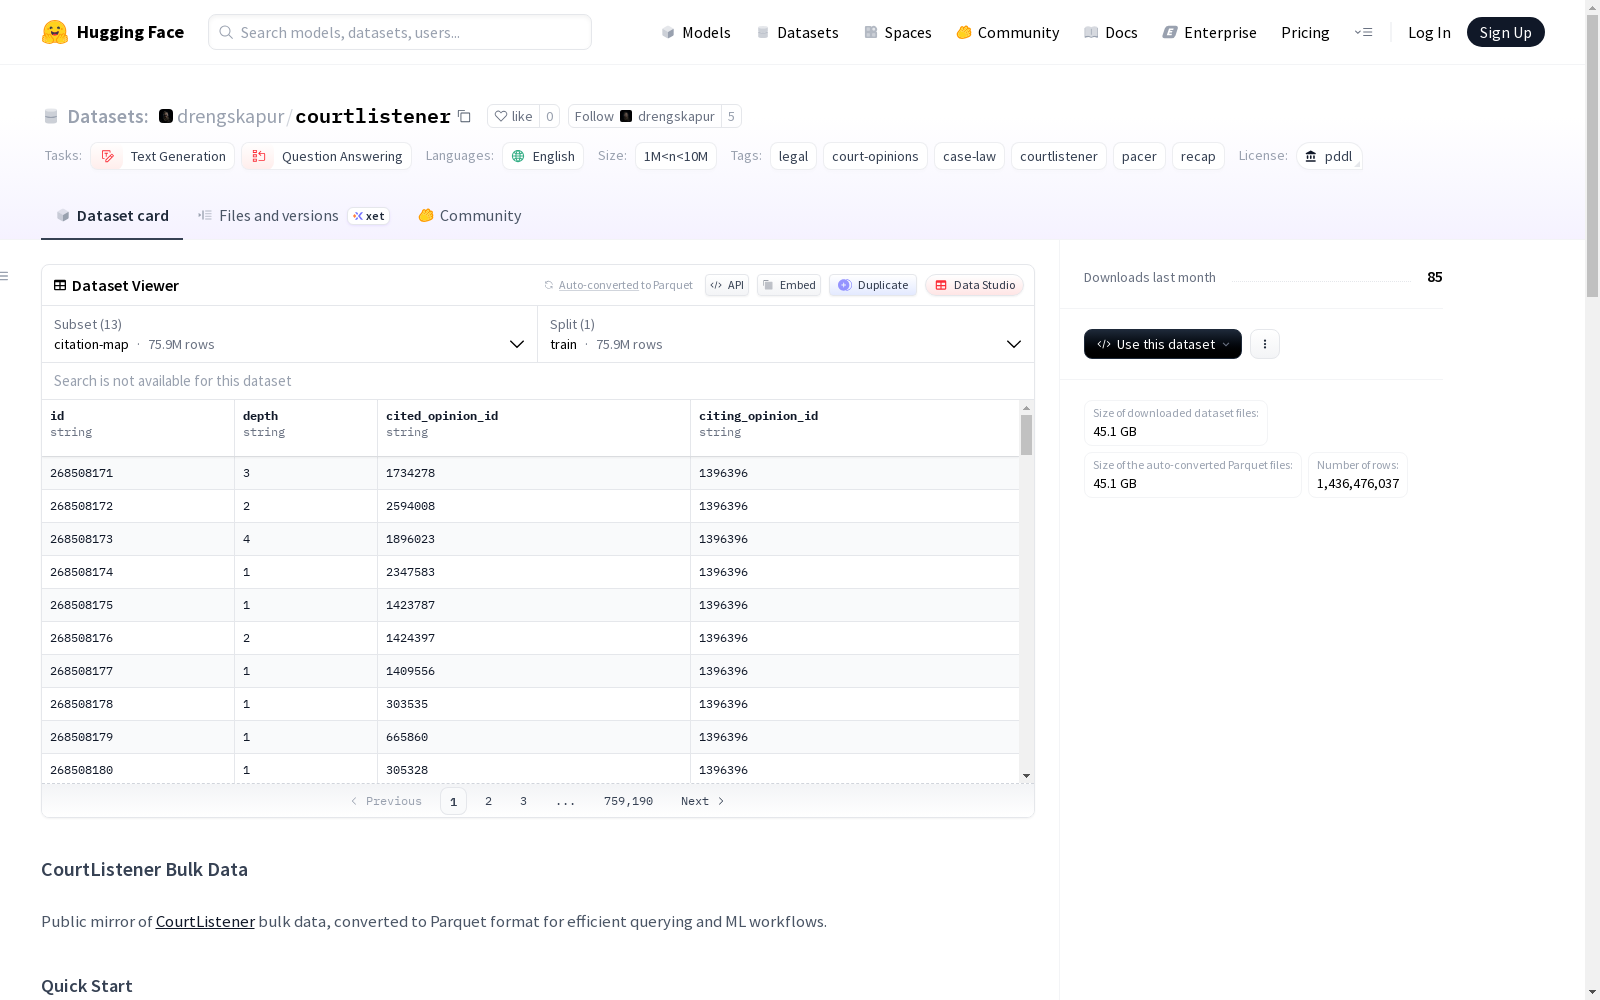
这是一个CourtListener批量数据的公开镜像数据集,已转换为Parquet格式以便高效查询和机器学习工作流。数据集包含多个配置,如法院元数据(700+法院)、意见集群(案例元数据和摘要,约9M行)、完整意见文本(约9M行)、RECAP摘要元数据(约20M行)、引用参考(约50M行)、引用图边(约50M行)、法院撰写的案例摘要(约10M行)、法官信息(约16K行)、法官职位(约30K行)、法官财务披露(约1.7M行)、口头辩论元数据(约200K行)和FJC联邦案例数据(约8M行)。数据集来源于CourtListener,由Free Law Project提供,采用公共领域奉献和许可证(PDDL)。
This is a public mirror dataset of CourtListener bulk data, converted to Parquet format to support efficient querying and machine learning workflows. The dataset includes multiple data subsets: court metadata (over 700 courts), opinion clusters (case metadata and summaries, ~9M rows), full opinion texts (~9M rows), RECAP summary metadata (~20M rows), citation references (~50M rows), citation graph edges (~50M rows), court-authored case summaries (~10M rows), judge information (~16K rows), judge positions (~30K rows), judge financial disclosures (~1.7M rows), oral argument metadata (~200K rows), and FJC Federal Case Data (~8M rows). The dataset is sourced from CourtListener, provided by the Free Law Project, and licensed under the Public Domain Dedication and License (PDDL).
CourtListener数据集概述
数据集基本信息
- 数据集名称: CourtListener Bulk Data
- 托管地址: https://huggingface.co/datasets/drengskapur/courtlistener
- 数据来源: CourtListener (https://www.courtlistener.com/) 批量数据,由Free Law Project (https://free.law/) 提供
- 许可协议: Public Domain Dedication and License (PDDL)
- 主要任务: 文本生成、问答
- 语言: 英语
- 数据规模: 1M < n < 10M
- 领域标签: 法律、法院意见、判例法、courtlistener、pacer、recap
数据配置与内容
数据集包含多个配置,每个配置对应不同的数据子集,均以Parquet格式存储。
| 配置名称 | 描述 | 数据量 |
|---|---|---|
opinion-clusters |
案件元数据和摘要 | 约900万行 |
opinions |
完整的意见书文本 | 约900万行 |
courts |
法院元数据(700多个法院) | 约700行 |
dockets |
RECAP案件摘要元数据 | 约2000万行 |
citations |
引用参考文献 | 约5000万行 |
citation-map |
引用图谱边 | 约5000万行 |
parentheticals |
法院撰写的案件摘要 | 约1000万行 |
people-db-people |
法官信息 | 约1.6万行 |
people-db-positions |
法官职位信息 | 约3万行 |
financial-disclosures |
法官财务披露信息 | 约170万行 |
oral-arguments |
口头辩论元数据 | 约20万行 |
fjc-integrated-database |
联邦司法中心综合数据库案件数据 | 约800万行 |
数据访问方式
通过Hugging Face datasets库加载
python from datasets import load_dataset cases = load_dataset("drengskapur/courtlistener", "opinion-clusters", split="train") courts = load_dataset("drengskapur/courtlistener", "courts", split="train")
通过HuggingFace Datasets Server API访问(无需下载)
- 获取行数据:
https://datasets-server.huggingface.co/rows?dataset=drengskapur/courtlistener&config=courts&split=train&length=10 - 全文搜索:
https://datasets-server.huggingface.co/search?dataset=drengskapur/courtlistener&config=opinion-clusters&split=train&query=qualified%20immunity - SQL式过滤:
https://datasets-server.huggingface.co/filter?dataset=drengskapur/courtlistener&config=courts&split=train&where=jurisdiction=F
通过DuckDB查询(无需下载)
sql INSTALL httpfs; LOAD httpfs; SELECT case_name, date_filed, citation_count FROM hf://datasets/drengskapur/courtlistener/data/opinion-clusters/*.parquet WHERE court_id = scotus ORDER BY citation_count DESC LIMIT 10;