遇见数据集

hr_policy_asst_non_instruction_dataset_v0

收藏
Hugging Face2026-07-03 更新2026-07-04 收录
官方服务:

资源简介:

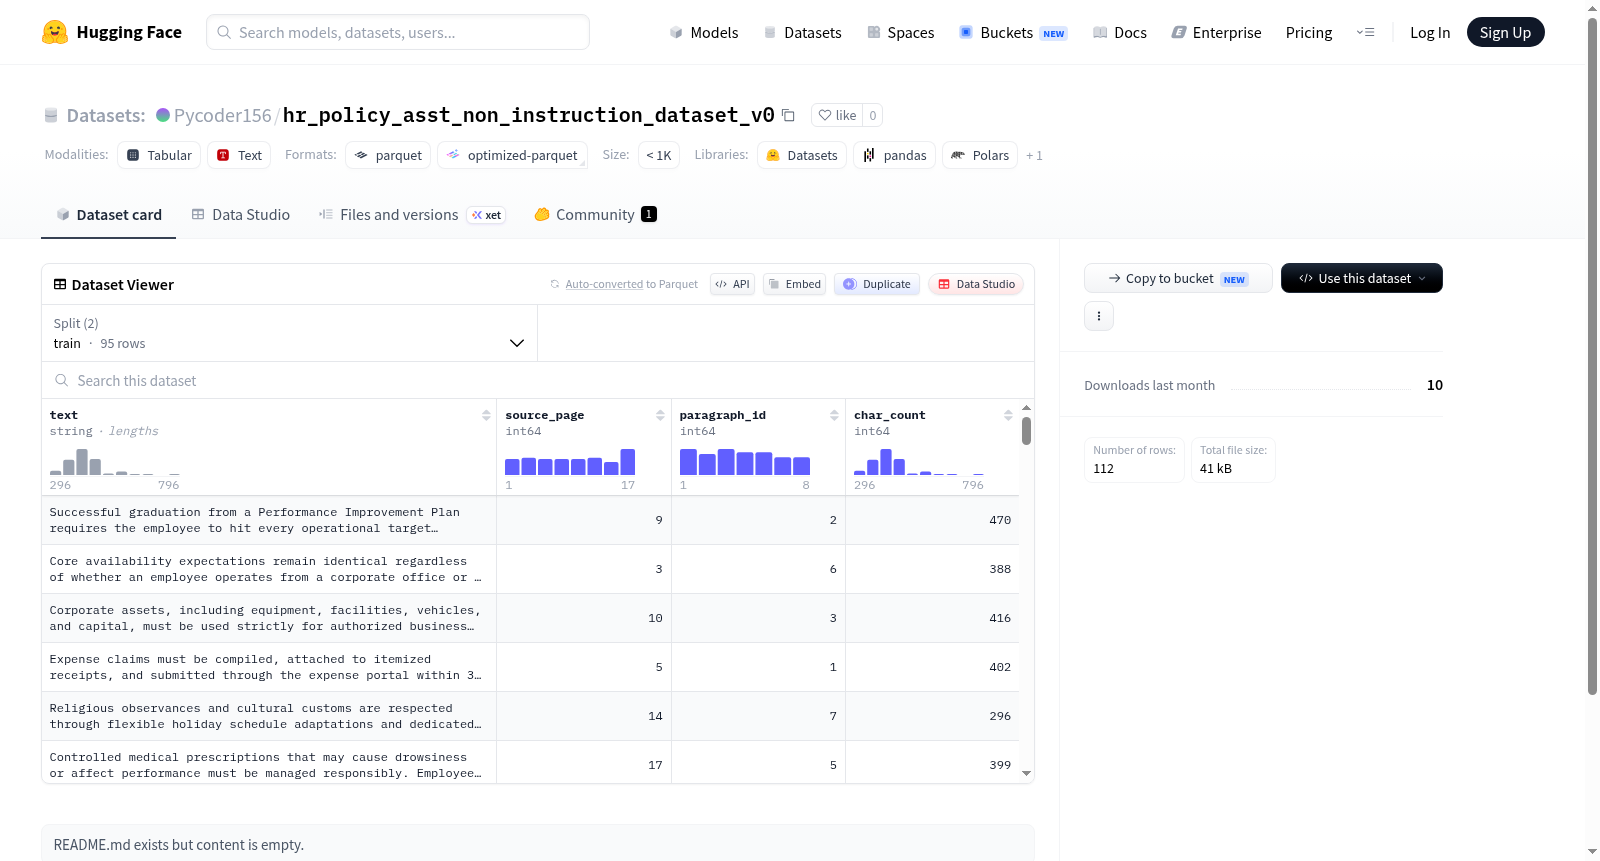
该数据集包含从文档或网页中提取的文本段落数据,每个样本代表一个独立的文本段落,并附带相关的元数据信息。数据集共包含112个样本,划分为训练集(95个样本)和验证集(17个样本)。每个样本包含四个字段:text(文本内容,字符串类型)、source_page(来源页面编号,整型)、paragraph_id(段落标识符,整型)和char_count(文本的字符计数,整型)。这些元数据可用于追踪文本来源和结构。数据集适用于文本分析、信息检索、自然语言处理中的段落级建模或作为其他任务的预处理数据。

This dataset comprises text paragraph data extracted from documents or webpages. Each sample represents an independent text paragraph and is accompanied by relevant metadata. The dataset includes a total of 112 samples, split into a training set (95 samples) and a validation set (17 samples). Each sample contains four fields: text (text content, string type), source_page (source page number, integer type), paragraph_id (paragraph identifier, integer type), and char_count (character count of the text, integer type). This metadata can be used to trace the source and structure of the text paragraphs. This dataset is applicable for text analysis, information retrieval, paragraph-level modeling in natural language processing, or as preprocessed data for other downstream tasks.

创建时间:
2026-07-02
原始信息汇总

数据集概述

  • 数据集名称: hr_policy_asst_non_instruction_dataset_v0
  • 数据集地址: https://huggingface.co/datasets/Pycoder156/hr_policy_asst_non_instruction_dataset_v0
  • 数据集类型: 非指令格式的文本数据集

数据特征

该数据集包含以下字段:

  • text: 字符串类型,存储文本内容。
  • source_page: 整数类型,表示来源页面编号。
  • paragraph_id: 整数类型,表示段落编号。
  • char_count: 整数类型,表示字符数量。

数据划分

数据集分为训练集和验证集:

  • 训练集 (train): 95 个样本,字节数为 43990。
  • 验证集 (validation): 17 个样本,字节数为 7871。

数据集规模

  • 下载大小: 38012 字节
  • 数据集总大小: 51861 字节

配置文件

  • 配置名称: default
  • 数据文件路径:
    • 训练集: data/train-*
    • 验证集: data/validation-*
搜集汇总
数据集介绍
hr_policy_asst_non_instruction_dataset_v0 数据集图片
构建方式
该数据集以人力资源管理政策为核心领域,采用非指令式文本结构进行构建。数据来源于内部人力资源管理文件,经过分段落标号与去重处理后,形成包含95条训练样本与17条验证样本的高质量文本集合。每一条样本均蕴含着完整的政策上下文信息,并附带原始来源页面编号与段落标识,以保证信息的可溯源性。字符长度统计的纳入进一步提升了数据筛选的灵活性。
使用方法
在使用时,可直接加载'text'字段作为非指令式文本用于预训练或领域适应微调,或结合'char_count'字段进行长度过滤。各段落按'source_page'与'paragraph_id'可重建文档上下文,便于长文本理解任务的构建。推荐的典型应用包括基于政策语义的文本检索、段落级别的重排序训练以及内部政策知识库的嵌入生成。
背景与挑战
背景概述
该数据集名为hr_policy_asst_non_instruction_dataset_v0,专注于人力资源管理政策领域的非指令式文本数据收集。尽管其创建时间、主要研究人员或机构信息未在提供内容中明确,但此类数据集通常服务于企业人力资源管理智能化研究,核心问题在于如何利用非结构化政策文本辅助人力资源决策或合规性审查。数据集包含95个训练样本和17个验证样本,来源为政策文本段落,字段涵盖文本内容、来源页面及字符数等元数据,为政策文本理解、实体抽取或政策分类等任务提供了基础资源,对推动自然语言处理在人力资源领域的应用具有潜在价值。
当前挑战
该数据集所解决的领域问题在于,人力资源管理政策文本通常缺乏标准化结构,传统规则或模型难以高效提取关键信息,其挑战包括:1)领域问题层面,政策文本语言高度专业化、表述多样,且蕴含隐性逻辑关联,亟需数据集支撑语义理解与知识抽取;2)构建过程中,数据规模极小(仅112条),易导致模型过拟合或泛化能力不足,同时需确保文本来源的权威性与覆盖性,并处理段落切割带来的上下文连贯性缺失问题。
常用场景
经典使用场景
在企业人力资源管理的智能化转型进程中,hr_policy_asst_non_instruction_dataset_v0数据集扮演着基础语料库的关键角色。该数据集精心收录了95条训练样本与17条验证样本,每条样本以‘text’字段承载具体的人力资源政策文本内容,辅以‘source_page’与‘paragraph_id’精确定位政策来源与段落归属。其经典使用场景集中于构建非指令式的政策理解与检索系统,使得大型语言模型能够在不依赖显式指令模板的前提下,通过语义匹配与上下文学习,自动解析并回答员工关于休假制度、绩效考核、薪酬福利等高频政策查询,从而为企业打造高效、准确的内部政策智能助手奠定数据基石。
解决学术问题
该数据集在学术界主要回应了专业领域非结构化文本的语义建模难题。传统通用数据集往往忽视企业内部政策文本独特的术语体系与逻辑结构,而hr_policy_asst_non_instruction_dataset_v0通过提供纯净、标注明确的政策段落,支持研究者探索如何利用预训练语言模型捕捉政策文本中的条件逻辑、层级关系与隐含约束。它为少样本学习、零样本推理以及领域自适应等前沿课题提供了可控的实验载体,推动人力资管领域从规则驱动的知识库系统向数据驱动的语义理解范式演进,深刻影响了领域对复杂政策性文本的自动化处理能力认知。
实际应用
实际应用中,该数据集赋能了企业级人力资源智能助手产品的核心功能开发。基于此数据集训练的模型能够直接嵌入企业内网门户或即时通讯工具,自动响应员工关于入职流程、请假申请、培训名额等标准化政策询问,显著降低HR部门重复性咨询的人力成本。此外,数据集支持政策版本更新后的快速模型微调,确保智能助手始终与最新人力资源制度保持同步。它也常被用于构建政策推演系统,在员工提出复杂跨条款问题时,模型能依据段落关联性自动整合多源政策信息,提供综合性解答。
数据集最近研究
最新研究方向
该数据集聚焦于人力资源管理政策领域的非指令性文本构建,为微调大型语言模型以理解企业规章、员工手册等非结构化政策文档提供了基础资源。当前前沿研究方向包括利用此类数据集增强模型对复杂组织规则的语义解析能力,并探索将其与检索增强生成(RAG)技术结合,以提升智能HR助手在合规咨询、政策问答等场景下的精准度与上下文感知能力。这一方向契合企业数字化转型中对自动化政策解释与知识管理的迫切需求,对于推动AI在人力资源管理中的可信应用具有重要意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务