
nassimjp/s1K-DeepSeek-V4-Flash-Max-Thinking
收藏官方服务:
资源简介:
一个精心策划的高质量蒸馏数据集、推理轨迹和微调管道的集合,使用DeepSeek V4 Flash(Max Thinking)教师模型生成。
A carefully curated collection of high-quality distillation datasets, inference trajectories, and fine-tuning pipelines, generated using the DeepSeek V4 Flash (Max Thinking) teacher model.
提供机构:
nassimjp搜集汇总
数据集介绍
构建方式
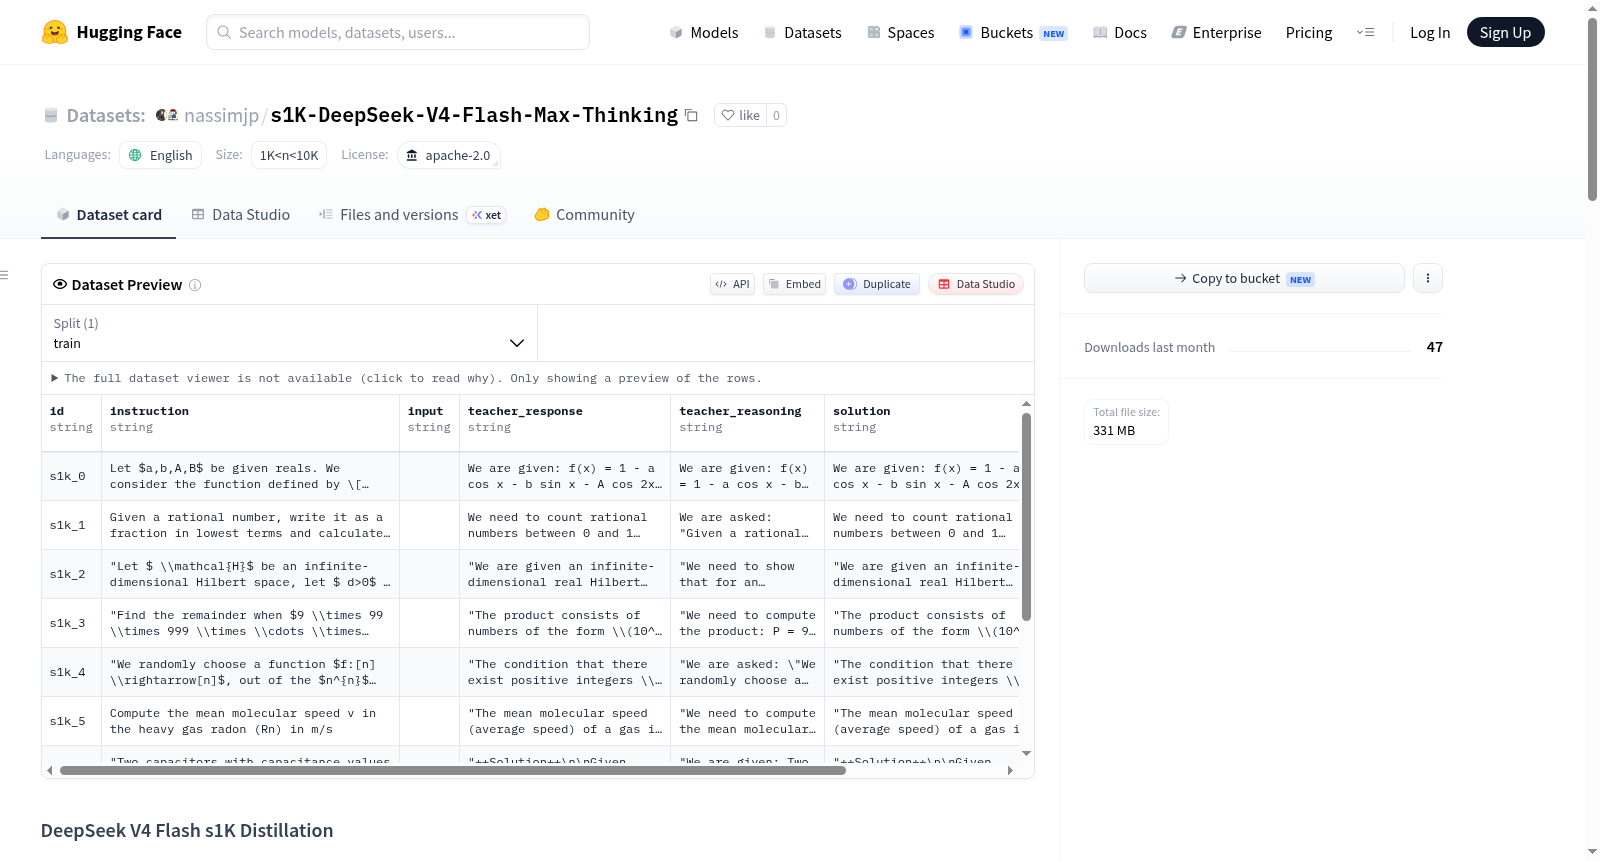
该数据集基于知识蒸馏范式构建,选取DeepSeek V4 Flash(Max Thinking)作为教师模型,对s1K基础数据集进行推理轨迹与响应的高质量蒸馏。通过教师模型在Max Thinking模式下生成的丰富token输出,包括详细的推理过程与最终答案,构建了涵盖多种格式的蒸馏数据集。数据经过多轮清洗与结构化处理,最终形成包含原始元数据、ShareGPT格式、Alpaca格式、OpenAI微调格式、TRL格式、纯文本格式以及显式思维链格式在内的七种子集,以适配不同的训练框架与下游任务。
特点
该数据集的核心优势在于其极致的性价比与丰富的数据多样性。教师模型DeepSeek V4 Flash在Max Thinking模式下虽产生大量输出token,但凭借其极低的token定价,使得总成本仅为6.49美元,却获得了超过2300万token的高质量推理数据。数据集在知识推理、长上下文理解与智能体任务等多个基准上均展现出卓越性能,如MMLU-Pro达86.2、GPQA Diamond达88.1、Terminal Bench 2.0达56.9。多种格式的结构化设计使其能够无缝适配从传统监督微调到先进强化学习训练的不同场景。
使用方法
使用者可根据自身训练框架选择对应的子集文件。若采用ShareGPT数据加载器,可直接使用02_sharegpt.jsonl;若基于Alpaca或SFT流水线,则选用03_alpaca.jsonl;面向OpenAI微调API或Hugging Face TRL/SFTTrainer的开发者,可分别加载04_openai_chat_finetune.jsonl与05_trl_messages.jsonl。对于需要显式思维链蒸馏的研究,07_reasoning_traces.jsonl提供了完整的推理过程数据。各文件均包含清晰的字段结构,便于快速集成至训练流程中,无需额外处理即可启动微调或蒸馏实验。
背景与挑战
背景概述
在大规模语言模型(LLM)蒸馏领域,如何以极低的成本获取高质量推理轨迹与智能体能力已成为核心研究课题。s1K-DeepSeek-V4-Flash-Max-Thinking数据集由社区研究者在Simple Scaling s1项目基础上构建,基于DeepSeek V4 Flash(Max Thinking)教师模型,于2025年生成并发布。该数据集聚焦于将顶尖模型的链式思维推理与智能体决策能力蒸馏至更小参数量模型,其核心研究问题在于验证高性价比蒸馏管道的有效性。利用DeepSeek V4 Flash在MMLU-Pro、GPQA Diamond、SWE Verified等基准上展现的卓越性能(如88.1% GPQA Diamond通过率、79.0% SWE Verified解决率),该数据集为开源社区提供了一套兼具通用对话格式与明确思维链标注的多样化数据形式。其对相关领域的影响在于,通过仅需6.49美元的总成本生成2300万+输出token,打破了高质量蒸馏数据获取的昂贵壁垒,推动了低成本高效LLM蒸馏范式的普及。
当前挑战
该数据集所解决的领域问题挑战在于:现有蒸馏方法常面临教师模型输出token成本高昂、学生模型难以捕获复杂推理与智能体协作能力的困境。构建过程中的核心挑战包括:其一,需在教师模型的Max Thinking模式下平衡输出高token量与极低单价(输出tokens仅6.45美元)之间的性价比最优化;其二,必须设计统一的数据标准化流程,将原始教师响应(含推理轨迹、智能体调用等)转化为ShareGPT、Alpaca、OpenAI微调API等多框架兼容格式,确保数据无缝融入不同训练管线;其三,面对DeepSeek V4 Flash在长期上下文(如MRCR 1M 78.7% MMR)和智能体基准上的强劲表现,如何精准提炼其决策逻辑(如工具使用、多步规划)并避免噪声注入,成为维持蒸馏后模型性能的关键瓶颈。
常用场景
经典使用场景
s1K-DeepSeek-V4-Flash-Max-Thinking数据集最为经典的使用场景是对大型语言模型进行知识蒸馏与微调。研究者可利用该数据集中由DeepSeek V4 Flash(Max Thinking)教师模型生成的高质量推理轨迹与指令响应,训练出在性能与效率上接近教师模型的学生模型。该数据集提供了多种格式(如ShareGPT、Alpaca、OpenAI Chat等),兼容主流的微调框架(如HuggingFace TRL),极大降低了蒸馏流程的工程门槛。尤其在需要兼顾推理深度与低推理成本的场景中,该数据集成为构建轻量级但高智能水平模型的理想基石。
实际应用
实际应用层面,该数据集赋予开发者以极低代价部署高性能推理引擎的可行性。基于其蒸馏生成的学生模型可无缝嵌入对话系统、代码辅助工具及智能体平台(如SWE-Bench环境),在资源受限的移动端或边缘设备上实现近似教师模型的回答质量。数据集本身的极低成本(约6.5美元生成2300万Token)也使得中小团队能够绕过昂贵的预训练与API调用,专注于垂直领域(如法律、医疗)的定向调优,加速AI产品的落地周期。
衍生相关工作
该数据集衍生的经典工作首先可追溯至其源头项目s1K(Simple Scaling s1),后者开创了“简单缩放”范式下高质量小样本蒸馏的路线。同时,数据集采用DeepSeek V4 Flash在Max Thinking模式下生成的超长推理路径,为后续研究如多步骤信任域蒸馏、推理轨迹过滤及混合师生架构提供了基准配方。在智能体与工具调用领域,其蒸馏模板也被应用于RLHF-free的偏好对齐方法中,衍生出更轻量的Agent微调框架,形成围绕“极小成本撬动极致智能”主题的系列创新工作。
以上内容由遇见数据集搜集并总结生成


