
遇见数据集

dh-unibe/kurrent-hanse-xvi-test-lines-augment

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

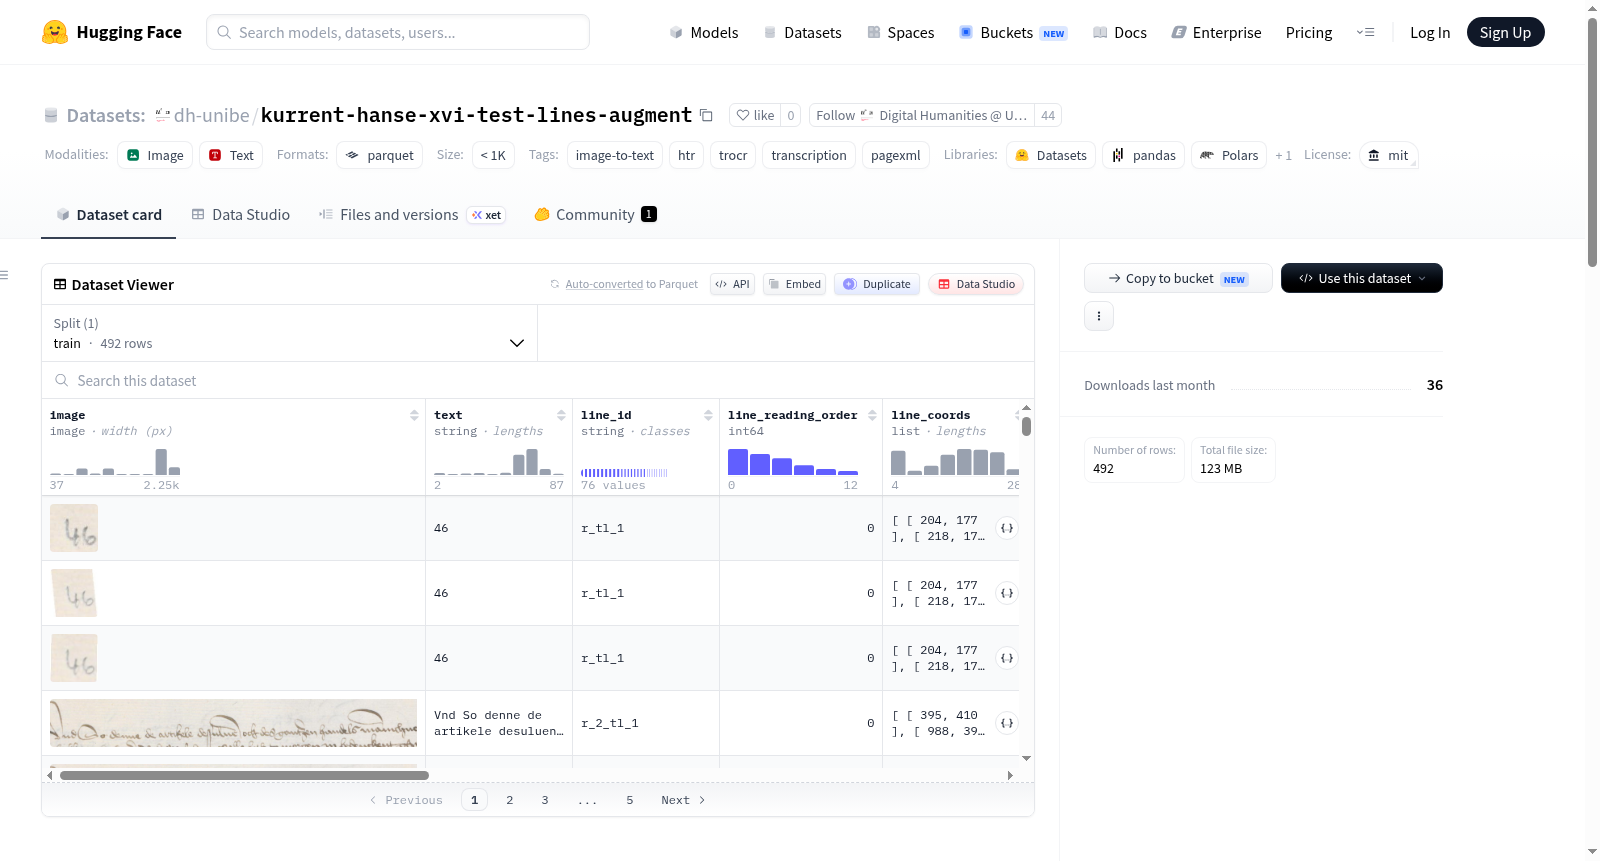
该数据集名为kurrent-hanse-xvi-test-lines-augment,是通过Transkribus PageXML数据使用pagexml-hf转换器创建的。它包含492个样本,全部用于训练集,总大小约为33.52 MB。数据集主要用于图像到文本任务,特别是手写文本识别(HTR)、TrOCR模型训练和转录应用。每个样本包括图像字段(不进行解码)、文本内容、行和区域的元数据(如ID、阅读顺序、坐标、基线、增强类型)、文件名和项目名称。数据组织为Parquet分片格式,按分割和项目名称分类。标签涉及手写识别和转录,许可证为MIT。数据集包含一个历史文档项目:1505-02-10_Hanserezess,_Lübeck_Dienstag_nach_Scholastice_1505_(SAHST_Rep__2,_I_040-4),旨在支持历史文档的数字化和转录研究。

This dataset, named kurrent-hanse-xvi-test-lines-augment, was constructed from Transkribus PageXML data via the pagexml-hf converter. It contains 492 samples, all assigned to the training split, with a total size of approximately 33.52 MB. This dataset is primarily intended for image-to-text tasks, particularly handwritten text recognition (HTR), TrOCR model training and transcription applications. Each sample includes an undecoded image field, text content, metadata for lines and regions (including ID, reading order, coordinates, baseline, augmentation type), filename and project name. The data is organized in Parquet shard format, categorized by data split and project name. Labels are related to handwritten recognition and transcription, and the dataset is licensed under MIT. The dataset includes one historical document project: 1505-02-10_Hanserezess,_Lübeck_Dienstag_nach_Scholastice_1505_(SAHST_Rep__2,_I_040-4), which aims to support research on the digitization and transcription of historical documents.
提供机构:
dh-unibe
搜集汇总
数据集介绍
dh-unibe/kurrent-hanse-xvi-test-lines-augment 数据集图片
构建方式
本数据集基于Transkribus PageXML数据,通过pagexml-hf转换工具精心构建而成。数据源自历史文献项目“1505-02-10_Hanserezess,_Lübeck_Dienstag_nach_Scholastice_1505_(SAHST_Rep__2,_I_040-4)”,涵盖了492个训练样本。在构建过程中,对原始的行图像进行了两种特定的数据增强操作,以提升模型的泛化能力。数据以Parquet格式分片存储,按数据集划分(split)与项目名称(project_name)组织目录结构,加载时由HuggingFace Hub自动合并所有分片文件。
特点
该数据集专为历史手写体文本识别(HTR)任务设计,核心特色在于其详尽的行级与区域级标注信息。每条样本包含图像、转录文本(text)、唯一行标识符(line_id)、阅读顺序(line_reading_order)、坐标多边形(line_coords)、基线(line_baseline)以及增强类型(line_augmentation)等字段。区域层面亦提供标识符、阅读顺序、类型及坐标等结构化数据。这种多维度的精细标注为训练如TrOCR等端到端图像到文本模型提供了丰富的监督信号。
使用方法
使用HuggingFace Datasets库即可便捷加载。通过`load_dataset("jwidmer/kurrent-hanse-xvi-test-lines-augment")`加载全部数据,或指定`split="train"`参数获取训练集。加载后的数据集对象可直接用于PyTorch或TensorFlow等深度学习框架的训练流程。数据集的图像特征采用惰性解码模式(decode=False),用户可根据需要灵活控制图像加载与预处理步骤,特别适合与数据加载器(DataLoader)配合,高效开展模型训练与评估。
背景与挑战
背景概述
在历史文档数字化与光学字符识别(OCR)领域,手写文本识别(HTR)技术面临诸多挑战,尤其是针对古德语库伦特手写体(Kurrent)的识别。由研究者jwidmer主导创建的kurrent-hanse-xvi-test-lines-augment数据集,源自Transkribus平台上的PageXML标注数据,聚焦于16世纪汉萨联盟文献的转录。该数据集发布于HuggingFace,包含492个训练样本,并引入了2种数据增强策略,旨在推动低资源历史手写体的自动识别研究。其核心研究问题在于如何通过有限标注样本构建鲁棒的端到端文本识别模型,对古籍数字化、历史文献分析及文化遗产保护领域具有重要参考价值。
当前挑战
当前数据集面临的核心挑战包括:首先,需解决手写文本识别领域普遍存在的域适配问题,库伦特字体与标准拉丁字母的视觉差异显著,且历史文档中墨迹渗化、纸张破损等现象加剧了特征提取难度。其次,构建过程中遭遇标注稀缺与技术瓶颈,原始PageXML数据仅包含单项目源文档,样本量仅492条,虽经增强处理仍不足以覆盖字形变体与书写风格多样性。此外,坐标与基线标注需人工精校,跨区域转录顺序的语义一致性校验亦构成流程性障碍,制约了数据集在跨文档泛化场景中的应用潜力。
常用场景
经典使用场景
在历史文档分析与光学字符识别领域,该数据集主要被用于训练和评估手写文本识别模型,特别是针对16世纪哥特体(Kurrent)手写文献的转录任务。研究人员通常将其作为TROCR等图像到文本模型的微调基准,通过其提供的页面级坐标、基线信息和行级注释,实现对历史手稿中复杂排版与连笔字体的精准识别。
衍生相关工作
基于该数据集的特性,衍生出多项经典工作。例如,研究者利用其多粒度标注结构(行级、区域级、基线坐标)开发了结合版面分析与文本识别的端到端流水线。此外,数据增强策略(如扭曲、噪声模拟)被迁移到更广泛的16-19世纪手写体识别任务中,催生了Kurrent字体专用的预训练模型。这些工作共同推动了历史文档自动转录从实验走向规模化部署。
数据集最近研究
最新研究方向
在历史文档分析与手写文本识别(HTR)领域,针对近代早期德语地区如汉萨同盟时期的复杂手写体(Kurrentschrift)的数字化与自动转录是当前备受瞩目的前沿方向。该数据集聚焦于16世纪汉萨文书(如吕贝克档案)的行级图像与转录文本,并通过数据增强策略扩充样本规模,为训练诸如TrOCR等端到端图像到文本模型提供了高质量的结构化资源。其精细的布局标注(包括基线、坐标与阅读顺序)不仅支撑了多模态文档解析与版面还原的研究,更与数字人文领域中对历史文献进行大规模机器阅读的热点事件紧密呼应,推动了对中世纪晚期商业与外交文本的计量化分析,具有显著的遗产保存与知识挖掘意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

