
wargame-reddragon-unit-audio
收藏官方服务:
资源简介:
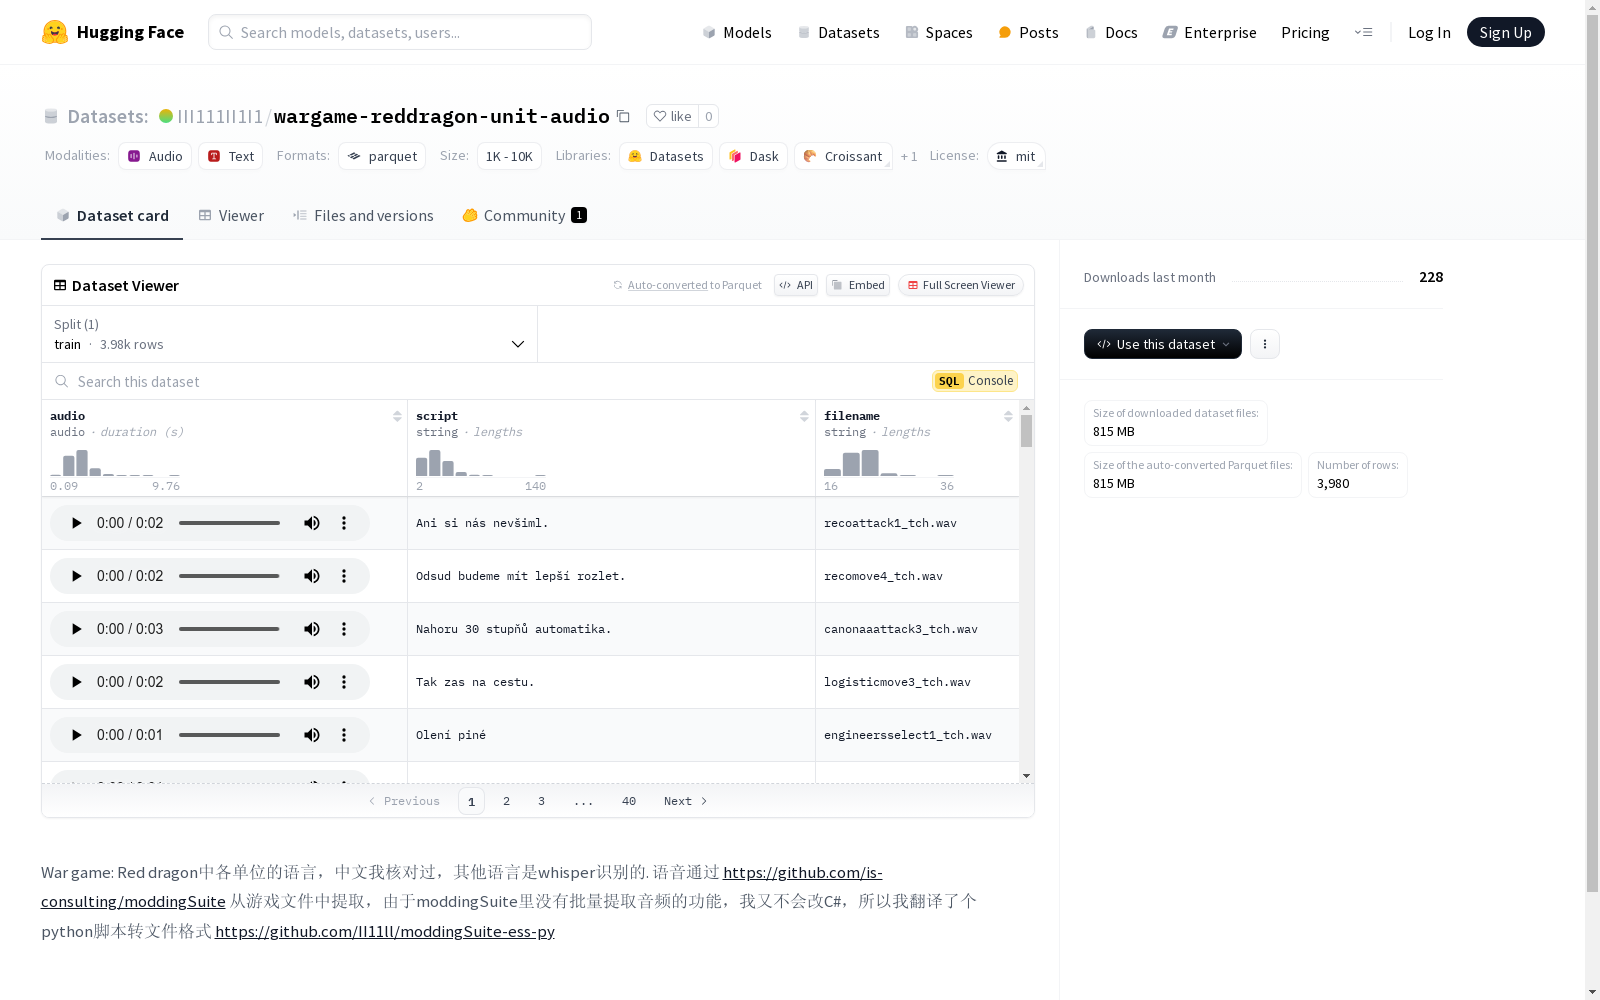
该数据集包含从游戏'War game: Red dragon'中提取的单位语音,包括中文和其他语言的识别文本。音频文件通过特定的工具从游戏文件中提取,并附有对应的脚本和文件名。数据集仅包含一个训练集,共3980个样本。
This dataset comprises unit voice lines extracted from the game 'War Game: Red Dragon', including transcribed texts in Chinese and other languages. The audio files are extracted from the game's internal files using specialized tools, with their corresponding transcript scripts and filenames attached. This dataset only includes a single training set with a total of 3980 samples.
创建时间:
2024-11-27
原始信息汇总
数据集概述
数据集信息
- 名称: wargame-reddragon-unit-audio
- 许可证: MIT
数据集结构
特征
- audio: 音频数据
- script: 文本脚本
- filename: 文件名
分割
- train: 训练集
- num_bytes: 820110560.12 字节
- num_examples: 3980 个样本
数据集大小
- download_size: 814740945 字节
- dataset_size: 820110560.12 字节
配置
- config_name: default
- data_files:
- split: train
- path: data/train-*
- data_files:
数据来源
- 语音数据从游戏文件中提取,使用工具 https://github.com/is-consulting/moddingSuite。
- 由于工具中没有批量提取音频的功能,使用Python脚本转换文件格式,脚本地址为 https://github.com/II11ll/moddingSuite-ess-py。
搜集汇总
数据集介绍
构建方式
该数据集的构建基于对战争游戏《Red Dragon》中各单位语音的提取与处理。通过使用开源工具moddingSuite,从游戏文件中提取音频资源,并借助Python脚本将音频文件转换为可分析的格式。这一过程确保了音频数据的完整性和可用性,同时保留了游戏中原有的语音内容。
使用方法
该数据集适用于语音识别、自然语言处理以及游戏数据分析等多个领域。用户可以通过加载数据集中的音频文件和对应的文本脚本,进行模型训练或验证。数据集提供了训练集,用户可根据需求进行进一步的划分和处理,以适应不同的研究或应用场景。
背景与挑战
背景概述
在现代战争模拟游戏的背景下,'wargame-reddragon-unit-audio'数据集应运而生,旨在捕捉和分析《War Game: Red Dragon》中各单位的语音数据。该数据集由匿名研究者或团队创建,时间不详,但其核心研究问题聚焦于从游戏中提取并分析多语言语音数据,以探索其在语音识别和语言学研究中的应用。通过使用自定义的Python脚本和moddingSuite工具,研究者成功从游戏文件中提取了音频数据,并进行了初步的语言识别和校对。这一数据集的创建不仅丰富了游戏数据的研究领域,也为语音处理技术的实际应用提供了新的实验平台。
当前挑战
该数据集在构建过程中面临多项挑战。首先,从游戏文件中提取音频数据的技术难度较大,尤其是当原始工具(如moddingSuite)缺乏批量处理功能时,研究者不得不自行开发Python脚本以实现文件格式的转换。其次,多语言语音的识别和校对也是一个复杂的过程,尤其是对于非母语的语音数据,准确性难以保证。此外,数据集的规模和多样性可能受限于游戏本身的语音内容,这可能影响其在更广泛研究中的应用。最后,数据集的版权和使用许可问题也需要谨慎处理,以确保其合法性和可持续性。
常用场景
经典使用场景
wargame-reddragon-unit-audio数据集在军事模拟与语音识别领域展现了其经典应用。该数据集通过收录War game: Red dragon中各单位的语音数据,结合对应的文本脚本,为研究者提供了一个丰富的多语言语音与文本对齐资源。这一资源特别适用于语音识别模型的训练与评估,尤其是在多语言环境下,如何提升模型对不同语言语音的识别准确率。
解决学术问题
该数据集有效解决了多语言语音识别中的关键学术问题,尤其是在资源匮乏的语言环境下,如何利用有限的数据提升模型的泛化能力。通过提供高质量的语音与文本对齐数据,研究者能够更精确地评估和优化语音识别算法,推动多语言语音识别技术的发展,具有重要的学术价值和实际意义。
实际应用
在实际应用中,wargame-reddragon-unit-audio数据集可广泛应用于军事模拟、语音助手开发及多语言教育工具等领域。例如,在军事模拟训练中,利用该数据集训练的语音识别系统可以更准确地理解指挥官的指令,提升训练效果。此外,该数据集还可用于开发支持多语言的语音助手,增强其在不同语言环境下的实用性和用户体验。
数据集最近研究
最新研究方向
在现代战争模拟游戏领域,音频数据的提取与分析逐渐成为研究热点。wargame-reddragon-unit-audio数据集的推出,为研究者提供了丰富的多语言音频资源,尤其是在游戏单位语音的识别与转录方面。该数据集不仅包含了中文语音的核对结果,还涵盖了通过Whisper技术识别的其他语言语音,极大地丰富了多语言语音处理的研究素材。此外,数据集的构建过程中,通过Python脚本对游戏文件进行格式转换,展示了技术在游戏数据提取中的创新应用,为相关领域的研究提供了新的思路和工具。
以上内容由遇见数据集搜集并总结生成


