
遇见数据集

ArabicSpeech/ArA-DF-2026

收藏
Hugging Face2026-06-16 更新2026-06-14 收录
官方服务:

资源简介:

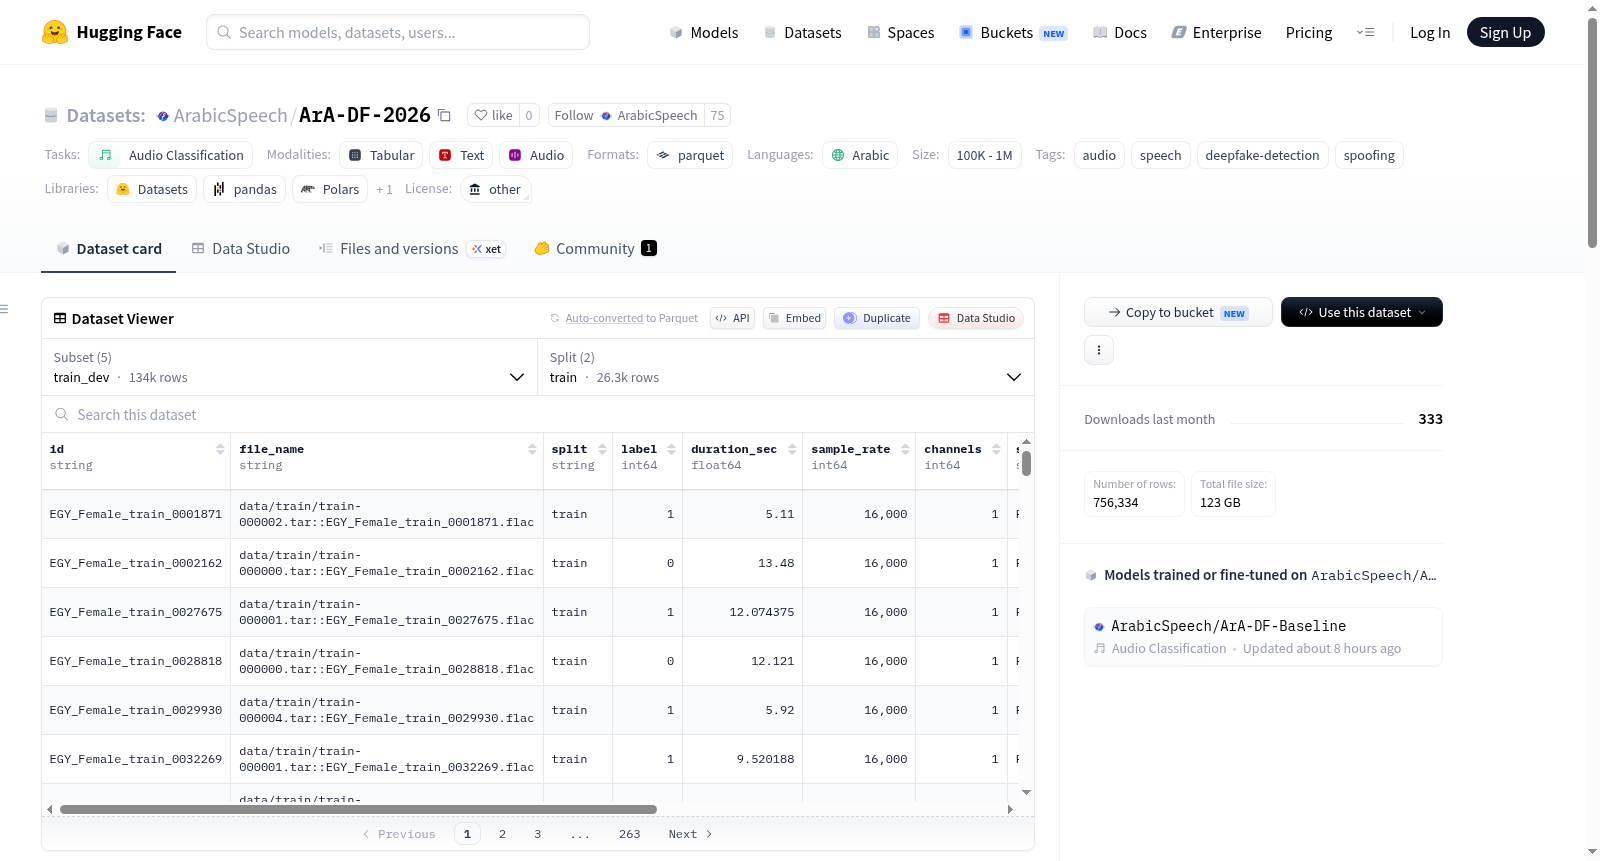
ArA-DF-2026是一个用于二分类音频分类的阿拉伯语语音深度伪造检测数据集:标签0表示真实语音,标签1表示伪造语音。公开的训练和开发分割包含标签,所有公开测试分割无标签且需外部评分。所有发布的音频均为16 kHz单声道PCM音频,以无损FLAC格式打包在WebDataset TAR分片中。数据集包含多个分割:train(26,268行,有标签,文件名包含方言家族和性别标记)、dev(107,428行,有标签,文件名包含方言家族和性别标记)、test_track_1_clean(160,233行,无标签,文件名匿名化)、test_track_1_condition(160,233行,无标签,文件名匿名化)、test_track_1_chain(160,233行,无标签,文件名匿名化)和test_track_2(141,939行,无标签,文件名匿名化)。Track 1提供三种评估变体,用于不同公开评估条件下的方言泛化评估;Track 2评估在独立保留声学条件下的鲁棒性。提交格式为每个测试分割提交一个CSV文件,包含id和label列。加载元数据可使用datasets库的load_dataset函数,加载音频分片需指定WebDataset数据文件路径。

ArA-DF-2026 is an Arabic speech deepfake detection dataset for binary audio classification, where label 0 denotes authentic real speech and label 1 denotes forged speech. The publicly available training and development splits include labels, while all public test splits are unlabeled and require external scoring. All released audio files are 16 kHz mono PCM audio, packaged in WebDataset TAR shards in lossless FLAC format. The dataset comprises multiple splits: train (26,268 samples, labeled, with dialect family and gender markers included in filenames), dev (107,428 samples, labeled, with dialect family and gender markers included in filenames), test_track_1_clean (160,233 samples, unlabeled, filenames anonymized), test_track_1_condition (160,233 samples, unlabeled, filenames anonymized), test_track_1_chain (160,233 samples, unlabeled, filenames anonymized), and test_track_2 (141,939 samples, unlabeled, filenames anonymized). Track 1 offers three evaluation variants for dialect generalization assessment under different public evaluation conditions, while Track 2 evaluates model robustness under independently held-out acoustic conditions. The submission format requires a CSV file for each test split, containing the columns "id" and "label". Metadata can be loaded using the load_dataset function from the datasets library, and to load the audio shards, the file path of the WebDataset data needs to be specified.
提供机构:
ArabicSpeech
搜集汇总
数据集介绍
ArabicSpeech/ArA-DF-2026 数据集图片
构建方式
ArA-DF-2026数据集由阿拉伯语音频样本构成,专注于深度伪造检测的二分类任务,其中标签0代表真实语音,1代表伪造语音。数据集通过将音频以16 kHz单声道PCM格式编码,并封装为无损FLAC文件,存储在WebDataset TAR分片中。训练集与开发集共包含超过13万条带有标签的样本,文件名嵌入方言家族与性别信息;测试集则包含多个变体,如track1下的clean、condition与chain三个子集,以及独立的track2,共计超过60万条未标记样本,并采用匿名化命名策略以隐藏敏感属性。这种设计旨在模拟真实场景下的方言泛化与鲁棒性评估。
特点
该数据集的核心特点在于其精细的分层结构与评估多样性。训练与开发集公开标签,支持有监督学习;测试集则基于Codabench平台外部评分,确保评估的公正性。Track1通过三种公共条件(clean、condition、chain)评估模型在方言泛化任务中的表现,而Track2则关注未知声学环境下的鲁棒性。音频数据经过统一采样与压缩处理,保障一致性。此外,文件名刻意隐藏测试集的语言学信息,防止信息泄露,体现了严谨的实验设计。整个数据集覆盖阿拉伯语丰富的声音特征,为深度伪造检测研究提供了标准化基准。
使用方法
研究者可通过HuggingFace的datasets库便捷加载数据。加载元数据时,使用load_dataset函数并指定配置名称,例如‘test_track_1_clean’;音频分片则需通过webdataset接口以流式方式读取,指定数据路径中的TAR文件模式。提交结果时需为每个测试集生成CSV文件,包含样本ID与二分类预测标签(0或1),并上传至Codabench平台。训练与开发集的分区清晰,便于模型调优;测试集的分数由外部系统自动计算,确保了评估流程的标准化与可复现性。这一流程简化了从数据获取到模型验证的完整链条。
背景与挑战
背景概述
随着深度学习技术的迅猛发展,语音深度伪造技术,尤其是文本到语音和语音转换方法,已能够生成高度逼真的合成语音,对语音身份认证、司法取证和智能交互等应用构成了严峻的安全威胁。针对阿拉伯语这一语系复杂、方言多样的语言,现有的伪造检测数据集大多以英语为主,缺乏覆盖多方言、多场景的阿拉伯语音频资源,限制了检测模型的泛化能力和可信度。在此背景下,ArA-DF-2026数据集应运而生,由阿拉伯语语音研究社区在2026年发布,旨在系统性地解决阿拉伯语语音深度伪造检测问题。该数据集提供了超过60万条标注的音频样本,涵盖多种阿拉伯语方言、性别及说话条件,并设计了多个测试轨以评估模型在干净、带条件及级联伪造场景下的泛化性能,为阿拉伯语语音安全领域的研究提供了权威评估基准。
当前挑战
ArA-DF-2026数据集所应对的核心领域挑战在于阿拉伯语音频深度伪造的高保真度与低检测率,尤其是跨方言、跨条件的泛化检测难题,其Track 1和Track 2分别针对方言泛化与鲁棒性评估设计了不同的测试条件,要求模型不仅能在纯净语音中识别伪造,还需在压缩、噪声及级联伪造等复杂环境中保持性能。在数据集构建过程中,同样面临多重挑战:首先,需要大规模采集并标注真实(bona fide)与伪造(spoofed)的阿拉伯语音频,确保方言、性别与声学条件的均衡分布;其次,测试集需匿名化处理以避免标签泄露,同时保留足够的挑战性以区分模型的表现;再者,音频数据以16kHz单声道FLAC格式打包为WebDataset分片,需兼顾存储效率与流式加载的便捷性,这些技术细节对数据集的最终质量与可用性提出了严格的要求。
常用场景
经典使用场景
在语音安全与反欺诈领域,ArA-DF-2026作为首个大规模阿拉伯语语音深度伪造检测基准数据集,为研究者提供了弥合阿拉伯方言多样性与伪造语音识别之间鸿沟的关键资源。其经典使用场景聚焦于二分类任务,即区分真实语音(bona fide)与由文本转语音(TTS)、语音转换(VC)等技术生成的伪造音频。数据集通过精心设计的训练/开发集(包含26,268条训练样本和107,428条开发样本)以及多个测试轨道,使研究者能够在包含方言族、性别等元信息的监督下训练模型,并在匿名化且条件受限的测试环境中评估跨方言泛化能力与鲁棒性,从而推动阿拉伯语场景下反欺骗技术的系统化发展。
衍生相关工作
ArA-DF-2026的发布催生了一系列辐射性研究工作,主要集中在三个方向:一是基于该数据集开发专用神经网络架构,如融合方言嵌入的轻量级CNN-Transformer混合模型,以及对噪声鲁棒的变体自编码器;二是跨语种迁移学习探索,研究者利用预训练的阿拉伯语音特征(如XLS-R)在Track 1链式测试中验证了多模态信息对检测增益的边际效应;三是公平性与隐私保护研究,通过分析方言族元信息的隐式泄露路径,衍生出针对匿名化测试集的反事实推断方法,以消除人口统计偏差对评估结果的影响。此外,该数据集还作为评测核心出现在ICASSP 2026的阿拉伯语欺骗检测挑战赛中,持续推动生成式语音鉴别与归因领域的前沿突破。
数据集最近研究
最新研究方向
面向阿拉伯语语音深度伪造检测的前沿研究正聚焦于构建高鲁棒性的多方言泛化评估框架。ArA-DF-2026数据集以其大规模、多轨道设计(涵盖清洁、条件及链式欺骗等多样化测试场景)成为该领域的关键基准,尤其针对Track 1的方言泛化能力与Track 2的声学条件鲁棒性进行系统性评测。该数据集的发布与当前全球对语音伪造技术滥用的担忧紧密相关——随着生成式语音合成技术的跃进,阿拉伯语区的政治、金融安全面临新威胁。通过提供匿名的测试环境,该数据集推动开发不依赖人口统计学偏见的检测模型,为跨方言、跨信道的深伪防御技术树立了里程碑式标杆,其公开评测机制(Codabench平台)更促进了国际学术竞赛与标准化比较。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

