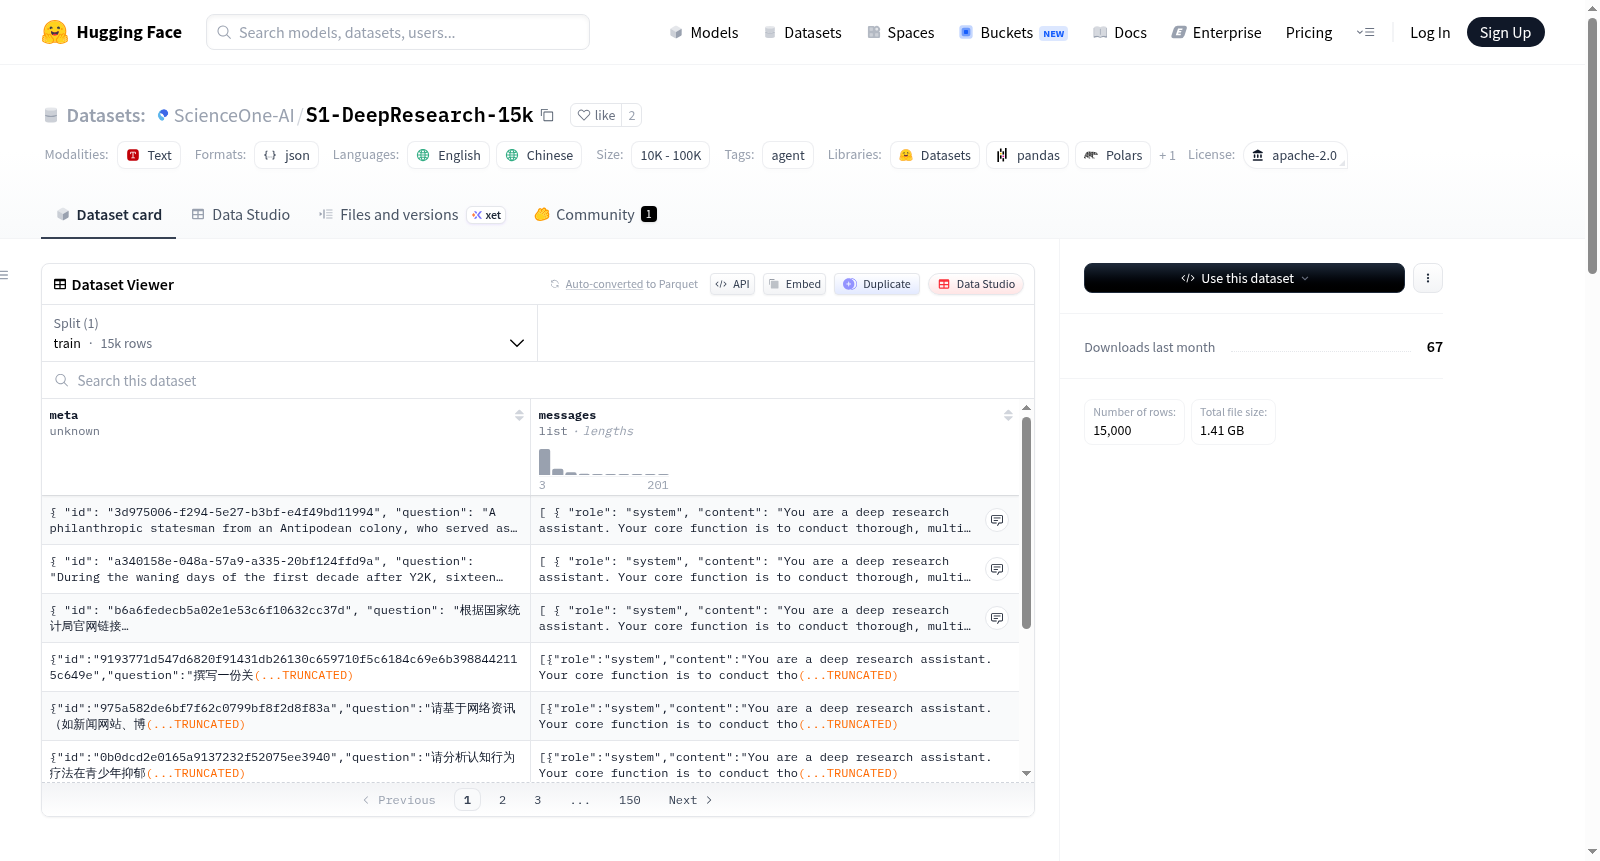
S1-DeepResearch-15k
收藏资源简介:
S1-DeepResearch-15k 数据集是一个精心策划的集合,包含约15,000个样本,旨在提升大型语言模型的深度研究能力。数据集涵盖两种任务类型:可验证任务(标记为“封闭式多跳解析”)和开放式任务(标记为“开放式探索”)。数据集分为五个核心能力维度:长链复杂推理、深度研究指令遵循、深度研究报告撰写、文件理解与生成以及技能使用。每个样本包含元数据(如唯一标识符、问题、答案、语言和任务类型)和消息(角色和内容)。数据集支持英文和中文,适用于需要多步推理、指令遵循、报告生成、文件处理和工具使用等场景的研究和应用。
S1-DeepResearch-15k Dataset is a meticulously curated collection encompassing approximately 15,000 samples, developed to enhance the deep research capabilities of large language models. The dataset covers two task types: verifiable tasks (labeled "closed-form multi-hop parsing") and open-ended tasks (labeled "open-ended exploration"). It is structured around five core competency dimensions: long-chain complex reasoning, adherence to deep research instructions, deep research report writing, document understanding and generation, and skill utilization. Each sample includes metadata such as unique identifier, question, answer, language and task type, as well as messages containing role and content information. The dataset supports both English and Chinese, and is suitable for research and application scenarios requiring multi-step reasoning, instruction following, report generation, document processing and tool use.
S1-DeepResearch-15k 数据集概述
数据集基本信息
- 许可证: apache-2.0
- 语言: 英语 (en)、中文 (zh)
- 标签: agent
- 规模: 10K<n<100K
- 样本数量: 约 15k 个样本
数据集简介
S1-DeepResearch-15k 数据集是一个精选的数据集合,旨在提升大型语言模型的深度研究能力。该数据集包含两种任务类型:
- 可验证任务(标记为“Closed-ended Multi-hop Resolution”)
- 开放式任务(标记为“Open-ended Exploration”)
数据集构成
数据集围绕五个核心能力维度进行组织:
1. 长链复杂推理
此类别包含需要多步骤、多跳推理的通用推理任务。每个样本通常涉及将复杂问题分解为中间步骤、维护中间状态并产生逻辑一致的最终答案。数据强调长推理链的鲁棒性以及在组合约束下的正确性。
2. 深度研究指令遵循
此类别侧重于具有多个显式约束的指令遵循任务,例如对信息来源、输出结构、数量和格式的要求。每个样本旨在评估模型是否能在整个研究工作流程中(从任务理解到最终输出生成)正确解释并满足所有约束。
3. 深度研究报告撰写
此类别包括需要将信息综合成结构化报告的长文本生成任务。样本通常涉及组织多来源内容、呈现连贯的论点,并以预定义格式(例如章节、段落或 Markdown 结构)产生输出,强调清晰性、完整性和一致性。
4. 文件理解与生成
此类别包含涉及以文档为中心的输入(如 PDF、表格和网页)的任务。样本要求模型提取、转换内容并将其重组为结构化输出。数据反映了需要理解异构文档格式并生成可用工件的场景。
5. 技能使用
此类别涵盖需要调用外部工具或模块化能力(例如检索、数据处理、代码执行或可视化)的任务。每个样本评估模型选择适当工具、构建输入以及将工具输出作为连贯工作流程的一部分整合到最终响应中的能力。
数据模式
每个样本的结构如下:
- meta:
- id: 唯一标识符(根据问题生成的哈希值)
- question: 输入查询
- answer: 参考答案(可验证任务必需,生成任务可选)
- language: 样本语言(en 或 zh)
- type: 任务类型标签,取值为:
- Closed-ended Multi-hop Resolution(可验证任务)
- Open-ended Exploration(开放式任务)
- messages:
- role: 角色,取值为 system / assistant / tool / user 之一
- content: 消息内容
相关资源
更多详细信息,请参阅模型仓库:https://github.com/ScienceOne-AI/S1-DeepResearch