
遇见数据集

t22000t/house-prices-tabular

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

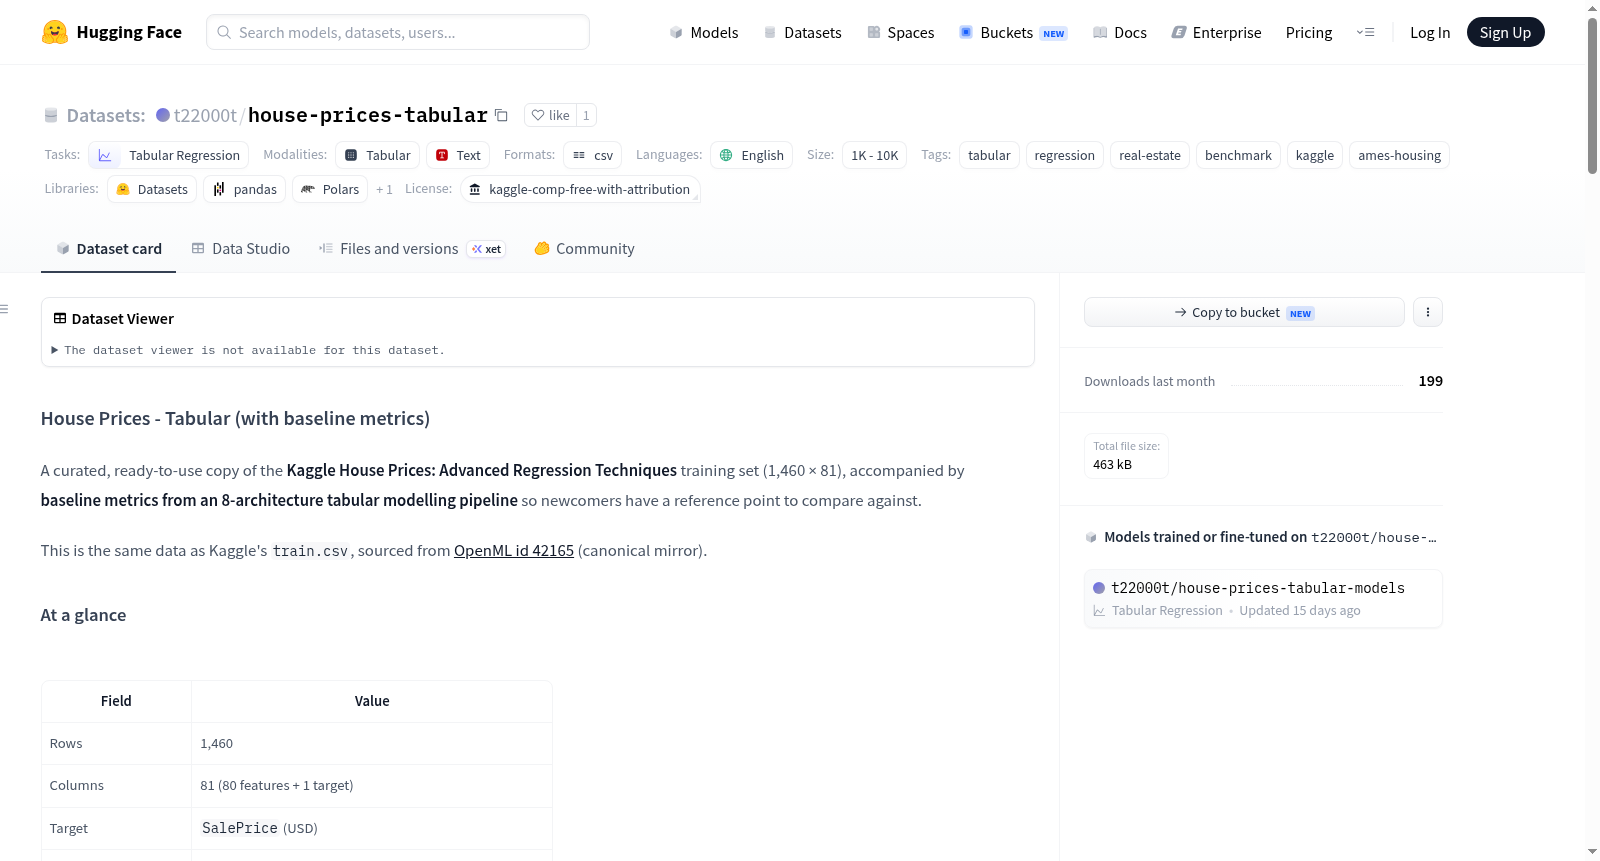
这是一个经过整理的、可直接使用的Kaggle竞赛House Prices: Advanced Regression Techniques训练集副本(1,460行×81列),附带来自8种架构的表格建模流程的基线指标,以便新用户有参考点进行比较。数据与Kaggle的train.csv相同,源自OpenML id 42165(规范镜像)。数据集包含80个特征和1个目标变量(SalePrice,以美元计),目标变量范围为34,900美元至755,000美元(右偏,呈伽马分布),平均值为180,921美元,中位数为163,000美元。特征包括38个连续特征(35个整数和3个浮点数)和43个分类特征(对象类型),缺失值主要集中在可选特征(如PoolQC、MiscFeature、Alley等)。数据集仅包含训练数据,适用于表格回归任务,涉及房地产领域,无个人敏感信息。

This is a curated, ready-to-use copy of the training set for the Kaggle competition House Prices: Advanced Regression Techniques, with 1,460 rows × 81 columns, accompanied by baseline metrics from tabular modeling workflows across 8 distinct architectures to provide new users with a reliable reference for model performance comparison. The data is identical to Kaggle's train.csv, sourced from the canonical mirror of OpenML ID 42165. The dataset contains 80 features and 1 target variable: SalePrice, denominated in USD, which ranges from $34,900 to $755,000, is right-skewed and follows a gamma distribution, with a mean of $180,921 and a median of $163,000. The features include 38 continuous features (35 integer-type and 3 floating-point-type) and 43 categorical features (object-type), with missing values predominantly concentrated in optional features such as PoolQC, MiscFeature, Alley, and others. This dataset only contains training data, is suitable for tabular regression tasks in the real estate domain, and contains no personal sensitive information.
提供机构:
t22000t
搜集汇总
数据集介绍
t22000t/house-prices-tabular 数据集图片
构建方式
House Prices - Tabular 数据集源自 Kaggle 竞赛“House Prices: Advanced Regression Techniques”的训练集,通过 OpenML 的规范镜像(ID 42165)进行二次分发与整理。该数据集保留了原始 CSV 文件的完整结构,包含 1,460 行、81 个字段(80 个特征与 1 个目标变量 SalePrice),同时附带了由八种架构的表格建模流程产出的基准性能指标,为入门者提供可直接参照的比对标准。数据集以单表形式存储,兼容 Hugging Face Datasets 与 Pandas 直接加载,便于快速集成到各类回归建模流程中。
特点
该数据集的核心特色在于其兼具经典性与实用性。目标变量 SalePrice 呈严格正偏态分布(均值 180,921 美元、中位数 163,000 美元),适合采用伽马族分布与对数链接函数进行建模。数据集中连续型特征 38 个(35 个整型、3 个浮点型),类别型特征 43 个,且大量可选字段(如 PoolQC、MiscFeature、Alley)存在缺失值,真实反映了房地产交易数据的典型稀疏性与异构性。此外,数据集附带了在 80/20 划分下、经 30 次 Optuna 超参数优化迭代得到的多架构基线指标,便于模型比较与复现。
使用方法
用户可通过 Hugging Face Datasets 库的 load_dataset 函数直接加载数据,或使用 Pandas 读取远程 CSV 文件以开展自行划分与建模。数据集仅提供带标签的训练集,不包含无标签的测试集,因此用户需要自主执行数据分割(如 80/20 随机划分)用于模型评估。对于希望快速上手的用户,推荐配合配套的表格数据建模流程(GitHub 仓库)使用,其中的配置文件已针对该数据集预设好伽马族对数链接的回归设定;训练后的模型可上传至关联模型仓库,便于后续部署与集成。
背景与挑战
背景概述
房地产价格预测是统计学与机器学习领域历久弥新的研究课题,其核心在于从复杂多维的特征空间中精准建模连续型目标变量。由Dean De Cock于2011年基于美国爱荷华州埃姆斯市2006至2010年间房产交易数据构建的Ames房价数据集,凭借其81个涵盖地块、建筑、区位等维度的丰富特征,被广泛视为波士顿房价数据集的现代替代方案,并经由Kaggle竞赛(House Prices: Advanced Regression Techniques)成为回归任务与特征工程的标准基准。该数据集由研究者Timothy Mun整理并托管于HuggingFace平台,提供包含1,460条记录、80个特征(38个连续型与43个类别型)及右偏目标变量SalePrice的规范化版本,同时附带基于八种架构的基线指标,为初学者与从业者提供了可直接对比的参考标杆,在房价预测与表格数据建模领域产生了深远影响。
当前挑战
该数据集的核心挑战在于对右偏且严格正值的房价目标进行精确建模,要求采用诸如Gamma族结合对数链接函数等非高斯分布假设,以避免传统线性回归带来的预测偏差。特征层面,数据集包含大量类别变量与部分高度缺失的选项型特征(如PoolQC、MiscFeature等),其处理手法直接关系模型性能;同时特征间蕴含复杂的非线性交互关系(如房龄与整体质量),对特征工程与模型选择提出了严苛要求。构建过程中,原始Kaggle竞赛仅提供无标签的测试集,导致需自行划分训练与验证集以确保评估可靠性。此外,在高维稀疏类别特征环境下,过拟合风险显著增加,需借助正则化或集成策略进行有效调控。
常用场景
经典使用场景
house-prices-tabular数据集是房地产领域内最为经典的回归分析基准之一,源自 Ames 房价数据的结构化表格版本,涵盖 79 个解释变量与一个连续目标变量 SalePrice。该数据集广泛应用于表格数据建模的入门与教学场景,尤其适用于展示特征工程、缺失值处理、类别变量编码以及非线性回归模型在真实世界房价预测中的表现。研究者常将其用作基线评估的标准化测试床,通过比较不同回归架构(如线性模型、树集成方法及神经网络)在 gamma 分布假设下的预测误差,以验证算法在结构化数据上的泛化能力。
衍生相关工作
该数据集衍生了一系列具有影响力的学术与工程工作,包括针对表格数据建模的通用流水线(tabular-data-modelling-pipeline)以及预训练模型集合,覆盖八种主流架构(如 XGBoost、LightGBM、MLP 等)及堆叠集成方法。这些工作为研究者提供了可直接复用的基准配置与训练脚本,大幅降低了重复造轮子的成本。此外,基于该数据集的隐私保护研究(如 Privacy Lab Space)探索了在匿名化表格数据上进行对抗攻击与防御的边界,推动了结构化数据在敏感场景下的安全应用发展。
数据集最近研究
最新研究方向
基于Ames房价数据集(House Prices - Tabular)的回归建模基准研究与多架构表格学习管道评估。该数据集源自Kaggle经典竞赛,聚焦于住宅价格预测的先进回归技术。当前前沿方向集中在利用伽马分布结合对数链接函数处理右偏目标变量,并通过包含30次Optuna超参数优化的八种架构管道(如树模型、神经网络等)建立标准化基线,为后续模型选择与集成提供参照。此外,该数据集与可解释性分析、隐私保护(如脱敏处理)及自动化机器学习等热点事件紧密关联,推动了房地产领域从特征工程到端到端建模管道的系统化研究,其意义在于为学术界与工业界提供可复现的高质量基准,促进表格数据预测方法的透明比较与创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

