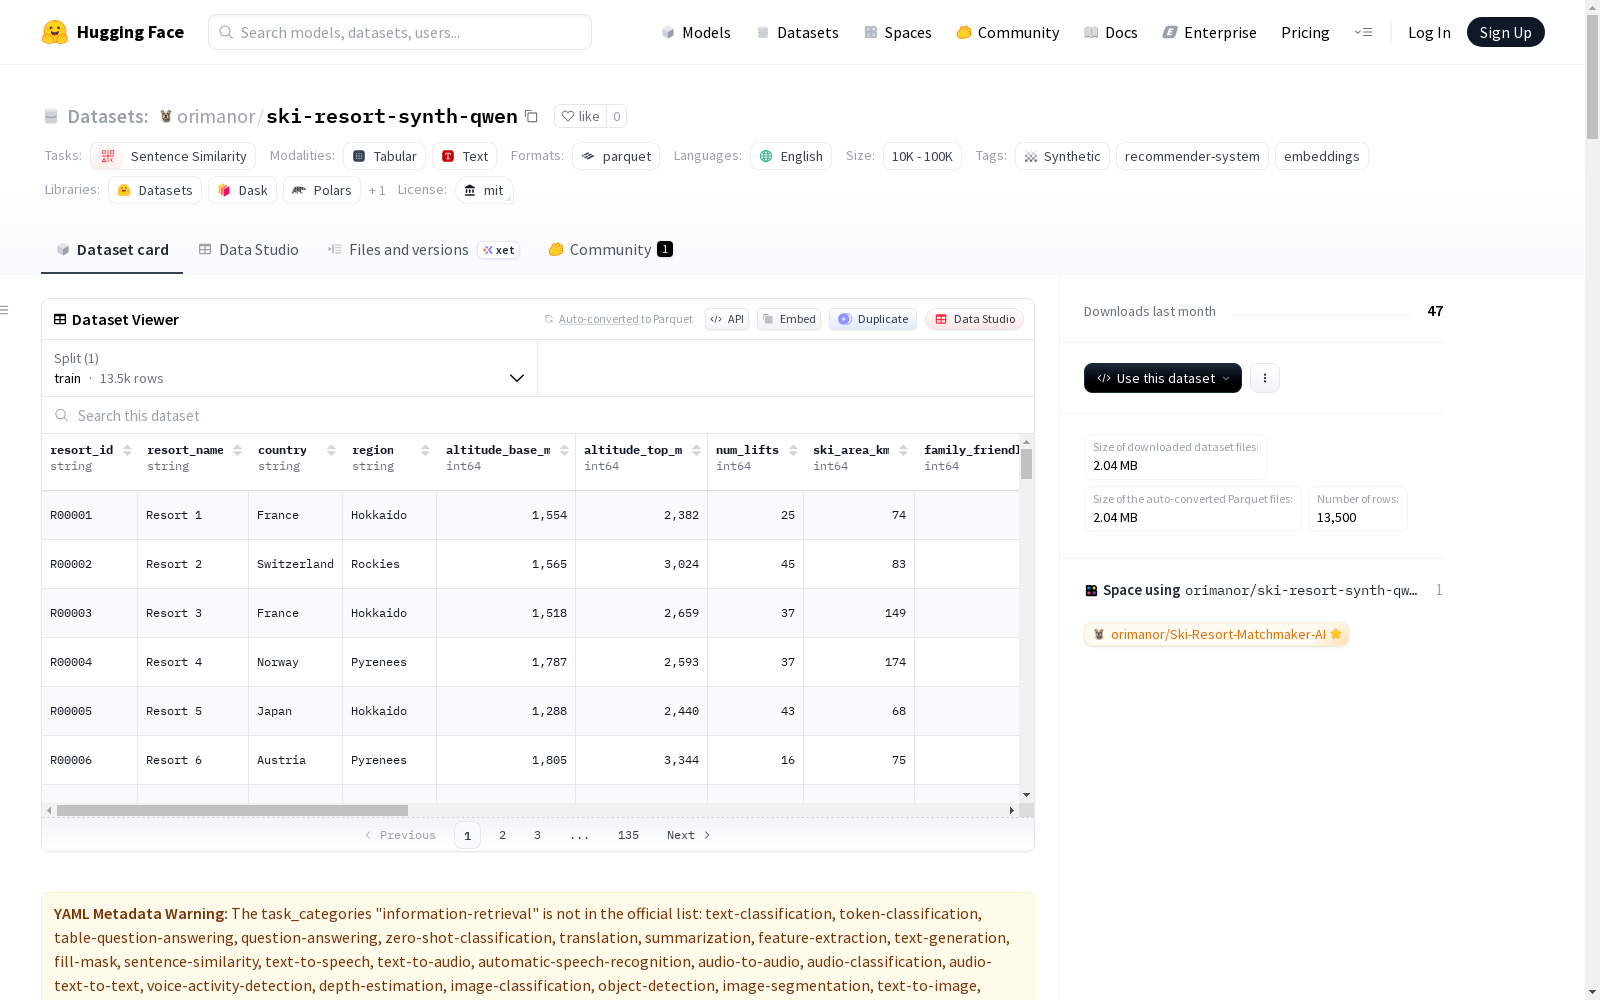
ski-resort-synth-qwen
收藏资源简介:
这是一个合成的滑雪胜地数据集,使用Qwen2.5-1.5B-Instruct模型生成。数据集包含3000个滑雪胜地和10500个用户查询。数据集分为两个部分:'resorts'(包含滑雪胜地的元数据和描述)和'users'(包含用户偏好和文本)。数据集提供了详细的文本长度统计、分类分布(如价格水平、技能水平、预算、旅行风格和地区)以及数值摘要(如海拔、滑雪面积、雪可靠性等)。该数据集主要用于信息检索和句子相似性任务。
This is a synthetic ski resort dataset generated using the Qwen2.5-1.5B-Instruct model. It contains 3000 ski resorts and 10500 user queries. The dataset is divided into two parts: 'resorts' (containing metadata and descriptions of ski resorts) and 'users' (containing user preferences and related texts). It provides detailed text length statistics, categorical distributions such as price level, skill level, budget, travel style and region, as well as numerical summaries including elevation, skiable area, snow reliability and more. This dataset is primarily designed for information retrieval and sentence similarity tasks.
数据集概述
基本信息
- 数据集名称: Ski Resort Synthetic Dataset (Qwen2.5-1.5B-Instruct)
- 许可证: mit
- 任务类别: 信息检索、句子相似度
- 语言: 英语
- 标签: 合成、推荐系统、嵌入
数据构成
- 生成方式: 使用 Qwen2.5-1.5B-Instruct 模型生成的合成数据集。
- 滑雪场数量: 3000
- 用户查询数量: 10500
数据划分
resorts: 包含滑雪场元数据和resort_description。users: 包含用户偏好和user_text。
探索性数据分析摘要
文本长度统计
-
滑雪场描述统计:
- 数量: 3000
- 空值: 0
- 最小长度: 316
- 中位数 (p50): 492
- 90分位数 (p90): 550
- 最大长度: 642
- 重复项: 0
-
用户查询统计:
- 数量: 10500
- 空值: 0
- 最小长度: 100
- 中位数 (p50): 302
- 90分位数 (p90): 386
- 最大长度: 489
- 重复项: 0
分类分布
-
滑雪场 - 价格等级:
- 中档: 1019
- 经济型: 1010
- 高端: 971
-
用户 - 技能水平:
- 初学者: 3522
- 高级: 3498
- 中级: 3480
-
用户 - 预算:
- 经济型: 3550
- 高端: 3505
- 中档: 3445
-
用户 - 旅行风格:
- 运动型: 2195
- 安静型: 2178
- 聚会型: 2060
- 家庭型: 2046
- 奢华型: 2021
-
滑雪场 - 地区:
- 北海道: 455
- 阿尔卑斯: 443
- 比利牛斯: 433
- 落基山脉: 425
- 斯堪的纳维亚: 421
- 高加索: 418
- 多洛米蒂: 405
数值摘要(滑雪场)
| 字段 | 数量 | 均值 | 标准差 | 最小值 | 25%分位数 | 中位数 | 75%分位数 | 最大值 |
|---|---|---|---|---|---|---|---|---|
| altitude_base_m | 3000.0 | 1397.509333 | 286.832722 | 900.0 | 1150.00 | 1394.0 | 1645.25 | 1899.0 |
| altitude_top_m | 3000.0 | 2546.175667 | 427.932478 | 1524.0 | 2247.75 | 2533.5 | 2846.25 | 3579.0 |
| num_lifts | 3000.0 | 31.618667 | 14.017563 | 8.0 | 20.00 | 32.0 | 44.00 | 55.0 |
| ski_area_km | 3000.0 | 116.998333 | 60.621316 | 12.0 | 66.00 | 117.0 | 169.00 | 220.0 |
| party_apres_ski | 3000.0 | 5.010333 | 3.150693 | 0.0 | 2.00 | 5.0 | 8.00 | 10.0 |
| snow_reliability | 3000.0 | 6.569667 | 2.273661 | 3.0 | 5.00 | 7.0 | 9.00 | 10.0 |
| crowd_level_peak | 3000.0 | 5.937000 | 2.590354 | 2.0 | 4.00 | 6.0 | 8.00 | 10.0 |
| ski_school_quality | 3000.0 | 6.556333 | 2.308666 | 3.0 | 4.00 | 7.0 | 9.00 | 10.0 |
| off_piste_score | 3000.0 | 5.000000 | 3.125261 | 0.0 | 2.00 | 5.0 | 8.00 | 10.0 |
| scenery_score | 3000.0 | 7.011333 | 1.973787 | 4.0 | 5.00 | 7.0 | 9.00 | 10.0 |
| airport_access_mins | 3000.0 | 124.925000 | 69.430730 | 45.0 | 60.00 | 120.0 | 180.00 | 240.0 |
图表
- https://huggingface.co/datasets/orimanor/ski-resort-synth-qwen/raw/main/eda_plots/resorts_airport_access.png
- https://huggingface.co/datasets/orimanor/ski-resort-synth-qwen/raw/main/eda_plots/resorts_price_level.png
- https://huggingface.co/datasets/orimanor/ski-resort-synth-qwen/raw/main/eda_plots/resorts_ski_area_km.png
- https://huggingface.co/datasets/orimanor/ski-resort-synth-qwen/raw/main/eda_plots/resorts_snow_reliability.png
- https://huggingface.co/datasets/orimanor/ski-resort-synth-qwen/raw/main/eda_plots/users_apres_preference.png
加载方式
python from datasets import load_dataset
repo_id = "orimanor/ski-resort-synth-qwen" resorts = load_dataset(repo_id, data_dir="resorts", split="train") users = load_dataset(repo_id, data_dir="users", split="train")