
遇见数据集

NYT-Connections

收藏
Hugging Face2024-12-16 更新2024-12-17 收录
官方服务:

资源简介:

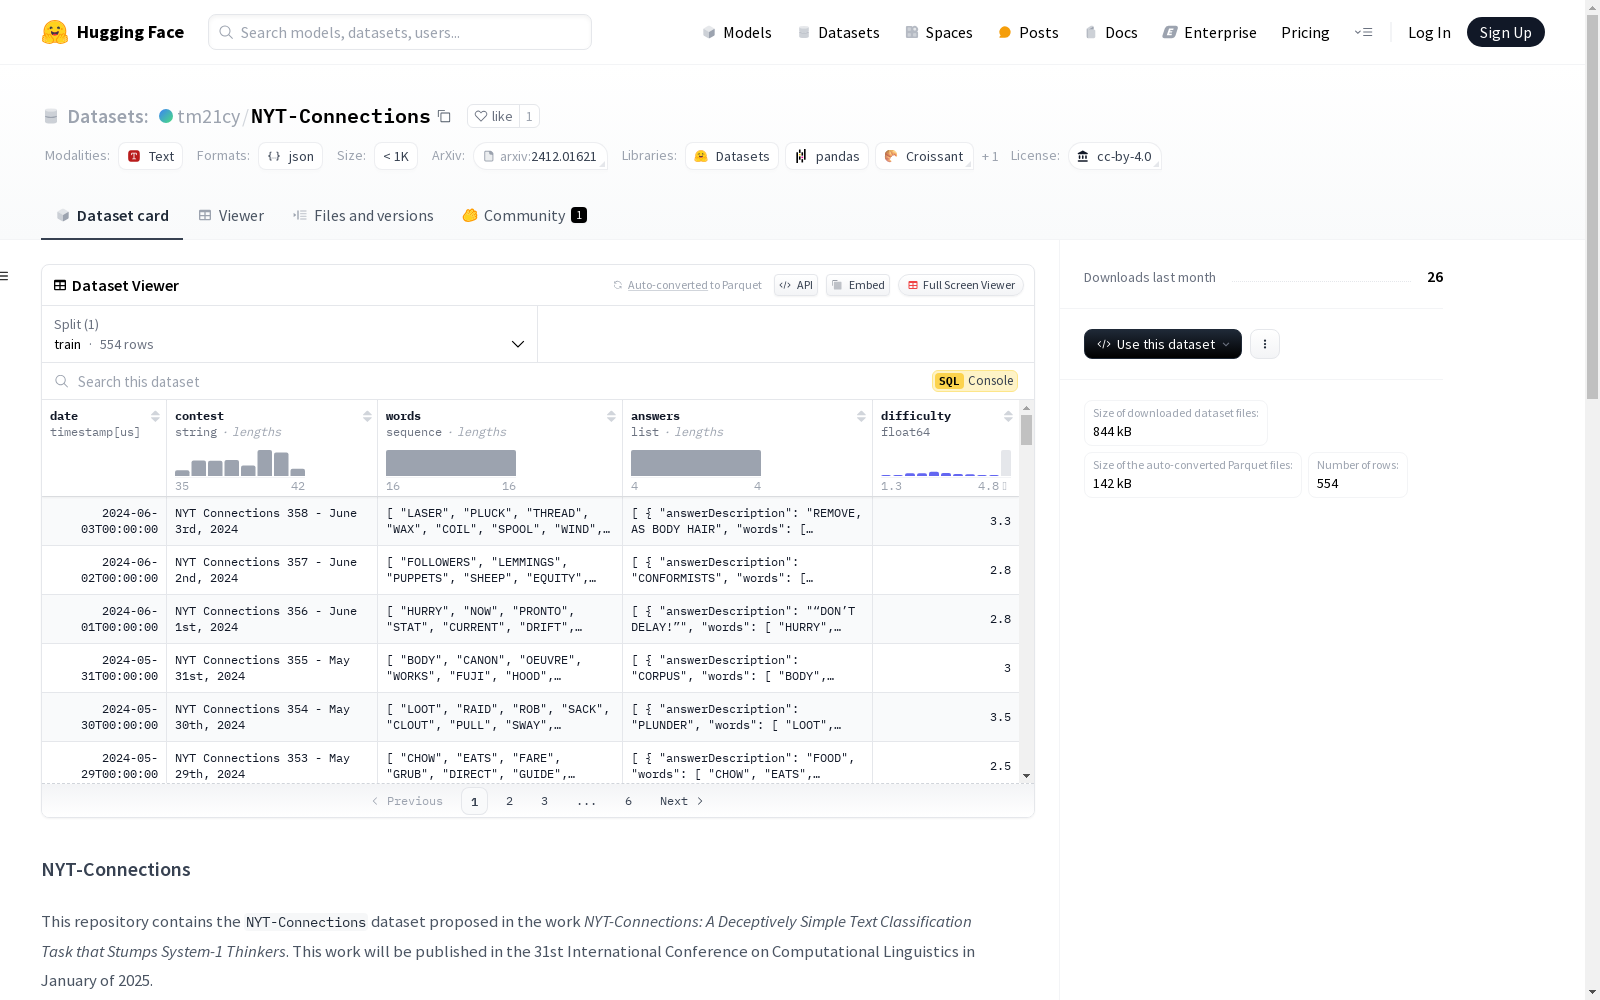
NYT-Connections数据集包含358个从《纽约时报》Connections游戏中提取的简单词汇分类谜题,旨在测试模型和人类的推理能力。每个谜题包含16个单词,目标是将其正确分类为4个不同的组。数据集的每个条目包含日期、比赛标题、16个单词、正确答案组及其描述,以及由社区贡献者评定的难度等级。

The NYT-Connections dataset contains 358 simple lexical categorization puzzles extracted from The New York Times Connections game, which is designed to test the reasoning capabilities of both models and humans. Each puzzle consists of 16 words, with the goal of correctly categorizing them into 4 distinct groups. Each entry in the dataset includes the date, game title, the 16 words, the correct answer groups and their corresponding descriptions, as well as the difficulty rating evaluated by community contributors.

创建时间:
2024-12-02
原始信息汇总

NYT-Connections 数据集

数据集简介

NYT-Connections 数据集是由 Angel Yahir Loredo Lopez、Tyler McDonald 和 Ali Emami 提出的,旨在评估大型语言模型(LLMs)在文本分类任务中的推理能力。该数据集包含 358 个简单的单词分类谜题,源自《纽约时报》的 Connections 游戏。数据集的设计旨在惩罚快速、直观的“系统 1”思维,从而隔离基本的推理技能。

数据集来源

该数据集是《纽约时报》每日 Connections 比赛的一部分,每个谜题包含 16 个单词,目标是将这些单词正确分类为 4 个难度不同的组。

数据字段描述

  • date:比赛提供的原始日期。
  • contest:比赛的标题字符串。
  • words:用于解谜的 16 个单词集合。
  • answers:一个对象数组,每个对象代表一个正确的组,包含以下字段:
    • answerDescription:组的名称。
    • words:属于该组的 4 个单词。
  • difficulty:谜题的难度评级,由社区贡献者提供(若未获得评级,则为 null)。

引用

@misc{lopez2024nytconnectionsdeceptivelysimpletext, title={NYT-Connections: A Deceptively Simple Text Classification Task that Stumps System-1 Thinkers}, author={Angel Yahir Loredo Lopez and Tyler McDonald and Ali Emami}, year={2024}, eprint={2412.01621}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2412.01621}, }
搜集汇总
数据集介绍
NYT-Connections 数据集图片
构建方式
NYT-Connections数据集源自《纽约时报》的Connections游戏,精心挑选了358个简单的词汇分类谜题。每个谜题包含16个单词,旨在将这些单词正确分类为4个难度各异的分组。数据集的构建不仅保留了原始比赛的日期和标题,还详细记录了每个谜题的正确答案,包括每个分组的名称及其对应的四个单词。此外,社区贡献者对谜题难度的评级也被纳入,以提供更全面的挑战评估。
使用方法
使用NYT-Connections数据集时,研究者可以利用其丰富的谜题配置来评估不同模型在推理任务中的表现。通过分析模型在单次尝试、多次尝试无提示和有提示情况下的表现,可以深入了解模型在不同推理难度下的适应性和准确性。此外,数据集的结构化数据格式使得研究者能够轻松提取和分析每个谜题的详细信息,从而进行更深入的模型优化和比较研究。
背景与挑战
背景概述
NYT-Connections数据集由Angel Yahir Loredo Lopez、Tyler McDonald和Ali Emami于2024年提出,旨在评估大型语言模型(LLMs)在复杂推理任务中的表现。该数据集源自《纽约时报》的Connections游戏,包含358个简单的词汇分类谜题,旨在挑战快速、直觉性的‘系统1’思维,强调深层次的推理能力。通过对比人类与LLMs的表现,研究发现即使在最先进的模型如GPT-4中,仍存在显著的性能差距,尤其是在任务难度增加时,高级提示技术如Chain-of-Thought和Self-Consistency的效果逐渐减弱。该数据集的推出为评估LLMs的推理能力提供了新的工具,并推动了自然语言处理领域对复杂推理任务的研究。
当前挑战
NYT-Connections数据集面临的挑战主要集中在两个方面。首先,该数据集旨在解决复杂推理任务中的挑战,要求模型不仅依赖直觉性思维,还需具备深层次的逻辑推理能力。其次,构建过程中遇到的挑战包括如何设计谜题以有效区分不同模型的推理能力,以及如何定期更新数据集以防止数据泄露。此外,评估模型在不同配置下的表现,如单次尝试、多次尝试无提示和多次尝试有提示,也增加了数据集的复杂性。这些挑战共同构成了该数据集在推动LLMs推理能力评估中的核心难题。
常用场景
经典使用场景
NYT-Connections数据集的经典使用场景在于评估大型语言模型(LLMs)的推理能力。该数据集通过提供358个源自《纽约时报》Connections游戏的简单词汇分类谜题,旨在测试模型在面对需要深思熟虑的任务时的表现。这些谜题要求模型将16个单词正确分类为4个不同的组别,每个组别包含4个单词。通过这种方式,数据集能够有效衡量模型在复杂推理任务中的表现,尤其是在面对需要避免直观思维(System 1)的场景下。
解决学术问题
NYT-Connections数据集解决了当前学术界关于大型语言模型推理能力评估的难题。尽管LLMs在多项基准测试中表现出色,但其深层次的推理能力仍存疑。该数据集通过设计抵抗直观思维的谜题,有效隔离了模型的基本推理技能,揭示了现有模型在复杂推理任务中的不足。研究结果表明,即使是最先进的LLMs,如GPT-4,在面对此类任务时也显著落后于人类表现,这一发现对未来LLMs的改进和优化具有重要指导意义。
实际应用
NYT-Connections数据集在实际应用中具有广泛潜力,特别是在教育和培训领域。通过模拟《纽约时报》Connections游戏的谜题,该数据集可用于开发和测试教育软件,帮助学生提升逻辑推理和问题解决能力。此外,该数据集还可用于企业培训,特别是在需要复杂决策和问题解决能力的岗位上,帮助员工提高分析和推理技能。通过这些应用,NYT-Connections不仅为学术研究提供了工具,也为实际问题的解决提供了新的方法。
数据集最近研究
最新研究方向
在自然语言处理领域,NYT-Connections数据集的提出为评估大型语言模型(LLMs)的推理能力提供了新的视角。该数据集源自《纽约时报》的Connections游戏,通过设计358个简单的词汇分类谜题,旨在挑战模型的深层推理能力,而非依赖直觉的‘系统1’思维。研究显示,尽管如GPT-4等顶尖LLMs在多项任务中表现出色,但在NYT-Connections上的表现仍与人类存在显著差距,尤其是在任务难度增加时,先进的提示技术如Chain-of-Thought和Self-Consistency的效果逐渐减弱。这一发现不仅揭示了当前LLMs在复杂推理任务中的局限性,也为未来模型优化提供了重要的研究方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

