jonfd/ICC
收藏资源简介:
冰岛爬取语料库(ICC)包含了从冰岛的各种网站(如新闻网站、政府网站和论坛)爬取的约930M个词元。爬取的文本以原始形式呈现,未经过注释、分词和去重处理。该数据集主要用于训练语言模型,并且可以与其他语料库(如冰岛Gigaword语料库和mC4语料库的冰岛语部分)结合使用。数据集的语言为冰岛语,且为单语数据集。数据集的创建者是Jón Friðrik Daðason,由冰岛教育、科学和文化部资助。数据集采用CC BY 4.0许可证。
The Icelandic Crawled Corpus (ICC) contains approximately 930 million tokens crawled from various Icelandic websites including news sites, government websites, and forums. The crawled texts are presented in their original form without annotation, word segmentation, or deduplication processing. This dataset is primarily intended for training language models, and can be used in combination with other corpora such as the Icelandic Gigaword Corpus and the Icelandic portion of the mC4 corpus. The dataset is in Icelandic and is a monolingual dataset. It was created by Jón Friðrik Daðason and funded by the Ministry of Education, Science and Culture of Iceland. The dataset is licensed under CC BY 4.0.
数据集卡片 for ICC
数据集描述
数据集摘要
冰岛爬虫语料库(ICC)包含约9.3亿个词元,这些词元是从一系列冰岛网站(包括新闻网站、政府网站和论坛)上抓取的。抓取的文本以其原始形式呈现,未经注释、未分词且未去重。
支持的任务和排行榜
ICC主要用于训练语言模型。它可以与其他语料库结合使用,例如冰岛语Gigaword语料库和mC4语料库的冰岛部分。
语言
该语料库包含从各种在线来源抓取的冰岛语文本。
数据集结构
数据实例
[更多信息需要]
数据字段
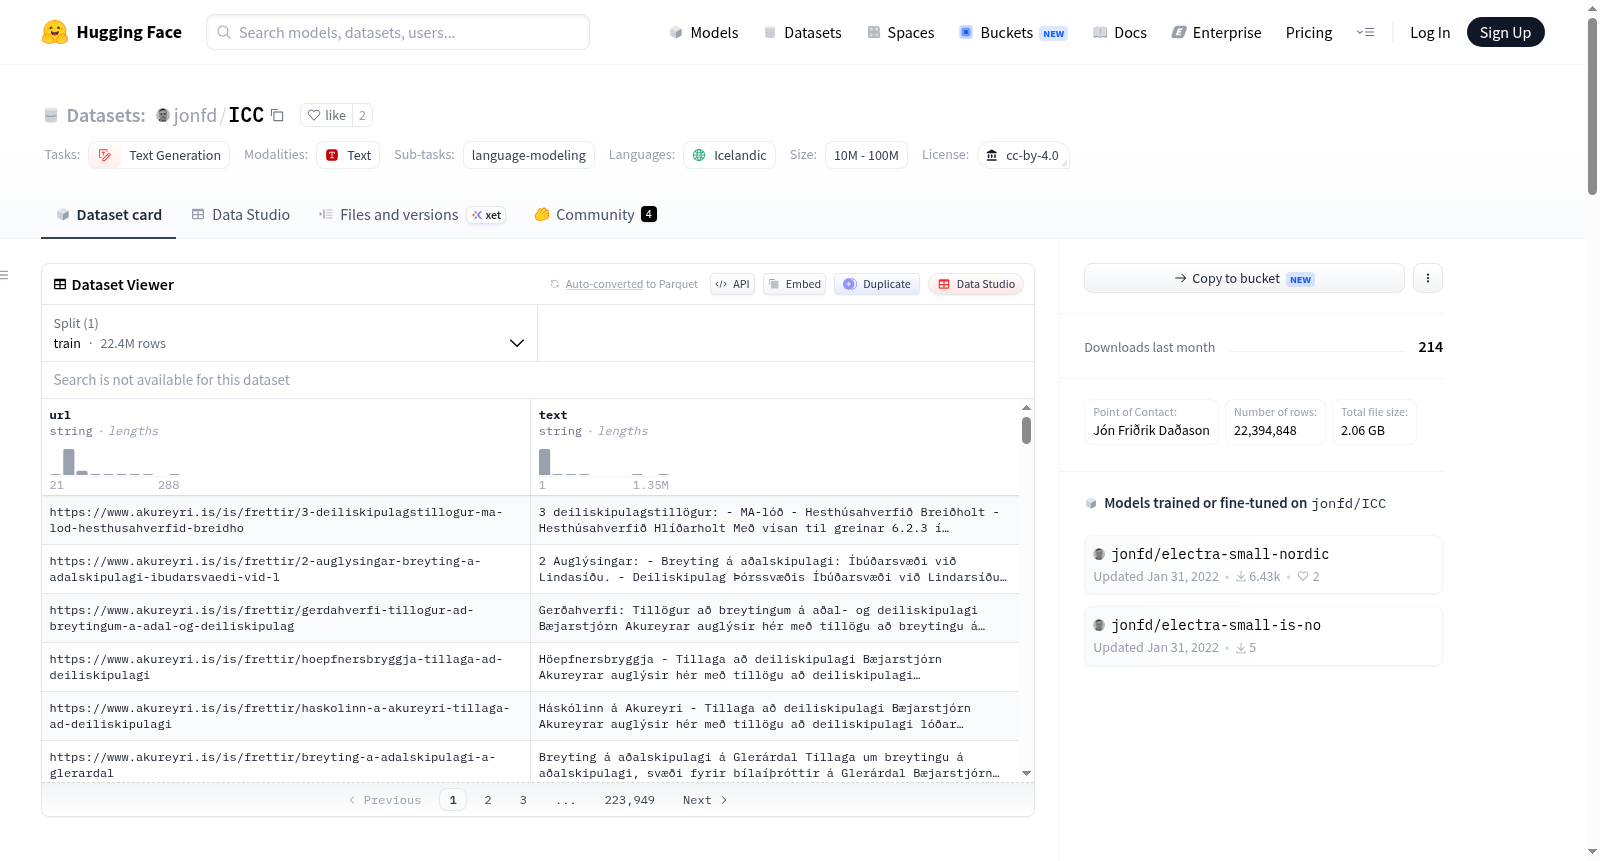
每个抓取的项目包含两个字段:
- url: 抓取文本的源URL。
- text: 抓取的文本。
数据分割
N/A
数据集创建
策划理由
[更多信息需要]
源数据
初始数据收集和规范化
[更多信息需要]
源语言生产者是谁?
[更多信息需要]
注释
注释过程
N/A
注释者是谁?
N/A
个人和敏感信息
尽管该语料库完全由从公开可用网站收集的文本组成,但它可能包含一些个人或敏感信息的示例。
使用数据的注意事项
数据集的社会影响
[更多信息需要]
偏见的讨论
[更多信息需要]
其他已知限制
[更多信息需要]
附加信息
数据集策展人
该语料库由Jón Friðrik Daðason创建,在Reykjavik University的Language and Voice Lab工作期间完成。
该项目由冰岛2019-2023年语言技术计划资助。该计划由Almannarómur管理和协调,由冰岛教育、科学和文化部资助。
许可信息
本作品根据知识共享署名4.0国际许可协议授权。本作品中的任何文本、HTML页面链接、信息、元数据或其他材料可能受您与这些内容所有者之间的单独条款和条件的约束。
如果您是版权所有者或其代理人,并且认为本作品中的任何内容侵犯了您的版权,您可以通过以下信息提交通知:
- 您的全名和合理充分的信息,以便我们联系您,如邮寄地址、电话号码和电子邮件地址。
- 您声称已被侵犯的版权作品的识别信息。
- 您声称侵权并应删除的材料的识别信息,以及合理充分的信息,以便我们找到该材料。
引用信息
N/A
贡献
感谢@jonfd添加此数据集。