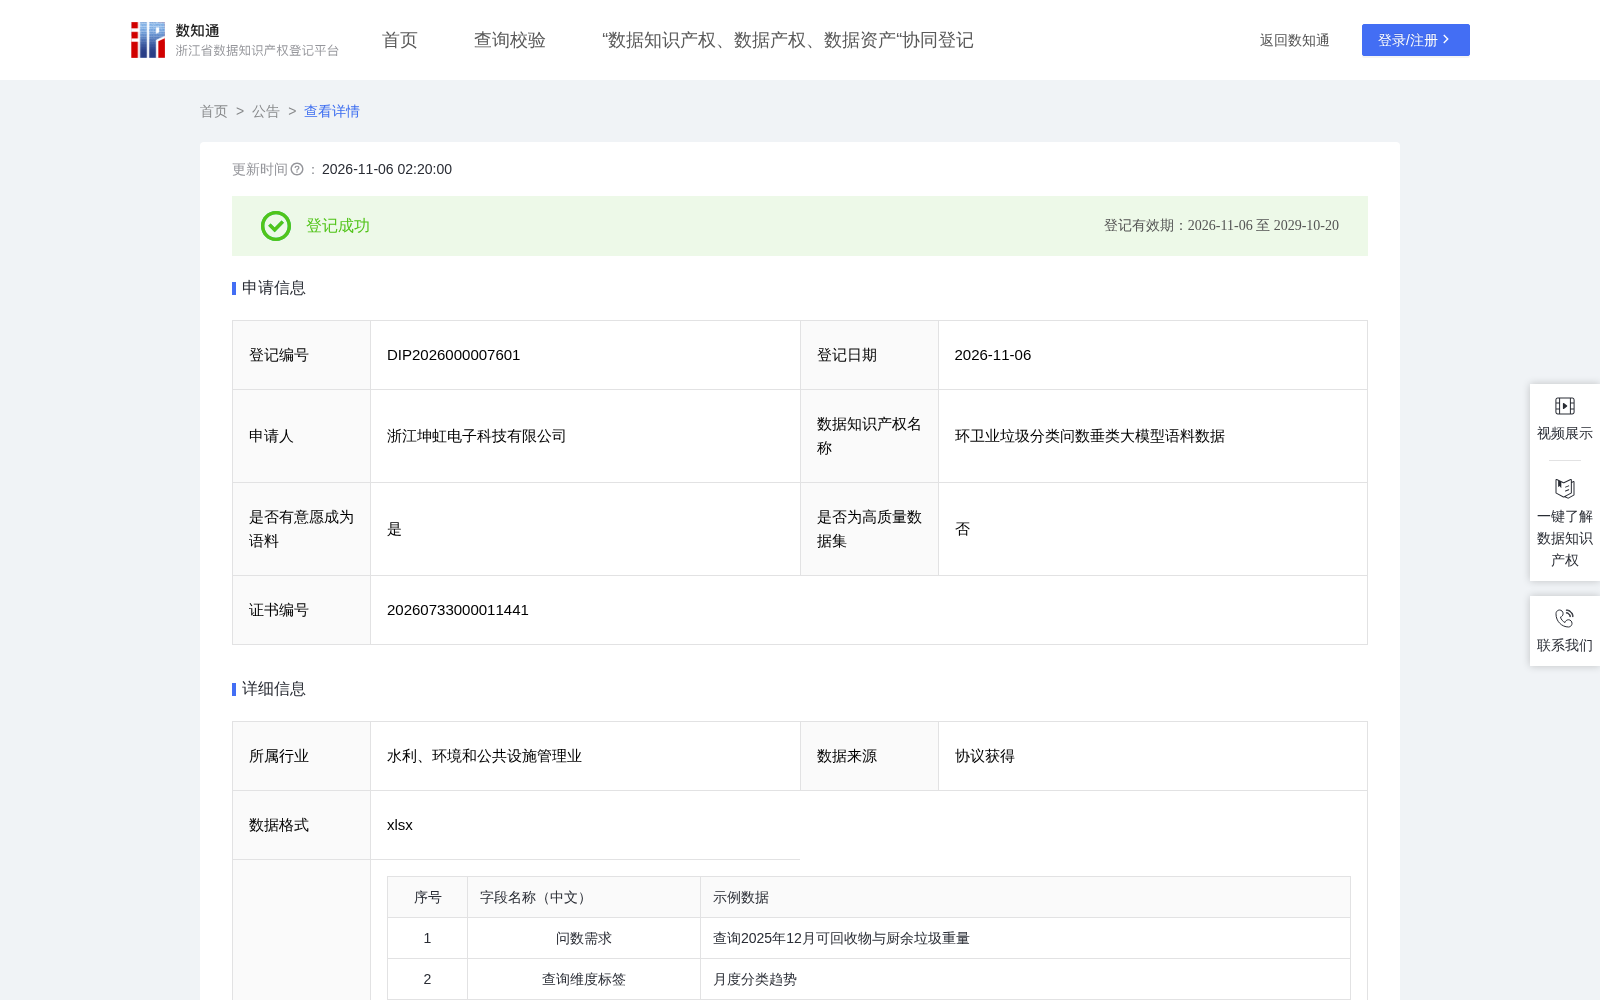
环卫业垃圾分类问数垂类大模型语料数据
收藏资源简介:
本数据集专为训练环卫行业垃圾分类管理领域垂类大语言模型而构建。当前垃圾分类数据查询依赖人工统计效率低下导致分类准确率监控滞后、多维度分类指标(可回收物/有害垃圾/厨余垃圾/其他垃圾)组合分析缺乏标准化数据支撑、分类趋势与减量效果难以量化评估、跨区域分类质量对比缺乏数据依据。本数据集通过垃圾分类数据清洗标准化、问题分类结构化、SQL生成与核验,构建覆盖月度垃圾总量统计、年度垃圾汇总、分类垃圾量统计、分类占比查询、可回收物统计、厨余垃圾统计、分类准确率查询、班组垃圾量统计等24类查询维度的语料集,形成问数需求-SQL语句-结果输出三元组数据。该语料可直接用于训练Text-to-SQL垃圾分类问数模型,推动垃圾分类管理从'人工逐月统计'向'AI智能研判'演进,并可横向复用至城市固废监管、生活垃圾分类考核、资源回收利用评估等场景。1.数据采集与清洗:以母公司垃圾分类业务实际运行数据为基础,围绕"垃圾分类记录表""垃圾分类标准表"两类数据对象,采集四类垃圾(可回收物、有害垃圾、厨余垃圾、其他垃圾)重量、分类准确率、所属区域、清运车辆、责任班组等业务字段对应的问数需求,按业务场景粒度切分,去除冗余与重复需求,通过逻辑校验确保数据一致性,清洗后数据有效率≥98%。 2.维度分类与标注:按业务查询维度进行分类标注,标注查询维度标签、问数需求类型等分类信息,构建覆盖月度分类趋势、分类占比、同比环比、区域统计、准确率排名、清运车次统计等24类核心查询场景的语料基础库,覆盖率≥90%,语料以"问数需求-SQL查询-结果输出"三元组结构组织。 3.核心算法:(1)语料结构化与语义解析:对垃圾分类问数需求进行语义结构化分析,提取查询目标、筛选条件和统计口径等核心要素,识别所涉及的垃圾类别、时间和区域维度,要素解析准确率≥96%;(2)查询逻辑构建与三元组生成:基于查询要素和字段体系构建标准化的查询逻辑链路,生成对应查询语句与结果输出,形成"问数需求-SQL查询-结果输出"三元组语料结构,生成准确率≥94%;(3)结果输出与验证:将查询结果组织为结构化自然语言输出,与问数需求进行一致性核验,确保输出准确反映问数意图;(4)异常检测与质量过滤:对查询要素不完整、口径不一致、逻辑矛盾等异常情况进行识别和过滤,异常过滤率≥99%,同时通过结果核验正确率与人工核对正确率双维度进行质量校验。 4.独立语料价值:本语料聚焦环卫垃圾分类单一业务领域,围绕四分类体系、分类准确率、清运调度等专业查询场景构建。相较开放语料或通用问数语料,垃圾分类业务具有"四分类标准、区域四级管理、清运车辆配置"等独特的字段体系和查询逻辑,通用语料难以覆盖此类专业查询语义。构建本独立问数语料,可让模型在细分场景下充分学习垃圾分类特有的查询句式与统计口径,避免领域查询语义在混合语料中被稀释,提升大模型在垃圾分类问数场景下的查询理解与逻辑推理能力,更好支撑环卫行业垃圾分类精细化管理的实际需求。