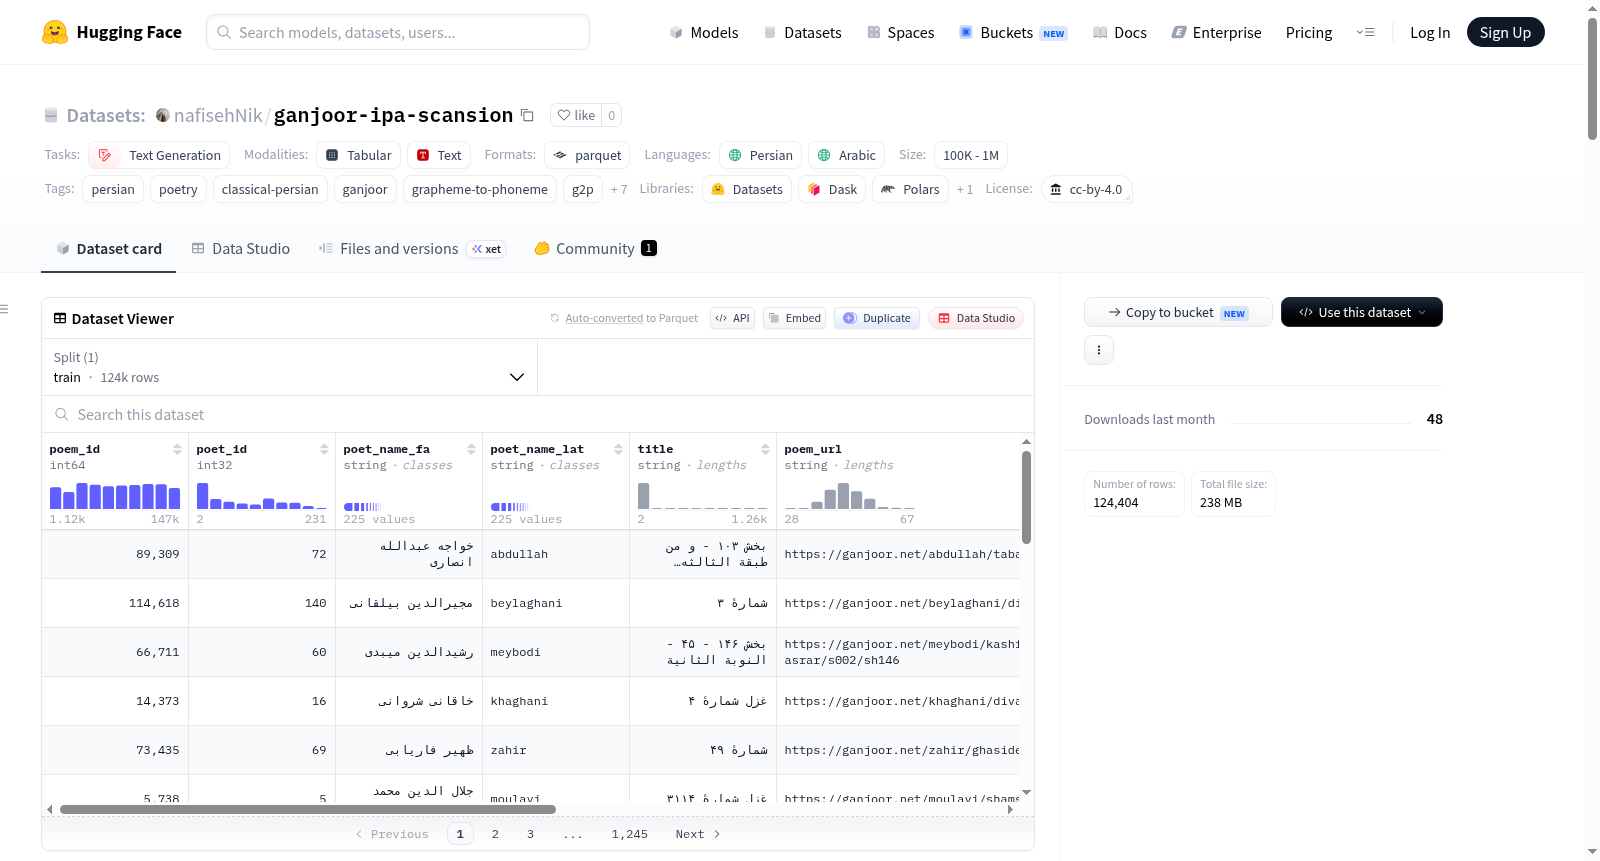
ganjoor-ipa-scansion
收藏资源简介:
该数据集名为“Ganjoor波斯古典诗歌——韵律与音位转写”,包含从Ganjoor API收集的124,404首古典波斯诗歌,并为每首诗增加了两种信息:1) 韵律格律(阿鲁兹/瓦兹恩),包括格律脚和二进制韵律扫描,其中约21%原本未标注的诗歌通过波斯脚重建获得;2) 音位转写,使用Homo-GE2PE模型将每个半句转换为拉丁字母和IPA音标。数据集包含225位诗人,共1,437,436联句(2,874,436个半句),涵盖16种基本格律。每行代表一首诗,存储为原生嵌套列表结构,包含诗ID、诗人ID、诗人名称(波斯语和拉丁语)、标题、Ganjoor URL、联句数、韵律元数据(包括节奏ID、格律字符串、名称、基本格律、波斯脚、拉丁脚扫描、韵律扫描、来源和已知标志)以及诗句列表(每个联句包含索引、波斯语文本、两种转写表示和IPA)。适用任务包括文本生成、波斯诗歌分析、字素到音素转换、韵律分析等。数据集采用CC BY 4.0许可,诗歌本身属于公共领域。
This dataset, titled "Ganjoor Persian Classical Poetry — Meter and Phonetic Transcription", contains 124,404 classical Persian poems collected from the Ganjoor API. Two types of supplementary information are provided for each poem: 1) Prosodic meters (Aruz/Arūḍ / Vazn), including metrical feet and binary prosodic scans; approximately 21% of the originally unannotated poems were reconstructed via Persian prosodic feet. 2) Phonetic transcriptions: the Homo-GE2PE model is used to convert each hemistich into Latin script and IPA phonetic transcription. The dataset covers 225 poets, with a total of 1,437,436 couplets (2,874,436 hemistichs) and encompasses 16 basic meters. Each entry represents a single poem, stored as a native nested list structure containing: poem ID, poet ID, poet names (Persian and Latin), title, Ganjoor URL, number of couplets, prosodic metadata (including meter ID, meter string, name, basic meter, Persian feet, Latin foot scan, prosodic scan, source, and known flag), as well as a list of verses (each couplet contains index, Persian text, two transcription representations, and IPA). Applicable tasks include text generation, Persian poetry analysis, grapheme-to-phoneme conversion, prosodic analysis, and more. The dataset is licensed under CC BY 4.0, while the poems themselves are in the public domain.
数据集概述
名称: Ganjoor Persian Classical Poetry — Meter & Phonemic Transliteration
地址: https://huggingface.co/datasets/nafisehNik/ganjoor-ipa-scansion
许可证: CC BY 4.0
语言: 波斯语(fa)、阿拉伯语(ar)
任务类别: 文本生成
标签: 波斯语、诗歌、古典波斯语、Ganjoor、字素到音素转换、G2P、音素化、IPA、音译、韵律学、诗律、阿鲁兹、瓦兹恩
数据规模: 100K<n<1M
核心内容
该数据集包含 124,404 首古典波斯诗歌,通过 Ganjoor API 收集,并为每首诗补充了以下两类信息:
- 韵律学信息(ʿarūż / vazn):包括每个诗歌的格律脚(metrical feet)和二进制韵律分析(binary scansion),其中约 21% 的诗歌原本未被 Ganjoor 标记韵律,此处根据波斯格律脚进行了重建。
- 音素转写:每半句(hemistich)均有拉丁字母和 IPA 两种音素转写,由 Homo-GE2PE 字素到音素模型生成。
数据集中每一行对应一首诗,诗句以嵌套的 list<struct> 原生类型存储,完整保留结构。
快速统计
| 项目 | 数值 |
|---|---|
| 诗歌数量(行数) | 124,404 |
| 诗人数量 | 225 |
| 诗句数量(beyts) | 1,437,436 |
| 半句数量(mesraʿ) | 2,874,436 |
| 不同基础格律 | 16 |
数据加载方式
支持直接使用 Hugging Face datasets 库加载:
python from datasets import load_dataset
ds = load_dataset("nafisehNik/ganjoor-vazn-phonemes", split="train") ds[0]["meter"]["scansion"] # 例如 u––– u––– u–– ds[0]["verses"][0]["ipa_1"] # 第一半句的音素 IPA
也可通过 PyArrow 直接读取 Parquet 文件(文件按 base_meter_part=<meter> 进行 Hive 分区)。
数据模式(Schema)
顶层字段(每行对应一首诗)
| 列名 | 类型 | 描述 |
|---|---|---|
poem_id |
int64 | Ganjoor 诗歌 ID |
poet_id |
int32 | Ganjoor 诗人 ID |
poet_name_fa |
string | 诗人姓名(波斯语) |
poet_name_lat |
string | 诗人姓名(拉丁字母拼音) |
title |
string | 诗歌标题(波斯语) |
poem_url |
string | Ganjoor 网站上的原始 URL |
verse_count |
int32 | 诗句(beyt)数量 |
meter |
struct | 韵律学元数据,详见下表 |
verses |
list<struct> | 诗节数据,详见下表 |
corpus |
string | 固定值为 "ganjoor" |
translit_model |
string | 固定值为 "homo-ge2pe" |
meter 结构体字段
| 字段名 | 类型 | 描述 |
|---|---|---|
rhythm_id |
int32 | Ganjoor 韵律 ID |
rhythm_fa |
string | 完整的波斯语格律字符串(音步 + 名称) |
rhythm_name_fa |
string | 波斯语格律名称 |
rhythm_name_lat |
string | 拉丁语格律名称(如 hazaj maḥẕūf) |
base_meter |
string | 基础格律家族(如 hazaj、ramal、rubāʿī) |
feet_fa |
list<string> | 波斯语格律脚(arkān),如 ["مفاعیلن","مفاعیلن","فعولن"] |
feet_lat |
list<string> | 每个音步的韵律分析,˘=短音节 ¯=长音节 ˜=可长可短 |
scansion |
string | 扁平化的韵律分析,u=短音节 –=长音节 x=可长可短 |
source |
string | feet_lat 来源:ganjoor 或 derived |
known |
bool | 拉丁格律是否已解析(此处始终为 true) |
verses[] 结构体字段(每个元素对应一个 beyts,每个 beyts 含两个半句 _1 / _2)
| 字段名 | 类型 | 描述 |
|---|---|---|
verse_index |
int32 | 在诗歌中的 0 基位置 |
fa_1, fa_2 |
string | 半句 1 / 半句 2 的原始波斯语文本 |
repr1_1, repr1_2 |
string | Homo-GE2PE 的表示形式 1(罗马化) |
repr2_1, repr2_2 |
string | Homo-GE2PE 的表示形式 2(模型原始输出) |
ipa_1, ipa_2 |
string | 音素 IPA 转写 |
构建方法
- 数据来源:通过 Ganjoor API 获取诗歌及其格律元数据。
- 格律解析:Ganjoor 为约 79% 的诗歌提供了
feet_lat;对于其余约 21% 仅有波斯语格律脚(feet_fa)的诗歌,利用已标注部分的参考数据,逐音步重建拉丁格律分析,并针对行尾的可变音节(anceps)进行位置感知处理。最终所有诗歌均获得拉丁格律分析,meter.source字段标记来源为ganjoor或derived。 - 音素转写:每个半句通过 Homo-GE2PE(在 HomoRich 数据集上微调的 T5 模型,用于同形异义词消歧)生成 "表示形式 2";
repr1和ipa由 "表示形式 2" 确定性映射得到。
转写表示示例
| 波斯语 | repr2 | repr1 | ipa |
|---|---|---|---|
| شهر | $/hr |
Sahr |
ʃæhr |
| دوست | dust |
dust |
duːst |
已知限制
- 阿拉伯语诗句:部分诗歌(例如 tadhkira 类文本)中包含阿拉伯语书写行,这些行同样由同一波斯语 G2P 模型进行音素转写。
许可与致谢
- 许可协议:CC BY 4.0。
- 诗歌版权:内容为公有领域(古典波斯诗人已远超版权保护期限),Ganjoor 不主张版权并公开其数据库。
- 致谢:
- 文本来源:Ganjoor
- 音素转写模型:Homo-GE2PE(MIT 许可证)
引用
若使用此数据集,请引用 Ganjoor 作为文本来源,并引用相关论文(引用信息见原始页面)。