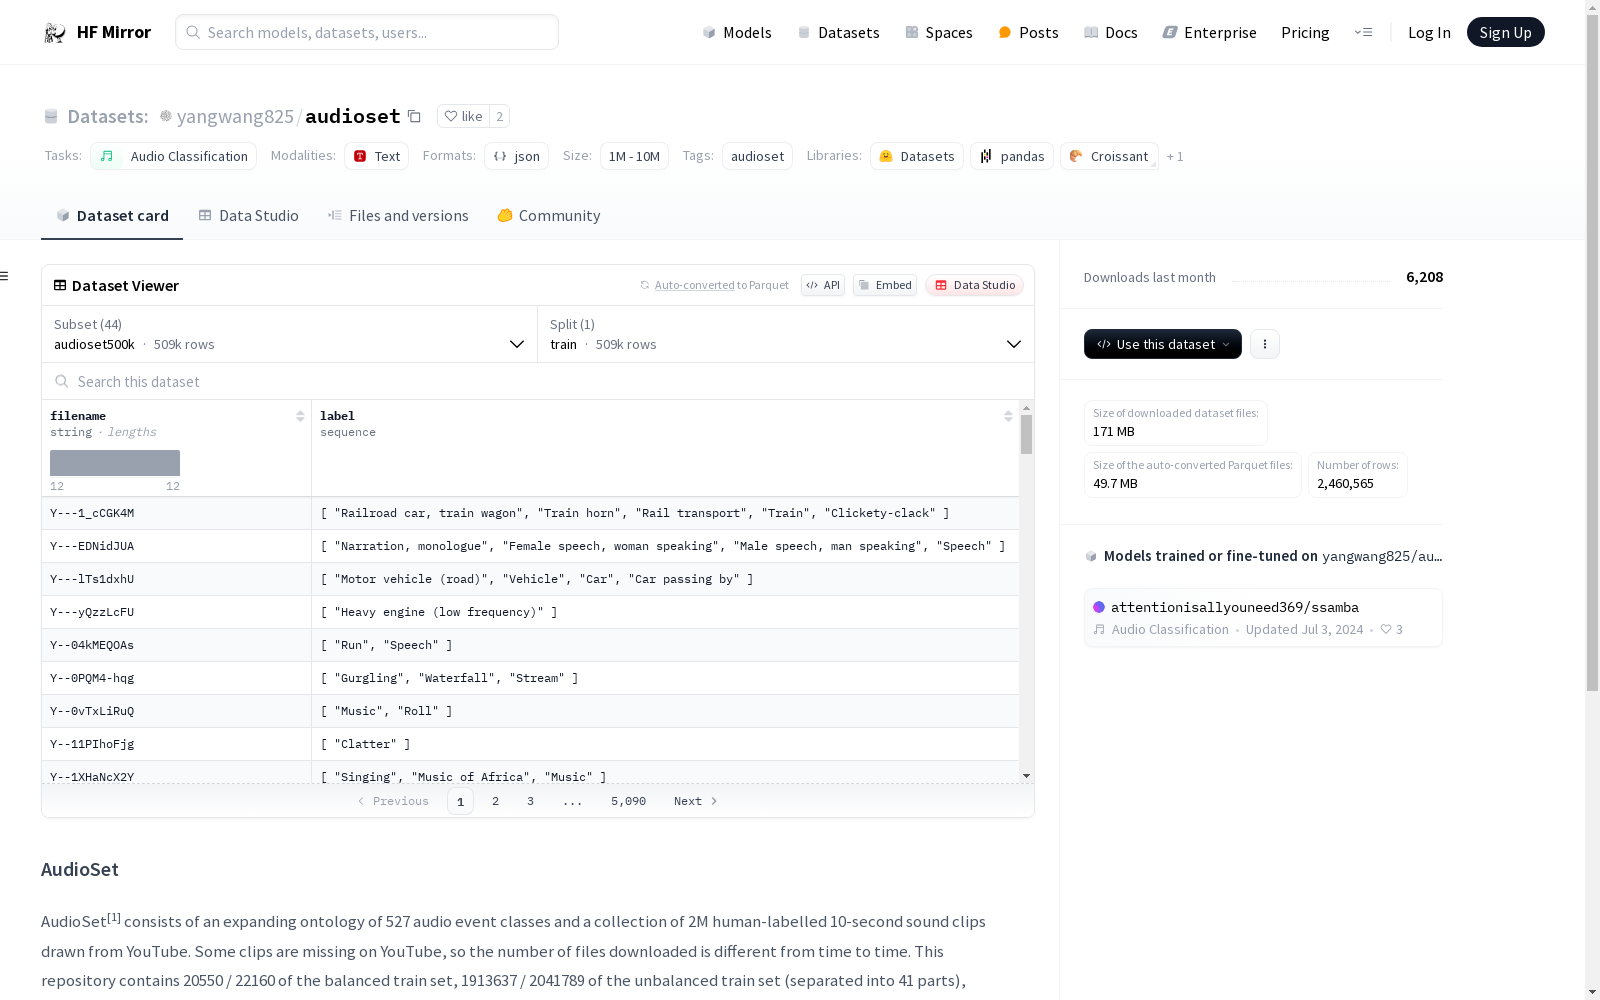
yangwang825/audioset
收藏资源简介:
AudioSet包含一个不断扩展的527个音频事件类别的本体论,以及从YouTube中提取的200万个人工标记的10秒音频剪辑集合。由于部分剪辑在YouTube上缺失,因此下载的文件数量会有所不同。该仓库包含了平衡训练集的20550/22160个文件,非平衡训练集的1913637/2041789个文件(分为41部分),以及评估集的18887/20371个文件。为了提高训练效率,还添加了一个稍微更平衡的子集AudioSet500K。
AudioSet includes an expanding ontology of 527 audio event classes, as well as a collection of 2 million manually labeled 10-second audio clips extracted from YouTube. The number of downloaded files may vary, as some clips are no longer available on YouTube. This repository contains 20550/22160 files for the balanced training set, 1913637/2041789 files for the unbalanced training set (split into 41 parts), and 18887/20371 files for the evaluation set. To improve training efficiency, a slightly more balanced subset named AudioSet500K has also been added.
AudioSet 数据集概述
数据集配置
AudioSet 数据集包含多个配置,每个配置对应不同的数据文件和分割:
-
audioset500k:
- 训练集:
audioset500k.json
- 训练集:
-
balanced_train:
- 训练集:
balanced_train.json
- 训练集:
-
eval:
- 测试集:
eval.json
- 测试集:
-
unbalanced_train_part00 至 unbalanced_train_part40:
- 每个部分对应一个 JSON 文件,例如
unbalanced_train_part00.json至unbalanced_train_part40.json
- 每个部分对应一个 JSON 文件,例如
数据集描述
AudioSet 包含 527 个音频事件类别的扩展本体和从 YouTube 抽取的 200 万个 10 秒长的人工标注声音片段。部分片段在 YouTube 上缺失,因此下载的文件数量会有所不同。
该数据集包括:
- 平衡训练集的 20550 / 22160 个文件
- 不平衡训练集的 1913637 / 2041789 个文件(分为 41 个部分)
- 评估集的 18887 / 20371 个文件
为了提高训练效率,增加了稍微更平衡的子集 AudioSet500K。
参考文献
- Gemmeke, Jort F., et al., Audio set: An ontology and human-labeled dataset for audio events, 2017
- Kong, Qiuqiang, et al., Panns: Large-scale pretrained audio neural networks for audio pattern recognition, 2020
- Nagrani, Arsha, et al., Attention bottlenecks for multimodal fusion, 2021