
遇见数据集

myanmar-shopvoice

收藏
Hugging Face2026-08-02 更新2026-08-03 收录
官方服务:

资源简介:

Myanmar ShopVoice 是一个缅甸语(缅甸语)语音数据集,专注于购物/收银员风格的语音订单场景。该数据集包含16kHz单声道WAV格式的音频文件及其对应的缅甸语文本转录,可用于自动语音识别(ASR)和文本转语音(TTS)任务的训练与评估。数据集以单一训练分割形式呈现,所有样本均可在数据集查看器中浏览。相关微调模型为 thantzinphyo/whisper-tiny-myanmar-shopvoice。
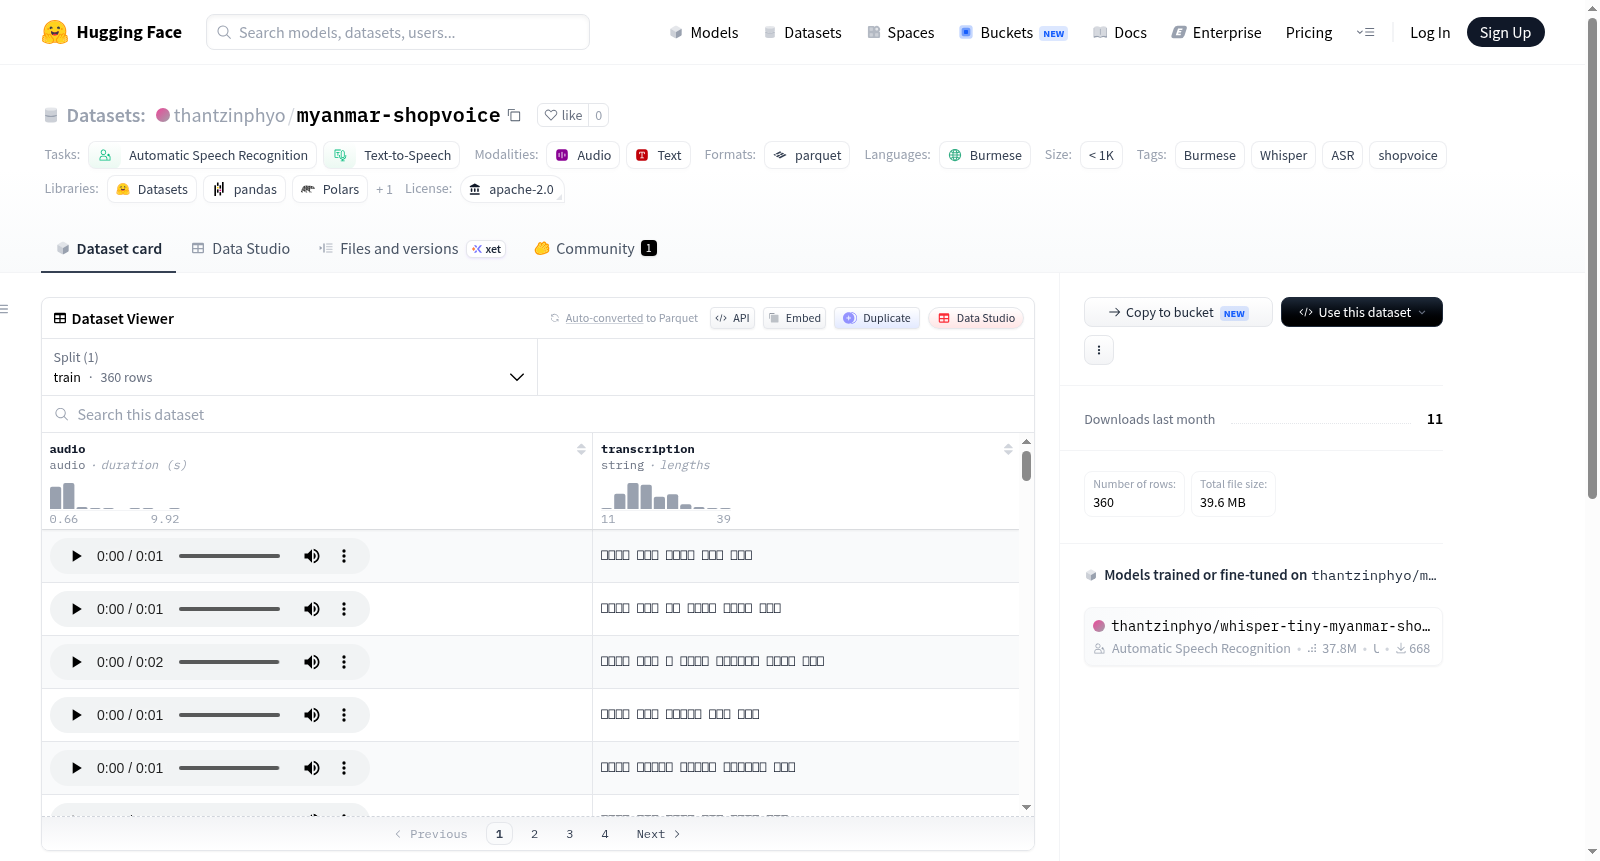
Myanmar ShopVoice is a Burmese speech dataset focused on shopping/cashier-style voice order scenarios. The dataset contains audio files in 16kHz mono WAV format along with their corresponding Burmese text transcriptions, which can be used for training and evaluation of automatic speech recognition (ASR) and text-to-speech (TTS) tasks. The dataset is presented in a single training split, and all samples can be browsed in the dataset viewer. The associated fine-tuned model is thantzinphyo/whisper-tiny-myanmar-shopvoice.

创建时间:
2026-08-02
原始信息汇总

数据集概述:Myanmar ShopVoice

Myanmar ShopVoice 是一个专为缅甸语(Burmese)设计的语音数据集,主要面向商店/收银台场景下的语音指令收集与处理。

基本信息

  • 语言:缅甸语(my
  • 许可证:Apache 2.0
  • 任务类型:自动语音识别(ASR)与文本转语音(TTS)
  • 标签:缅甸语、Whisper、ASR、shopvoice

数据内容

  • 音频:16 kHz 单声道 WAV 格式
  • 转录文本:对应的缅甸语文本转录

数据划分

  • 数据集仅包含一个 train 分割,所有样本均在该分割中展示。
  • 数据以 Parquet 格式存储(data/train-*.parquet)。

相关模型

搜集汇总
数据集介绍
myanmar-shopvoice 数据集图片
构建方式
Myanmar ShopVoice 数据集是针对缅甸语店铺/收银员场景的语音识别与合成任务而构建的。该数据集采集了缅甸语店铺领域中的自然语音,经过整理与标注,形成了包含音频及对应缅甸语文本转录的语料库。数据集的构建旨在为自动语音识别(ASR)和文本到语音(TTS)模型提供领域相关的训练与评估素材,其音频统一为16kHz单声道的WAV格式,确保数据的一致性和可用性。
使用方法
使用时,用户可通过HuggingFace的datasets库加载该数据集,利用其训练划分进行模型训练或评估。对于ASR任务,可将音频和转录文本用于微调语音识别模型,如Whisper;对于TTS任务,则可使用转录文本和音频对进行语音合成训练。建议结合相关的预训练模型,如thantzinphyo/whisper-tiny-myanmar-shopvoice,以获得更好的领域适应性能。数据集的简洁结构使其易于集成到现有数据管道中,支持学术研究和商业应用。
背景与挑战
背景概述
Myanmar ShopVoice数据集由研究者thantzinphyo于近期创建,旨在为缅甸语(Myanmar)的自动语音识别(ASR)和文本转语音(TTS)任务提供专门的店铺场景语音数据。该数据集聚焦于商店和收银台环境下的语音指令,包含16kHz单声道WAV音频及其对应的缅甸语文本转录,为缅甸语语音技术的研究与应用提供了宝贵的资源。其相关模型whisper-tiny-myanmar-shopvoice已基于此数据集进行微调,展示了该数据在提升特定场景语音识别性能方面的实际价值,对低资源语言语音研究领域具有积极的推动作用。
当前挑战
该数据集所面临的挑战包括:领域问题方面,缅甸语作为低资源语言,通用语音识别模型在商店嘈杂环境下的表现不佳,尤其在收银、点单等特定指令的识别上准确率较低,这限制了语音助手和自动结账系统的发展。构建过程中,收集和标注缅甸语店铺场景的真实语音数据难度大,需要覆盖多样的口音、方言和噪声环境,确保数据的代表性和质量,同时克服人工转录的高昂成本和时间消耗。此外,数据集的规模可能有限,难以支撑大规模模型的训练,如何有效扩展数据量和多样性成为持续挑战。
常用场景
经典使用场景
Myanmar ShopVoice数据集专为缅甸语自动语音识别(ASR)与文本转语音(TTS)任务而构建,其核心场景聚焦于商店及收银员风格的语音指令处理。该数据集包含16kHz单声道WAV音频及对应的缅甸语文本转写,为研究者提供了高质量的域内语音资源。典型应用包括训练端到端语音识别模型,如微调Whisper系列以提升对缅甸语口音、语速及噪声鲁棒性;同时也可用于语音合成系统,生成自然流畅的商店场景提示音。该数据集填补了缅甸语在垂直领域语音资源的空白,为低资源语言的技术探索提供了实验基床。
解决学术问题
该数据集有效应对了缅甸语在特定领域(如零售)语音识别研究中训练数据稀缺的难题。在学术层面,它支持研究者开展跨语言迁移学习、低资源场景下的模型压缩与微调策略探讨,并为语音识别中的域适应(domain adaptation)研究提供标准基准。通过提供真实商店噪声环境下的语音样本,它促进了对抗性训练、数据增强等鲁棒性方法在缅甸语上的验证,从而推动了低资源语言语音技术的理论进步。
实际应用
在产业界,该数据集直接赋能智能零售解决方案,例如开发支持缅甸语的语音下单系统、智能收银辅助及客户服务机器人。基于此数据集微调的ASR模型可集成于移动应用或嵌入式设备,实现快速准确的语音指令识别,优化门店运营效率。此外,其音频数据还可用于构建语音交互的客服日志分析工具,或为缅甸语语音助手提供定制化语音合成能力,从而在真实商业场景中实现技术落地。
数据集最近研究
最新研究方向
该数据集聚焦于缅甸语在零售场景下的语音识别与合成研究,开辟了低资源语言在垂直领域应用的新前沿。随着全球电商与实体店铺数字化转型加速,针对收银员与顾客交互场景的专用语音数据集成为提升ASR系统鲁棒性的关键。Myanmar ShopVoice通过提供包含真实店堂噪音、口音变化及行业术语的语音样本,使研究者能够探索领域自适应、数据增强及跨语言迁移学习等技术,尤其为Whisper等大规模预训练模型在低资源语言上的微调提供了宝贵资源。其发布不仅促进了缅甸语自然语言处理技术的落地,也为全球多语言语音助手在零售行业的普及奠定了基础,对推动包容性AI发展具有重要意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

