
fxmeng/WizardLM_evol_instruct_V2_143k
收藏官方服务:
资源简介:
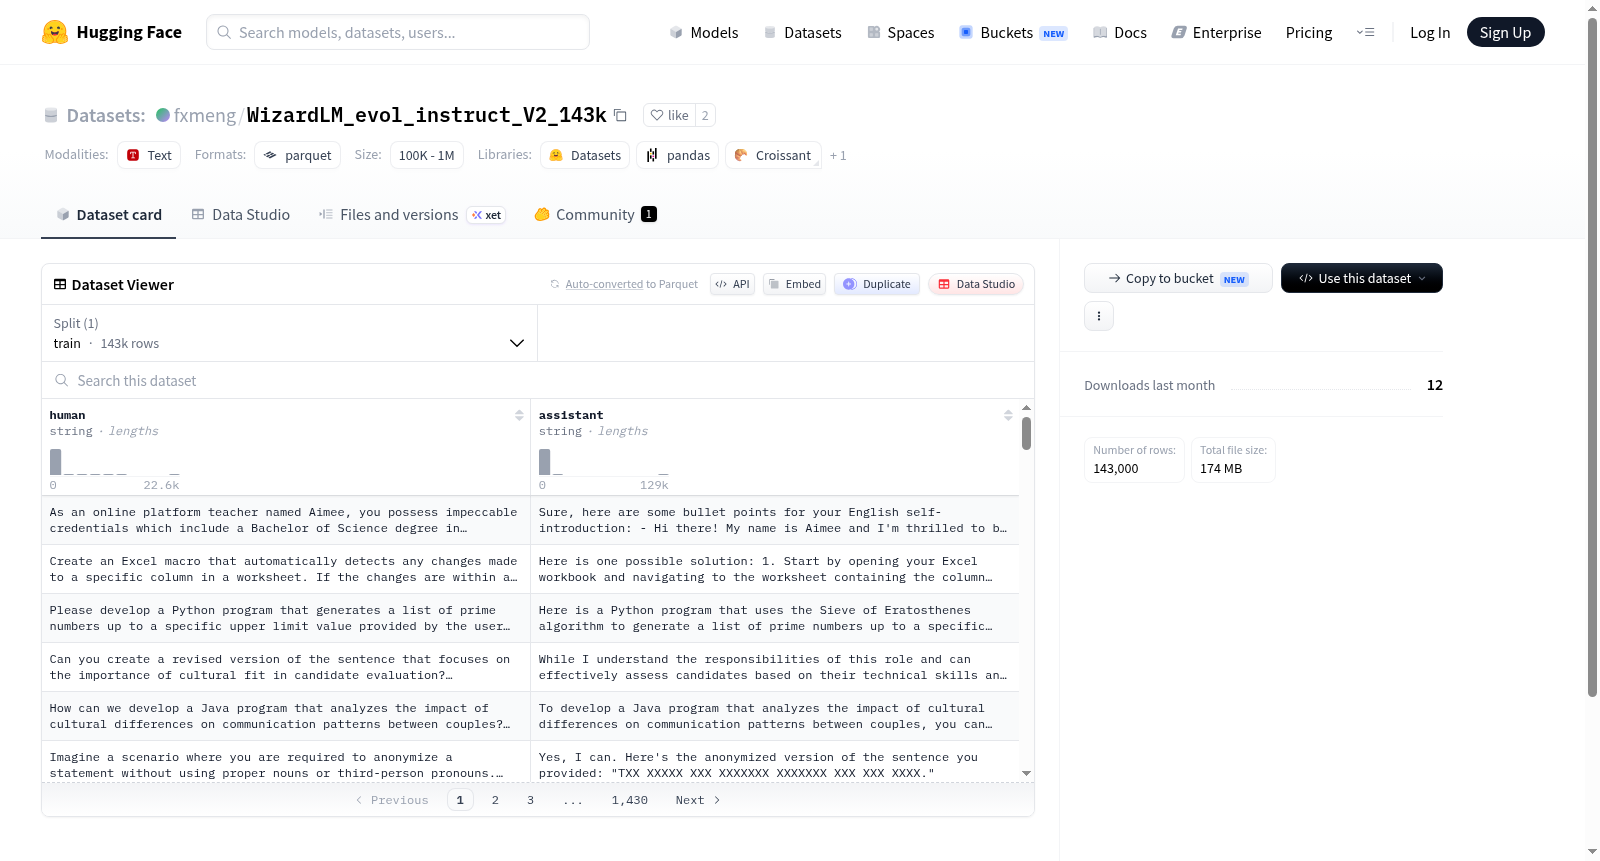
该数据集是YeungNLP/WizardLM_evol_instruct_V2_143k的副本,包含两个主要特征:human和assistant,均为字符串类型。数据集分为一个训练集,包含143,000个样本,总大小为332,002,067字节。下载大小为173,825,782字节。
该数据集是YeungNLP/WizardLM_evol_instruct_V2_143k的副本,包含两个主要特征:human和assistant,均为字符串类型。数据集分为一个训练集,包含143,000个样本,总大小为332,002,067字节。下载大小为173,825,782字节。
提供机构:
fxmeng原始信息汇总
数据集概述
数据集信息
- 特征:
- human: 数据类型为字符串
- assistant: 数据类型为字符串
- 分割:
- train: 包含332,002,067字节的数据,共有143,000个样本
- 下载大小: 173,825,782字节
- 数据集大小: 332,002,067字节
配置
- 配置名称: default
- 数据文件:
- 分割: train
- 路径: data/train-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
在大型语言模型的指令微调领域,高质量对话数据的构建至关重要。WizardLM_evol_instruct_V2_143k数据集源自YeungNLP的原始版本,通过复制与整理形成了一份包含14.3万条训练样本的指令数据集。每条数据由human和assistant两个字段构成,分别代表用户提出的指令与模型生成的回答,结构简洁明了,便于直接用于模型的监督式微调。
特点
该数据集的核心特点在于其规模与格式的标准化。143,000条精心整理的对话对覆盖了多样化的用户指令场景,为模型提供了丰富的语义与任务类型学习素材。数据仅包含训练集,无验证或测试集划分,有助于研究者专注于模型的基础能力提升。同时,数据以Parquet格式存储,兼顾了存储效率与读取速度,适合大规模训练流程。
使用方法
使用该数据集时,开发者可直接通过HuggingFace Datasets库加载默认配置下的训练数据。每条样本的human字段作为输入,assistant字段作为目标输出,适用于序列到序列的生成任务。建议在微调过程中结合标准的语言模型损失函数,对模型进行全参数或参数高效微调,以提升其遵循指令与生成连贯回答的能力。
背景与挑战
背景概述
在自然语言处理领域,指令微调数据集的构建是提升大语言模型遵循人类意图能力的关键环节。WizardLM_evol_instruct_V2_143k数据集由YeungNLP团队于2023年创建,旨在通过进化指令生成技术解决传统人工标注数据规模有限、多样性不足的问题。该数据集包含143,000条高质量的人机对话样本,每条数据由用户指令(human)和模型回复(assistant)组成,覆盖数学推理、代码生成、创意写作等复杂任务场景。作为WizardLM系列的核心训练数据,该数据集通过自动化的指令复杂度进化策略,显著提升了模型对多轮对话和长文本指令的泛化能力,为后续如WizardCoder等模型提供了关键数据支撑,在开源社区中推动了指令微调范式的革新。
当前挑战
当前该数据集面临的核心挑战体现在三个层面。首先,在领域问题解决层面,尽管进化指令生成技术提升了指令多样性,但数据仍存在长尾分布问题——部分高难度推理任务(如多步数学证明)的样本占比不足5%,导致模型在极端复杂场景下容易产生逻辑断裂或幻觉。其次,在构建过程中,原始数据源自对现有开源指令集的二次进化,这种依赖关系使得数据集的原创性受到质疑,且进化策略本身缺乏对指令语义完整性的约束,可能出现指令过度复杂化而失去实际可解性的现象。最后,数据质量管控面临瓶颈,143k条样本仅依赖自动化的进化规则筛选,缺少人工校验环节,致使部分对话存在上下文不一致或知识性错误,这对依赖该数据集训练的模型可靠性构成潜在威胁。
常用场景
经典使用场景
在自然语言处理领域,指令微调数据集是提升大语言模型遵循人类意图能力的关键资源。WizardLM_evol_instruct_V2_143k 作为一款高质量的指令-回答配对数据集,其经典使用场景在于对预训练语言模型进行监督微调,以增强模型在多轮对话、任务导向型指令执行以及复杂推理方面的表现。研究者通常利用该数据集训练模型,使其能够精准理解用户意图并生成符合上下文逻辑的回应,从而显著提升模型在实际交互中的实用性与可控性。
实际应用
在实际应用中,基于该数据集微调的模型被广泛部署于智能客服、虚拟助手、代码辅助生成及教育辅导等场景。例如,在智能客服系统中,模型能够准确拆解用户提出的复合型问题(如“查询上周订单并修改收货地址”),并分步执行操作;在代码开发场景中,模型可依据自然语言描述生成对应代码片段,显著提升开发效率。这些应用极大地降低了人机交互的门槛,使非专业用户也能通过自然语言高效调用复杂功能。
衍生相关工作
该数据集衍生了一系列经典研究工作,包括但不限于基于进化指令策略的模型自改进方法(如WizardCoder系列)以及针对指令质量与多样性的优化框架。后续工作如Evol-Instruct技术通过迭代生成更复杂的指令样本,进一步提升了模型的推理边界;同时,该数据集也被用作评估基准,催生了多项关于指令遵循能力与模型规模关系的实证分析,为构建更高效、更安全的对话系统提供了理论支撑与实践范式。
以上内容由遇见数据集搜集并总结生成


