astra-skills
收藏资源简介:
Astra Skills Collection 是一个包含148,134个去重AI代理技能的数据集,通过Astra从GitHub仓库爬取并于2026-04-15生成快照。每个技能目录包含SKILL.md文件和_meta.json元数据文件,其中_meta.json记录了来源网站、仓库URL、所有者等信息。数据集通过特定流程爬取:从技能索引网站发现GitHub仓库,克隆仓库,递归检测包含SKILL.md的目录,复制技能目录并基于SKILL.md内容的MD5哈希去重。该数据集适用于编码代理工具使用和指令跟随行为研究、技能检索与组合实验以及真实世界代理技能生态系统分析。数据集元数据采用Apache-2.0许可,各技能内容保持其原始仓库许可。
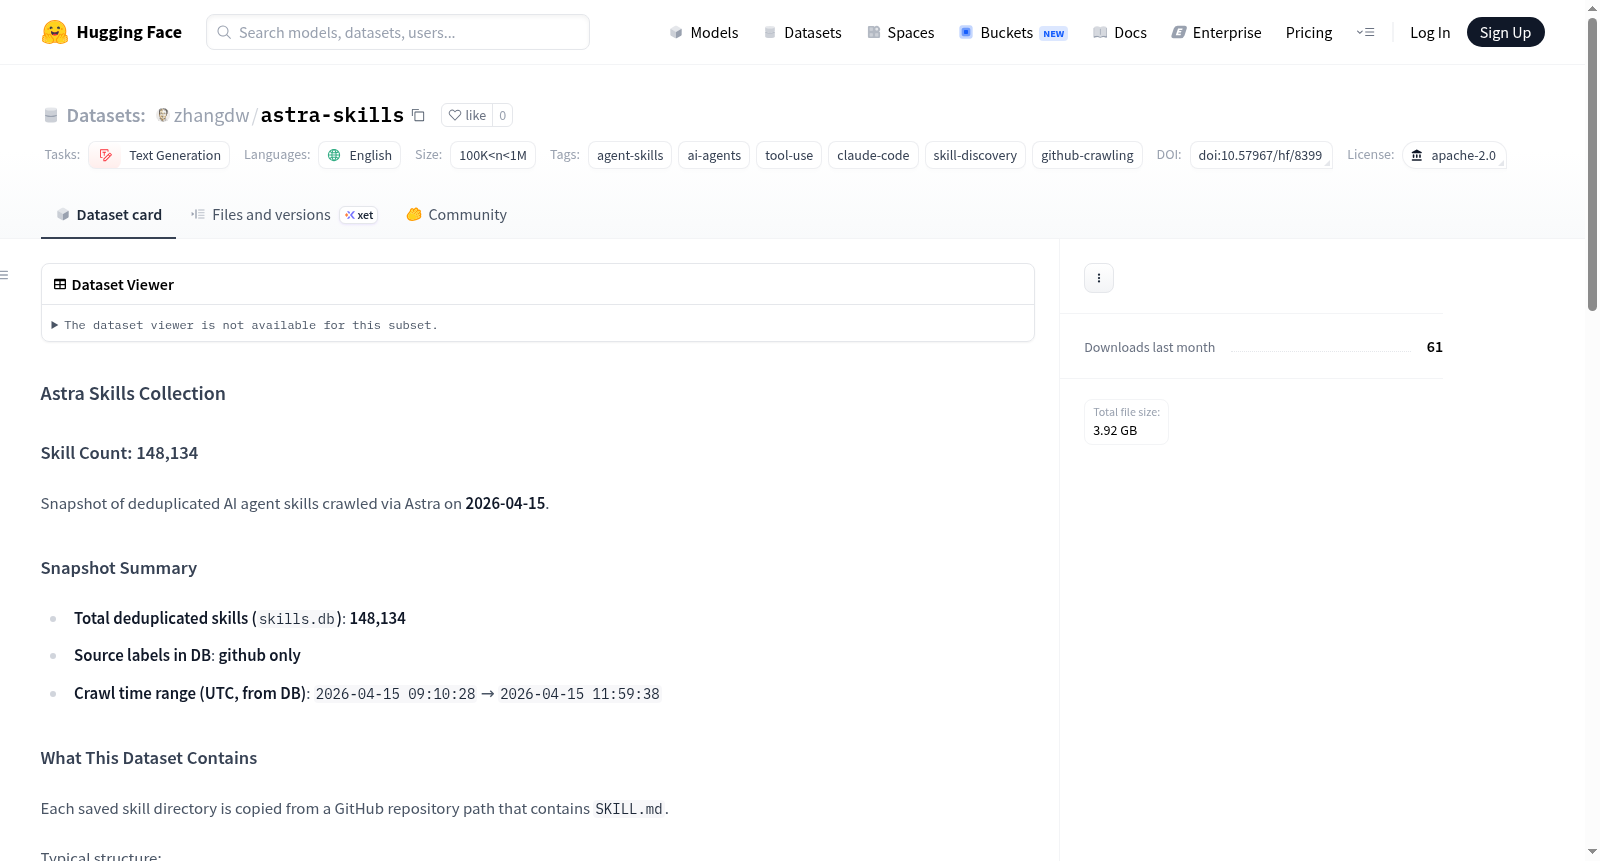
Astra Skills Collection is a dataset consisting of 148,134 deduplicated AI agent skills. It was crawled from GitHub repositories via Astra, with a snapshot generated on 2026-04-15. Each skill directory contains a SKILL.md file and a _meta.json metadata file, where _meta.json records information such as the source website, repository URL, and owner. The dataset is constructed through a specific workflow: first, discover GitHub repositories from skill indexing websites, clone the repositories, recursively detect directories that include SKILL.md, copy the identified skill directories, and perform deduplication based on the MD5 hash of the content within SKILL.md. This dataset is applicable to research on agent tool usage and instruction-following behavior, skill retrieval and composition experiments, as well as real-world agent skill ecosystem analysis. The dataset’s metadata is licensed under Apache-2.0, while the content of each individual skill retains the original license from its source repository.
Astra Skills Collection 数据集概述
数据集基本信息
- 数据集名称:Astra Skills Collection
- 发布者:Dawei Zhang (GitHub: zhangdw156)
- 许可证:数据集元数据和打包使用 Apache-2.0 许可证。单个技能内容仍受其原始仓库许可证约束。
- 任务类别:文本生成
- 主要语言:英语
- 数据规模:100K < n < 1M
- 标签:agent-skills, ai-agents, tool-use, claude-code, skill-discovery, github-crawling
数据集内容与统计
- 技能总数(去重后):148,134
- 数据源标签:仅 GitHub
- 快照日期:2026-04-15
- 爬取时间范围(UTC):2026-04-15 09:10:28 → 2026-04-15 11:59:38
数据结构
每个保存的技能目录均复制自包含 SKILL.md 文件的 GitHub 仓库路径。
典型结构如下:
{source}{owner}{skill_name}/ ├── SKILL.md ├── _meta.json └── [可选文件,例如 scripts/]
其中 _meta.json 存储爬取元数据,如来源网站、仓库 URL、所有者、仓库名、技能名称和相对路径。
爬取流程
- 从技能索引网站(
skills.sh、skillstore.io、agent-skills.md)及配置的种子仓库中发现 GitHub 仓库。 - 克隆发现的仓库。
- 递归检测包含
SKILL.md的目录。 - 将技能目录复制到本数据集的布局中。
- 通过
skills.db中SKILL.md内容的 MD5 哈希值进行去重。
注意:网站索引覆盖率不保证能成功检索到列出的每一个技能,因为仓库的可访问性和内容可用性可能有所不同。
预期用途
- 编码智能体中工具使用和指令遵循行为的研究
- 技能检索、排序和组合实验
- 真实世界智能体技能生态系统的分析
引用信息
若在研究中使用此数据集,请引用: bibtex @misc{dawei_zhang_2026, author = { Dawei Zhang }, title = { astra-skills (Revision 146eb8c) }, year = 2026, url = { https://huggingface.co/datasets/zhangdw/astra-skills }, doi = { 10.57967/hf/8399 }, publisher = { Hugging Face } }