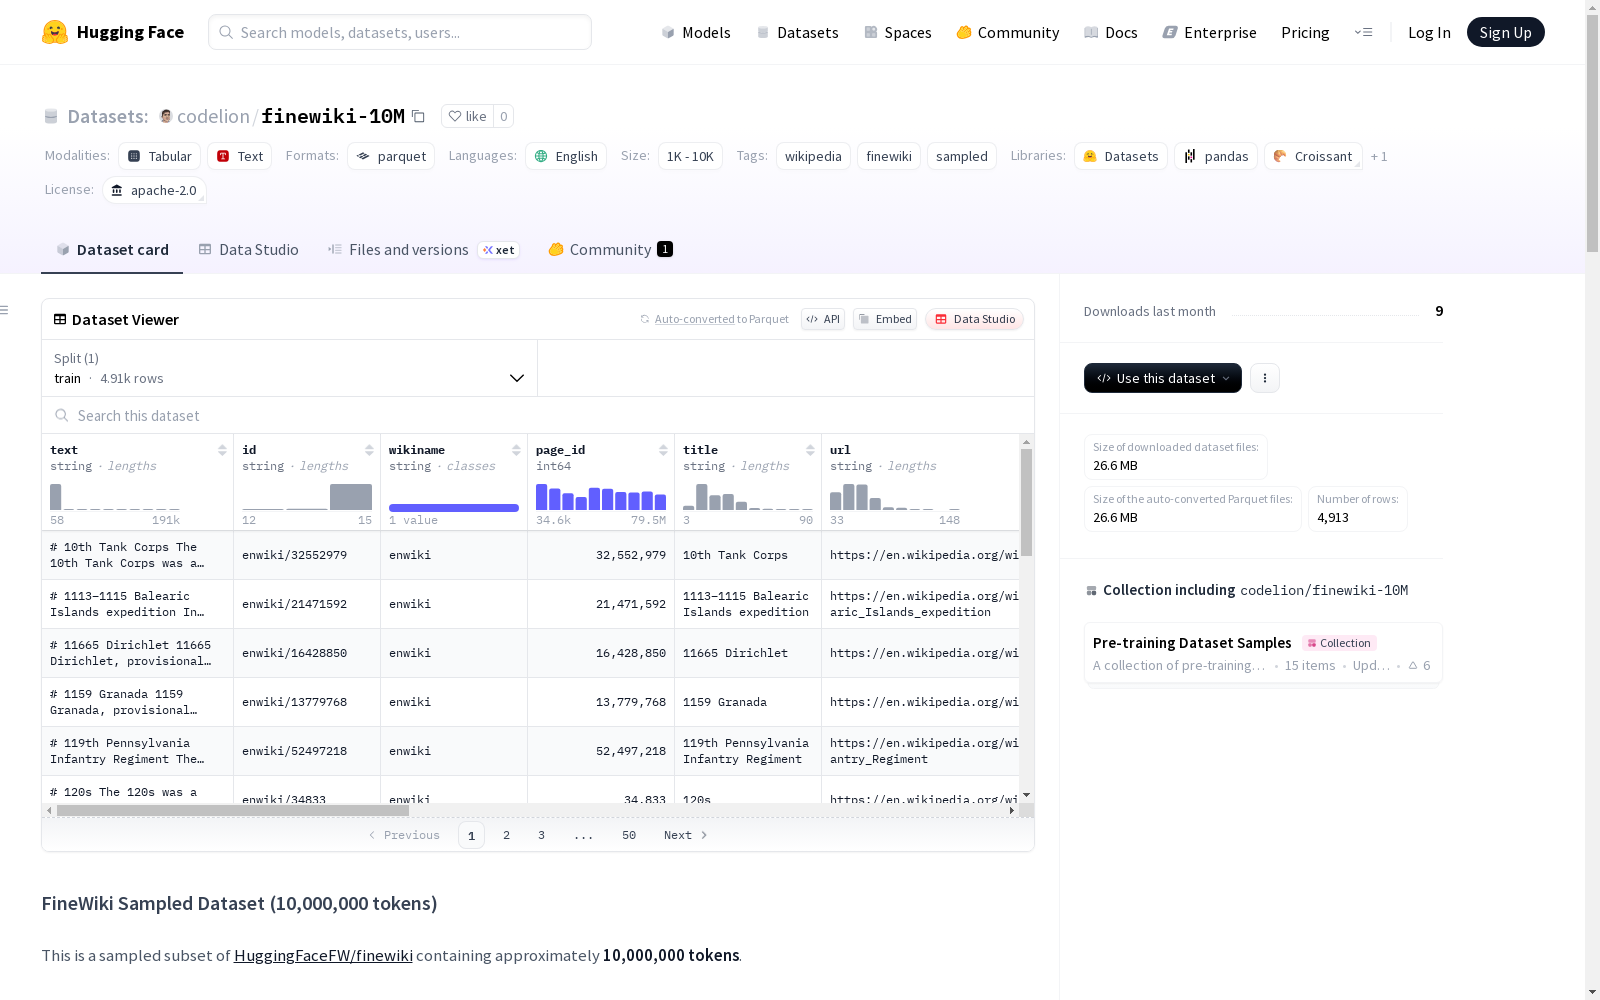
finewiki-10M
收藏资源简介:
FineWiki样本数据集是一个从FineWiki数据集中采样的子集,包含大约1000万个token。它使用GPT-2 tokenizer进行采样,并确保了每个文档被选中的概率相等,没有分布偏差。数据集适用于小规模的预训练实验、数据集组成研究、快速原型设计和测试以及低成本训练运行。
The FineWiki Sample Dataset is a subset sampled from the FineWiki dataset, containing approximately 10 million Tokens. It was sampled using the GPT-2 Tokenizer, with equal selection probability assigned to each document to ensure no distribution bias. This dataset is suitable for small-scale pre-training experiments, dataset composition research, rapid prototyping and testing, as well as low-cost training runs.
FineWiki Sampled Dataset (10,000,000 tokens) 数据集概述
数据集基本信息
- 语言: 英语
- 许可证: Apache 2.0
- 标签: Wikipedia, FineWiki, Sampled
- 数据量: 7,088个文档
- 总标记数: 约10,000,000个标记
数据来源与采样方法
- 原始数据集: HuggingFaceFW/finewiki(英语子集,训练分割)
- 采样方法: 水库采样(无偏随机采样)
- 目标标记数: 10,000,000个标记
- 标记器: GPT-2(50,257词汇表)
- 随机种子: 42
采样统计信息
- 平均标记数/文档: 1411.0
- 采样算法特点:
- 无偏随机样本
- 每个文档具有相等的被选择概率
- 无分布偏差
- 基于流式处理
数据结构特征
- 分割: 训练集(7,088个样本)
- 特征字段:
- text(字符串):维基百科文章文本
- id(字符串):唯一标识符
- wikiname(字符串):维基百科源名称
- page_id(int64):维基百科页面ID
- title(字符串):文章标题
- url(字符串):源维基百科URL
- date_modified(字符串):最后修改日期
- in_language(字符串):语言代码(始终为en)
- wikidata_id(字符串):维基数据标识符
- bytes_html(int64):HTML内容大小
- wikitext(字符串):原始维基文本标记
- version(int64):文章版本号
- infoboxes(字符串):提取的信息框数据
- has_math(布尔值):是否包含数学公式
使用场景
- 小规模语言模型预训练实验
- 数据集组成研究
- 快速原型设计和测试
- 低成本训练运行
引用信息
bibtex @article{sharma2025billion, title={The 1 Billion Token Challenge: Finding the Perfect Pre-training Mix}, author={Sharma, Asankhaya}, year={2025}, url={https://huggingface.co/blog/codelion/optimal-dataset-mixing/} }
许可证与作者
- 许可证: Apache 2.0
- 数据集卡作者: CodeLion
- 联系方式: 通过数据集存储库提交问题