
遇见数据集

jasir/palsynet-data

收藏
Hugging Face2024-06-06 更新2024-06-12 收录
官方服务:

资源简介:

一个包含受贝尔氏麻痹(面瘫)影响的人脸图像的数据集。通过编辑公开的YouTube视频创建,同时也包含了未受影响的对照图像。数据集以视频形式提供,每个视频对应一个人,并提供了一个脚本来从视频中提取帧以创建图像数据集。

A dataset containing facial images of individuals affected by Bell's palsy (facial paralysis). This dataset was constructed by editing publicly available YouTube videos, and also includes control images of unaffected individuals. The dataset is provided in video format, with each video corresponding to one individual, and a supplementary script is provided to extract frames from the videos to create an image dataset.

提供机构:
jasir
原始信息汇总

面部麻痹数据集

数据集描述

面部麻痹数据集包含受贝尔麻痹症(面部麻痹)影响的人的面部图像。该数据集通过筛选和编辑公开可用的YouTube视频创建,同时也包括未受影响的人的图像。

  • 许可证: CC-BY-4.0

用途

该数据集可用于训练图像模型,以检测和分类面部图像上贝尔麻痹症的迹象或严重程度。

数据集结构

数据以视频形式提供,每人一个视频。提供了一个脚本来从这些视频中提取单个帧,以创建用于进一步处理和训练的图像数据集。

提取图像

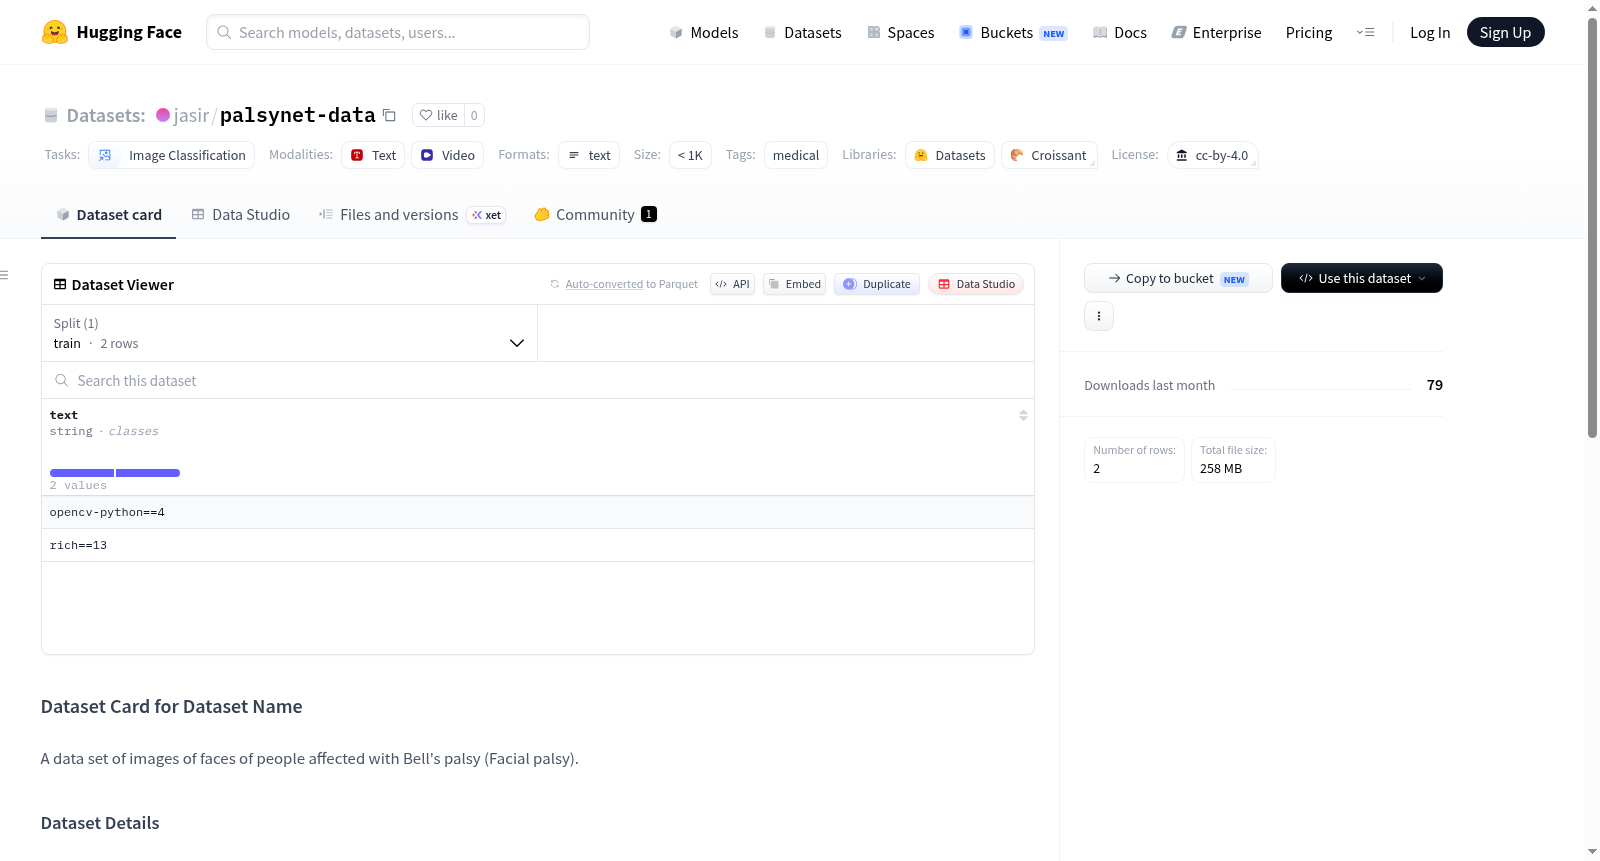
使用提供的脚本 extract_images.py 可以提取图像。可以通过 requirements.txt 文件安装脚本所需的依赖项(即 opencv-python 和 rich)。

bash pip install -r requirements.txt python extract_images.py

脚本中可以配置输出目录和连续图像之间要跳过的帧数。
搜集汇总
数据集介绍
jasir/palsynet-data 数据集图片
构建方式
面部神经麻痹(贝尔氏麻痹)作为一种常见的神经系统疾病,其临床诊断高度依赖于面部特征的视觉评估。为构建高质量的医学影像数据集,研究者从公开的YouTube视频资源中精心筛选并编辑了受贝尔氏麻痹影响的个体面部影像,同时采用相同的方法采集了未患病个体的面部图像作为对照。数据集以每位个体一个视频文件的形式组织,并配套提供了用于从视频中提取静态帧的脚本,通过配置输出目录和帧间隔参数,可生成用于后续模型训练的图像样本集。
特点
该数据集在医学图像分类领域具有显著特色。其核心优势在于构建了包含患病与健康对照的双模态样本体系,为面部麻痹的自动化检测提供了平衡的训练基础。数据集规模介于10K至100K之间,保证了统计效能的充分性。采用视频源而非静态图像的方式,使得帧提取过程中能够捕获面部动态特征的多角度信息,增强了数据多样性。CC-BY-4.0许可协议确保了数据在学术研究中的开放共享与合规使用。
使用方法
数据集的使用流程遵循标准计算机视觉工作流。研究者需先安装依赖库(如opencv-python和rich),随后运行提供的extract_images.py脚本将视频解帧为图像序列。通过调整脚本中的参数,可控制输出目录路径及连续帧之间的跳帧数量,从而平衡数据量与时序冗余。提取后的图像可直接用于训练图像分类模型,实现对面部麻痹症状及其严重程度的自动识别与分级。
背景与挑战
背景概述
面部神经麻痹,尤其是贝尔氏麻痹(Bell's palsy),是一种导致单侧面部肌肉暂时性无力或瘫痪的常见神经系统疾病,其诊断与严重程度评估长期依赖临床主观判断。为推进计算机辅助诊断在该领域的应用,jasir/palsynet-data数据集应运而生。该数据集由研究人员通过系统整理和编辑公开的YouTube视频构建而成,涵盖受贝尔氏麻痹影响与未受影响的人脸图像,旨在为图像分类任务提供标准化训练资源。数据集发布于HuggingFace平台,采用CC-BY-4.0许可协议,包含超过一万张图像样本,其创建聚焦于利用深度学习模型自动检测并分类面部麻痹的体征与强度。这一资源有望弥补该领域高质量标注数据的匮乏,推动医学影像分析技术向客观化、自动化方向发展,对神经康复与远程医疗的临床研究具有重要支撑作用。
当前挑战
该数据集面临的核心挑战源于其构建方式与医学应用的特殊性。首先,在领域问题层面,面部麻痹的检测与分级缺乏统一的金标准,不同严重程度的边界模糊,且面部不对称性受光照、角度、表情等多因素干扰,使得模型需具备高度鲁棒性才能实现可靠分类。其次,构建过程中,数据源自公开视频,导致图像分辨率、拍摄条件、人脸姿态差异显著,增加了数据清洗与标注的难度。此外,视频帧提取虽提供了高效的数据扩充途径,但帧间冗余与运动模糊可能引入噪声,影响模型训练效果。最后,医学数据集的伦理与隐私考量不可忽视,尽管采用公开来源,但仍需确保数据使用符合患者权益保护规范,这对后续数据共享与模型部署构成潜在制约。
常用场景
经典使用场景
在医学图像分析领域,面瘫作为一种常见的神经性疾病,其早期诊断与严重程度评估对临床治疗至关重要。jasir/palsynet-data数据集汇集了贝尔氏麻痹症患者及正常人群的面部图像资源,为构建基于深度学习的图像分类模型提供了高质量的训练素材。研究者可借助该数据集训练卷积神经网络等模型,实现对面瘫症状的自动检测与分级,从而辅助临床医生进行快速、客观的判断。这一经典使用场景不仅提升了诊断效率,也为后续的个性化治疗方案制定奠定了数据基础。
解决学术问题
该数据集有效解决了面瘫研究中高质量标注图像匮乏的关键难题,填补了公开数据集中面部神经疾病样本稀缺的空白。通过提供涵盖不同严重程度的患者与健康对照图像,它支持研究者探索面部对称性分析、特征提取及多分类任务中的算法优化。这一资源推动了计算机视觉技术在神经性疾病诊断中的学术进展,使得模型泛化能力与鲁棒性的评估成为可能,为跨学科合作提供了实证基础,显著促进了医学影像分析与临床决策支持系统的理论发展。
衍生相关工作
该数据集衍生了一系列经典研究工作,包括基于注意力机制的面部对称性检测网络、轻量级移动端部署模型以及面向多模态融合的面瘫严重度分级框架。研究者在此基础上提出了数据增强策略以应对面部姿态与光照变化,并探索了迁移学习在医学小样本场景下的应用。这些工作不仅深化了对面瘫病理特征的理解,还推动了可解释性人工智能在医疗诊断中的落地,为后续构建大规模、多中心的面部神经疾病数据集提供了方法论参考与基准性能指标。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

