
遇见数据集

JingweiNi/ocr2_k2_lowmed_sample500_qwen35_fp8_step1k_seed20260527

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: candidate_id dtype: string - name: source_hf_repo dtype: string - name: reasoning_effort dtype: string - name: row_idx dtype: int64 - name: step_idx dtype: int64 - name: question dtype: string - name: answer dtype: string - name: reply dtype: string - name: prior_steps dtype: string - name: steps_so_far dtype: string - name: latest_step dtype: string - name: claim_sentence dtype: string - name: claim_text dtype: string - name: aligned_token_ids list: int64 - name: verified dtype: float64 - name: is_error dtype: bool - name: valid_step_position dtype: int64 - name: valid_step_count dtype: int64 - name: step_relative_position dtype: float64 - name: step_position_decile dtype: int64 - name: problem_source_dataset dtype: string - name: question_id dtype: string - name: ocr2_id dtype: string - name: language_split dtype: string - name: source_split dtype: string - name: source_platform dtype: string - name: difficulty dtype: string - name: judgement dtype: string - name: pass_rate dtype: string - name: source_index dtype: string - name: sample_idx dtype: int64 - name: original_index dtype: int64 - name: sample_id dtype: int64 - name: sample_seed dtype: int64 splits: - name: train num_bytes: 65480374 num_examples: 1000 download_size: 31530058 dataset_size: 65480374 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
JingweiNi
搜集汇总
数据集介绍
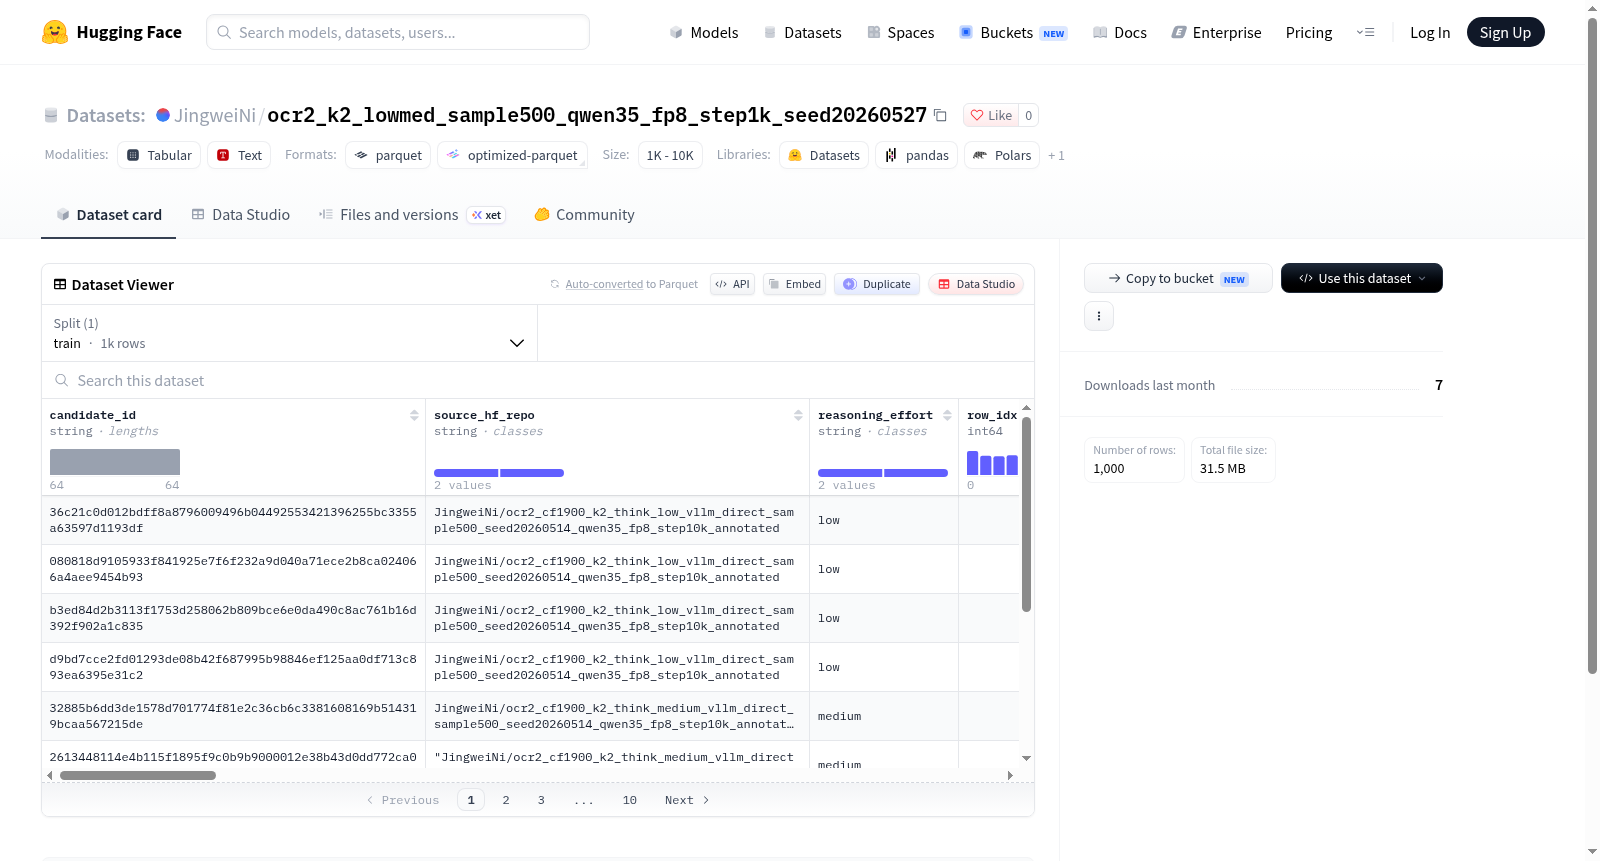
JingweiNi/ocr2_k2_lowmed_sample500_qwen35_fp8_step1k_seed20260527 数据集图片
构建方式
该数据集立足光学字符识别与推理验证的交叉领域,以Qwen3.5模型在FP8精度下生成的逐步推理轨迹为底本,从OCR2相关仓储中采样五百例中等难度样本,并沿随机种子20260527对每个样本抽取至一千步的中间推理状态,形成原始候选池。构建过程中,对每一步的回复文本与对齐词元编号进行细粒度标注,同时记录该步在有效推理序列中的位置、相对位置及十分位位置,并引入验证标志、错误标记与通过率等元信息,使每一步推理状态均可追溯至具体问题来源、平台与难度层级,最终生成一千条训练样本。
特点
该数据集在结构上呈现多维度层级化特征,字段涵盖候选标识、推理强度、步骤索引、前后步文本、声明句与声明文本、对齐词元编号等,可同时支持步骤级定位与词元级对齐分析。其突出之处在于将推理过程拆解为可量化的序列单元,并通过有效步骤位置、相对位置和十分位位置刻画步骤在整体推理链中的位置属性,辅以验证评分与错误标记,为研究推理步骤的可靠性、错误传播与位置偏差提供了细粒度观测窗口,且样本规模适中,便于快速实验与系统调试。
使用方法
研究者可借助HuggingFace数据集接口直接加载训练分片,以question与answer字段作为输入与监督信号,利用reply、prior_steps、steps_so_far和latest_step重建逐步推理上下文,并通过claim_sentence、claim_text与aligned_token_ids开展声明级或词元级的对齐与验证分析。verified、is_error及pass_rate等字段可用于筛选高质量步骤或构建错误检测任务,valid_step_position、step_relative_position与step_position_decile则支持位置相关的统计建模与偏差研究,从而服务于推理过程评估、步骤级奖励建模与错误归因等多种下游场景。
背景与挑战
背景概述
思维链推理已成为大语言模型能力评估的核心范式,而推理过程的忠实性与可验证性则是该领域亟待厘清的关键议题。ocr2_k2_lowmed_sample500_qwen35_fp8_step1k_seed20260527数据集于2026年前后构建,基于Qwen系列模型在低中推理努力设定下的分步推理轨迹采样而成,涵盖候选步骤、声明句、对齐词元编号、验证分数及错误标记等细粒度标注字段,并辅以难度分级与步骤相对位置信息。该数据集聚焦推理链条中单步声明的可信度判定,为过程奖励模型与步骤级验证研究提供结构化语料,对推动可解释推理评测具有参考价值。
当前挑战
该数据集所面向的领域问题在于推理步骤级验证与错误定位,即判定思维链中某一步骤的声明是否忠实于模型实际计算,其难点在于推理文本的语义连贯性与形式正确性往往相互纠缠,单步声明可能表面成立却与全局推导脱节。构建层面亦面临多重挑战:分步轨迹需从原始推理序列中精确切分并完成步骤边界对齐,声明句与对齐词元编号的标注依赖模型内部状态与外部判定的协同,验证标签的可靠性受采样种子与推理努力程度波动影响,而步骤相对位置、难度分层与通过率等元信息的平衡更增加了语料质量控制的复杂度。
常用场景
经典使用场景
在推理型大语言模型的过程监督与步骤级验证研究中,该数据集构成了一项精心设计的步骤级标注资源。其经典使用场景聚焦于对模型逐步推理轨迹的细粒度解析,借助claim_sentence、latest_step、prior_steps与aligned_token_ids等字段,研究者得以将推理链拆解为可验证的原子化步骤,并借助verified、is_error与judgement等标注信号,训练奖励模型或过程奖励模型(PRM)以判别中间步骤的正确性。该数据集融合了OCR2与K2等多项基准的问题来源,涵盖多语言与多难度层级,为逐步验证式推理评估提供了结构化的实验土壤。
解决学术问题
该数据集直面大语言模型推理评估中长期悬而未决的核心难题,即结果导向的最终答案监督难以揭示推理链中潜藏的中间谬误。通过提供步骤相对位置、步骤位置十分位数及有效步骤计数等元信息,研究者得以系统考察推理长度、步骤位置与错误发生概率之间的关联,进而回答“模型在推理链的哪个阶段更易出错”这一关键问题。其步骤级验证标签为过程奖励建模、错误归因分析与推理一致性检验提供了可靠的经验依据,推动了从结果监督向过程监督的范式迁移。
衍生相关工作
围绕该数据集所代表的步骤级验证范式,学术界已衍生出一系列具有影响力的后续工作,涵盖过程奖励模型(PRM)的构建、逐步验证器(step-level verifier)的训练以及推理链自我纠错机制的探索。相关研究借助此类细粒度标注资源,发展了基于蒙特卡洛树搜索的推理路径评估方法,并推动了验证-重排序(verify-and-rerank)框架在推理任务中的广泛应用。这些工作共同深化了对大语言模型推理过程的理解,为构建更可靠、更透明的推理系统奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

