
遇见数据集

abanfalvi/spider_filtered_challenging

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

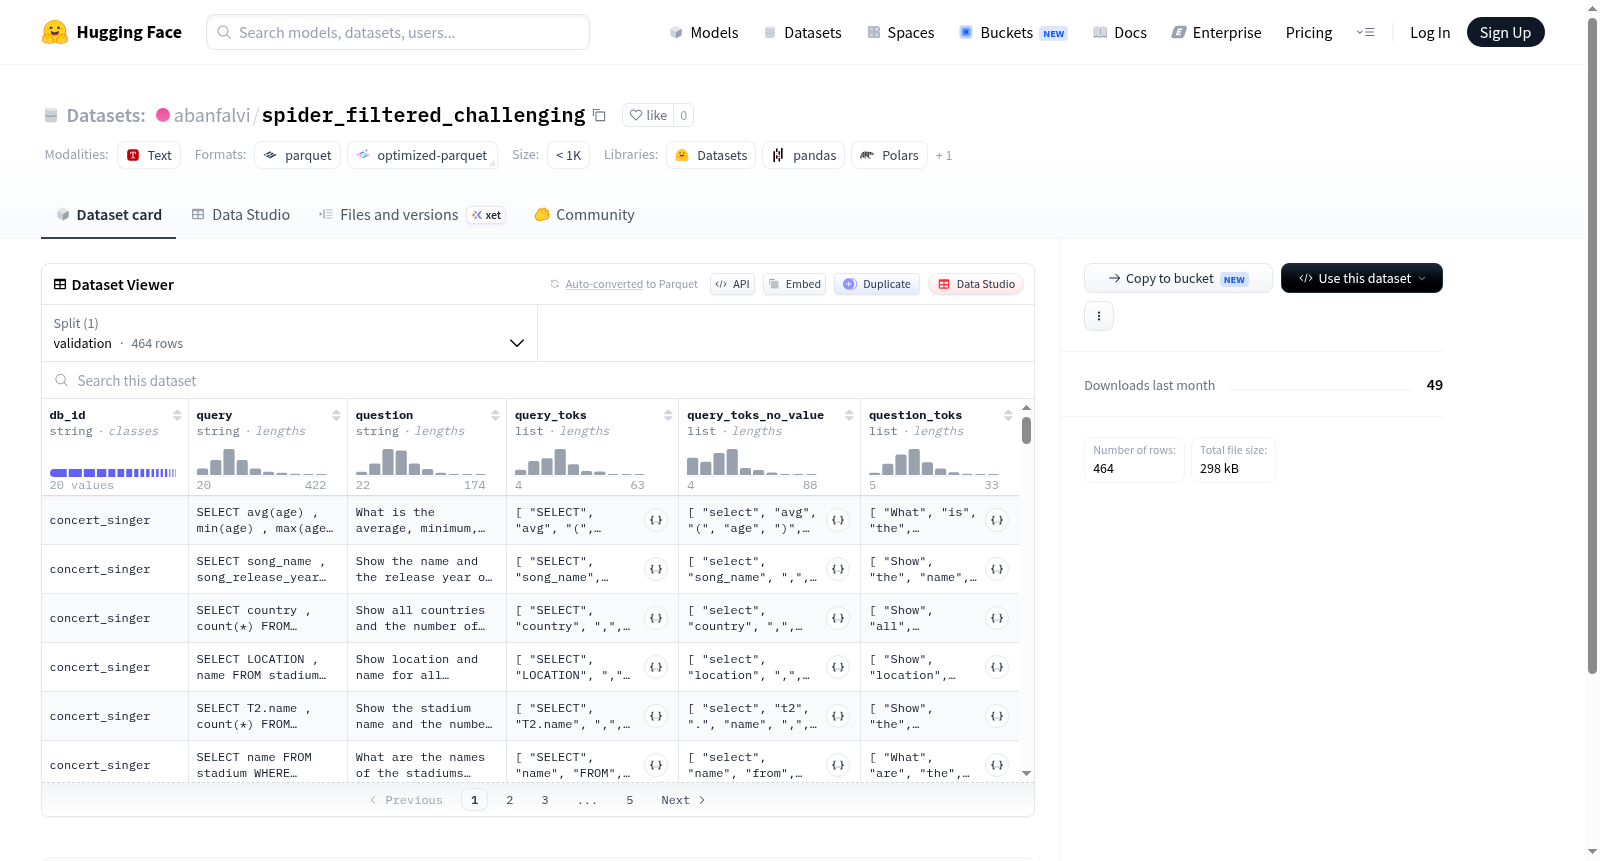
该数据集是一个用于自然语言处理任务的数据集,可能涉及文本到SQL转换或问答系统。它包含以下特征:db_id(数据库标识符)、query(SQL查询语句)、question(自然语言问题)、query_toks(查询语句的分词列表)、query_toks_no_value(去除值的查询分词列表)和question_toks(问题的分词列表)。数据集仅包含验证分割(validation),有464个示例,总大小为306082字节。数据文件位于data/validation-*路径下。

This dataset is intended for natural language processing (NLP) tasks, potentially including text-to-SQL conversion or question answering systems. It comprises the following features: db_id (database identifier), query (SQL query statement), question (natural language question), query_toks (tokenized list of the SQL query), query_toks_no_value (tokenized query list with all values removed), and question_toks (tokenized list of the natural language question). The dataset only includes the validation split, consisting of 464 examples in total, with an overall size of 306082 bytes. The data files are stored under the path data/validation-*.
提供机构:
abanfalvi
搜集汇总
数据集介绍
abanfalvi/spider_filtered_challenging 数据集图片
构建方式
Spider_filtered_challenging数据集基于经典的Spider数据集构建,通过精心筛选和过滤流程,从原始数据中提取出具有较高难度的样本。该数据集保留了数据库标识符、SQL查询语句、自然语言问题及其分词表示等核心字段,尤其关注那些查询逻辑复杂、涉及多表联合或嵌套子查询的实例。构建过程中剔除了简单及重复样本,确保每个样例都具备足够的挑战性,从而为文本到SQL任务提供更具难度的评测基准。
特点
该数据集最显著的特点在于其精选的挑战性实例,仅包含464条验证样本,但每一条都经过严格筛选以凸显复杂语义解析与SQL生成的难度。数据集中每条记录均提供完整的查询分词与去值版本,便于模型学习忽略具体数值、聚焦于逻辑结构。此外,统一的字段设计使研究者能够直接对比不同模型在复杂场景下的表现,是评估高级语义解析能力的理想资源。
使用方法
研究者可直接从HuggingFace数据集库加载spider_filtered_challenging,默认使用validation划分进行模型评估。使用时需将自然语言问题与数据库模式作为输入,模型输出对应的SQL查询语句,并通过提供的查询分词进行精确匹配或执行结果验证。该数据集适合作为文本到SQL任务的进阶测试集,建议与标准Spider数据结合,用于诊断模型在处理复杂查询时的薄弱环节。
背景与挑战
背景概述
在自然语言处理与数据库交叉领域,将自然语言问题转化为可执行的SQL查询语句是一项极具挑战的任务,即Text-to-SQL任务。Spider数据集作为该领域的标杆性基准,自2018年由耶鲁大学等机构研究人员提出以来,极大推动了跨领域、复杂查询场景下语义解析技术的发展。然而,标准Spider数据集中的部分样本因查询逻辑简单或数据库模式单一,难以全面评估模型的鲁棒性与泛化能力。为此,研究人员构建了Spider_filtered_challenging数据集,专注于筛选出高难度的464个验证样本,旨在聚焦模型在处理复杂嵌套查询、多表连接及细粒度条件约束时的真实性能瓶颈,对深入剖析语义解析模型的局限性具有重要价值。
当前挑战
Spider_filtered_challenging数据集所解决的领域问题核心在于Text-to-SQL任务中复杂查询的语义理解与结构生成挑战。具体而言,模型需应对多类型数据库模式下的跨表关联推理、嵌套子查询的层次化建模、以及同义表达与模糊指代的消歧难题。在构建过程中,研究者面临的主要挑战包括:如何从原始Spider数据集中系统性地识别并过滤出高难度样本,避免简单查询的干扰;如何确保筛选后的样本覆盖足够多样的数据库领域与查询复杂度层次,以维持基准的全面性;以及如何在有限的464个样本规模下,平衡难度分布与统计显著性,从而为模型评估提供可靠的挑战性测试集。
常用场景
经典使用场景
在自然语言处理与数据库交叉研究领域,Spider数据集作为跨领域文本到SQL任务的标杆,一直推动着语义解析技术的发展。而Spider_filtered_challenging作为其精选子集,剔除了简单样例,汇聚了464条高质量且极具挑战性的查询—问题对。这些样本要求模型精准理解复杂自然语言问句,并将其映射为结构化的SQL查询语句,尤其考验模型在多样化数据库模式下的泛化能力与模式链接能力。研究者常利用该子集检验模型在应对多表关联、嵌套子查询、集合操作等复杂SQL句式时的表现,从而更严苛地评估语义解析系统的鲁棒性。
实际应用
在实际应用中,Spider_filtered_challenging成为检验文本到SQL系统部署前鲁棒性的关键试金石。企业级自然语言查询接口(如智能客服数据分析、商业智能报表生成)往往需要处理用户提出的复杂、歧义性强的查询请求。该子集模拟了真实场景中用户对于嵌套条件、多表关联乃至聚合计算的高阶问法,帮助开发者识别模型在处理非标准表述时的潜在漏洞。通过在此子集上的调优,能够显著提升系统对于外延性查询的友好度,降低误生成率,进而赋能非技术用户以自然语言与数据库直接交互,拓展了数据分析民主化的边界。
衍生相关工作
作为Spider生态中的高难度探针,Spider_filtered_challenging衍生了一系列具有影响力的研究工作。例如,Picard等基于Transformer的自回归解析模型在此子集上进行微调,验证了增量式解码策略在硬样本上的有效性;RAT-SQL通过加入关系感知的图注意力机制,借助该子集展示了显式模式建模对于复杂查询的增益。此外,后续的GraPPa与T5-3B等大型预训练模型在评估报告中均将此子集作为核心挑战场景,其性能指标成为衡量模型语义理解深度的标尺。这些工作共同勾勒出从基础编码-解码架构向结构化注意力与预训练对齐方向演进的清晰脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

